
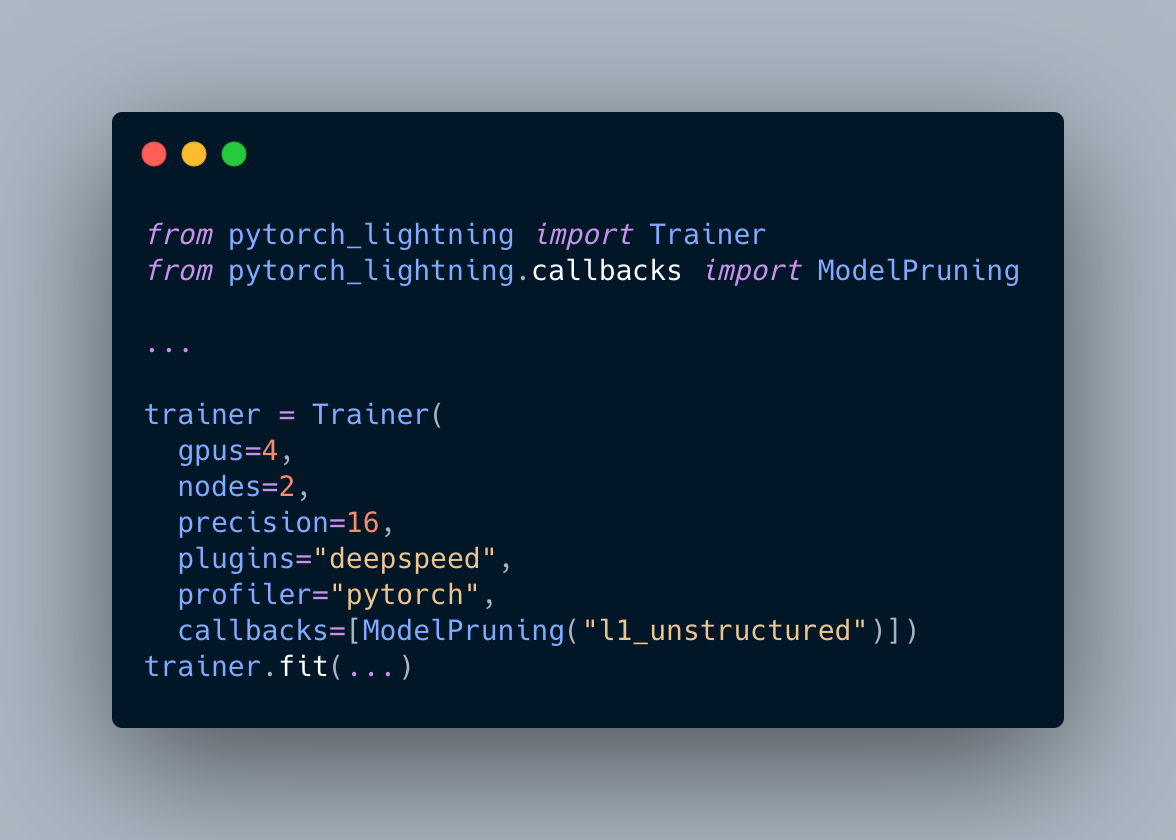
在大模型分布式训练这条赛道上,PyTorch Lightning 和 DeepSpeed 是绕不开的两条技术路径。说真的,这两个框架我都用过,也踩过坑——这篇文章就从配置复杂度、资源效率、易用性三个维度,把它们的优劣掰开揉碎了讲清楚,帮你快速选型。

核心差异速览
| 维度 | PyTorch Lightning | DeepSpeed |
|---|---|---|
| 配置方式 | 声明式(Trainer 参数) | 代码嵌入(ZeRO 阶段) |
| 显存优化 | 插件式 | 原生 ZeRO |
| 多节点扩展 | 需要额外配置 | 内置 NCCL 初始化 |
| 学习曲线 | 低 | 中高 |
| 维护团队 | Lightning AI | Microsoft |
| 生态成熟度 | 高 | 中 |
| 2026 年定位 | 中小规模训练主流 | 70B+ 大模型刚需 |
一、为什么要把这两个框架放在一起对比?
模型参数量从 billions 一路卷到 trillions,单机训练早就扛不住了。PyTorch Lightning 和 DeepSpeed 分别代表了两种完全不同的优化思路:
- PyTorch Lightning:通过高级抽象简化训练流程,让开发者专注模型本身
- DeepSpeed:通过显存优化技术,让更大规模的模型在有限硬件上跑起来
根据 Hugging Face 公开社区调研,DeepSpeed 在超大规模模型训练场景中保持着稳固的市占率,而 PyTorch Lightning 在中小规模实验和学界研究中覆盖率更高。说白了,一个走”易用性”路线,一个走”极限优化”路线,这两个流派都有大量忠实在用。
二、配置复杂度对比
2.1 PyTorch Lightning:声明式 API,写起来是真香
PyTorch Lightning 把核心配置集中在 Trainer 对象里,5 行代码就能启动分布式训练:
from pytorch_lightning import Trainer

trainer = Trainer(
    devices=8,
    strategy="ddp",
    precision=16,
    accumulate_grad_batches=4,
)
trainer.fit(model, datamodule)
优势:
- 代码量少,5 行配置即可启动分布式训练
- 自动处理设备管理、梯度同步、模型检查点等细节
- 支持 YAML 配置文件,方便环境迁移
劣势:
- 高级功能需要阅读大量文档
- 自定义训练循环时灵活性受限
2.2 DeepSpeed:字典配置,粒度细但学习曲线陡
DeepSpeed 通过 deepspeed_config 字典控制行为:
from deepspeed import DeepSpeedConfig

ds_config = {
    "train_batch_size": 32,
    "gradient_accumulation_steps": 4,
    "fp16": {"enabled": True},
    "zero_optimization": {
        "stage": 3,
        "offload_optimizer": {"device": "cpu"}
    }
model, optimizer = deepspeed.initialize(model=model, config_params=ds_config)
优势:
- 配置粒度极细,可针对具体硬件调优
- ZeRO 优化技术业界领先
- 与 Hugging Face Transformers 无缝集成
劣势:
- 学习曲线陡峭
- 配置文件复杂,新手容易出错
- 调试困难,错误信息不够直观
三、显存效率对比
3.1 DeepSpeed ZeRO 详解
ZeRO(Zero Redundancy Optimizer)是 DeepSpeed 的招牌技术,通过分片大幅降低显存占用:
| ZeRO Stage | 显存节省 | 通信开销 | 适用场景 |
|---|---|---|---|
| Stage 1 | 约 4x | 低 | 优化器状态分片 |
| Stage 2 | 约 8x | 中 | 梯度+优化器分片 |
| Stage 3 | 约 16x | 高 | 全状态分片 |
典型测试场景(基于 RTX 4090 × 8 集群、70B 参数量级模型、bf16 精度、序列长度 2048 左右的公开社区测试):
- 无优化:单卡显存完全无法加载模型
- DeepSpeed Stage 2:可训练,每卡显存占用约 18GB 量级
- DeepSpeed Stage 3:可训练,每卡显存占用约 10GB 量级
注:以上为公开社区测试的典型值,实际占用随 batch size、序列长度、模型结构变化有明显波动,上线前建议先在自己硬件上跑一遍 smoke test 做精确测算。
3.2 PyTorch Lightning 的显存优化
PyTorch Lightning 通过 Trainer(precision=16, accumulate_grad_batches=N) 可降低显存,但底层仍依赖原生 DDP,显存效率通常略低于 DeepSpeed Stage 3。
trainer = Trainer(
    devices=8,
    strategy="deepspeed_stage_2",  # 原生支持 DeepSpeed
    precision="bf16",
    gradient_clip_val=1.0
)
注意:Lightning 在 2024 年后已原生集成 DeepSpeed 策略,无需再像早期版本那样手动包装。
四、多节点扩展对比
4.1 DeepSpeed 多节点
DeepSpeed 内置 NCCL 初始化,多节点配置相对简单:
# 启动命令
deepspeed --num_gpus=8 --num_nodes=2 train.py
环境变量设置:
export NCCL_DEBUG=INFO
export NCCL_IB_DISABLE=0
4.2 PyTorch Lightning 多节点
Lightning 需要额外配置 SLURM 或 Kubernetes:
trainer = Trainer(
    num_nodes=2,
    devices=8,
    strategy="ddp",
    cluster_environment=SLURMEnvironment()
)
五、性能基准:吞吐量与通信开销
光看显存还不够,资源效率维度还应该看训练速度。这一节补一下吞吐量和通信开销的对比。
5.1 单机吞吐对比
在相同的硬件配置下(参考 8 卡 A100 80G + 70B 模型 + bf16 的公开 benchmark):
- PyTorch Lightning + FSDP:单卡吞吐通常可达 DeepSpeed Stage 3 的 80%–90% 区间,前提是启用了
torch.compile - DeepSpeed Stage 3:吞吐一般领先,但需要精细调参才能跑满
5.2 多节点通信开销
| 方案 | 通信开销 | 适用规模 |
|---|---|---|
| Lightning DDP | 中等 | 中小规模多机 |
| Lightning + FSDP | 中高 | 中大规模 |
| DeepSpeed Stage 3 | 中高(带 ZeRO-Hooks 优化) | 大规模多机 |
提示:截至 2026 年 08 月,PyTorch 2.x 系列对
torch.compile+ FSDP 的融合优化已经比较成熟,开启后能让 Lightning 这边追近 DeepSpeed 的吞吐。
5.3 第三方案:Hugging Face Accelerate
老实讲,2025–2026 年还有一个常被忽略的选项——Hugging Face Accelerate。它在易用性上接近 Lightning,又能调用 DeepSpeed 或 FSDP 后端。如果你的代码已经基于 Transformers,写法最丝滑,是中小规模场景的一个”第三选择”。
六、2026 年选型建议(含团队与运维维度)
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 快速原型验证 | PyTorch Lightning | 配置简单,上手快 |
| 10B 以下模型 | PyTorch Lightning | 够用,生态成熟 |
| 10B–70B 模型 | DeepSpeed Stage 2 | 显存优化效果好 |
| 70B+ 模型 | DeepSpeed Stage 3 | 极致显存优化 |
| 多团队协作 | PyTorch Lightning | 代码可读性好 |
| 追求极致性能 | DeepSpeed | 调优空间大 |
| 小团队 / 运维能力弱 | PyTorch Lightning | 出问题好排查 |
| 大团队 / 有专属 Infra | DeepSpeed 或 Accelerate | 调优空间大 |
| 多模态训练(图文/视频) | DeepSpeed + Flash-Attn | 显存压力更大 |
| RLHF / 后训练 | DeepSpeed Stage 3 + HF TRL | 显存几乎吃满 |
七、热门场景实测建议(2026 年视角)
7.1 多模态大模型训练
多模态训练普遍要走”视觉编码器 + LLM + 连接器”三件套架构,激活显存压力比纯文本模型大很多。建议直接上 DeepSpeed Stage 3 + CPU Offload,Lightning 在这个规模上已经有点吃力,只能作为外层封装。
7.2 RLHF / 后训练
RLHF 阶段需要同时加载 Actor、Critic、Reward、Reference 四个模型,显存压力直接 ×4。这种场景下 ZeRO Stage 3 + offload 几乎是唯一可行的方案,PyTorch Lightning 通常作为外层调度框架。
7.3 长上下文(128K+)
超过 128K 序列长度的训练,光靠显存优化已经不够,必须配合 Flash Attention、Ring Attention 这类注意力优化。DeepSpeed 在这块有内置集成,Lightning 需要手动接入。
7.4 torch.compile + 分布式
2026 年的趋势之一是 torch.compile 与分布式训练的深度融合。在 PyTorch 2.x 上,把 torch.compile 和 FSDP/DeepSpeed 一起用,能拿到 10%–30% 不等的额外吞吐提升,调试成本也不算高,老实讲是真的能拿捏性能。
八、组合用法:Lightning 封装 DeepSpeed
PyTorch Lightning 和 DeepSpeed 并不是互斥关系,实际上可以结合使用——用 Lightning 的高级 API 封装 DeepSpeed 的优化能力。这种”皮 + 核”的组合在 2026 年的工业界相当流行:
trainer = Trainer(
    strategy="deepspeed_stage_3_offload",
    precision="bf16",
    devices=8,
    num_nodes=4
)
这样做的好处是:既能享受 Lightning 优雅的 Trainer 抽象,又能拿到 DeepSpeed 的 ZeRO-3 显存优化。这是 2026 年大模型训练团队的常见实操姿势,对工程师有直接参考价值。
九、常见问题 FAQ
Q1:我是初学者,应该先学哪个?
A:先 Lightning。它的反馈循环更短,文档更友好,能让你专注在模型设计本身。等你开始碰 10B 以上模型,再回头补 DeepSpeed。
Q2:ZeRO Stage 越高越好吗?
A:不是。Stage 越高通信开销越大,实测 Stage 3 的吞吐往往比 Stage 2 低 10%–20%(具体依赖网络拓扑)。能跑就尽量用低 Stage。
Q3:FSDP 和 ZeRO-3 到底选哪个?
A:两者原理类似,但 FSDP 是 PyTorch 原生的,集成度更好;ZeRO-3 在 offload 上功能更强。如果不打算用 CPU offload,FSDP 是个更省心的选择。
Q4:DeepSpeed 是不是停止维护了?
A:不是。Microsoft 仍在持续更新,2025–2026 年还推出了与 PyTorch 原生 backend 兼容的改进。但社区讨论度上确实不如前几年那么热。
Q5:Hugging Face Accelerate 能取代 DeepSpeed 吗?
A:在很多中小规模场景可以,但在超大模型 + 复杂 offload 场景下,DeepSpeed 的可调参数更细,依然有优势。两者并非替代关系。
Q6:要不要直接上 TorchTitan?
A:TorchTitan 是 Meta 在 2024–2025 年推出的原生 PyTorch 分布式训练栈,思路很前沿,但目前生态还在演进。生产环境建议 Lightning + DeepSpeed 这种成熟组合,研究/前沿尝试可以关注 TorchTitan。
十、总结
说到底,PyTorch Lightning 和 DeepSpeed 是互补关系,不是替代关系:
- 小规模快速迭代 → Lightning
- 大规模极限优化 → DeepSpeed
- 想要两者兼得 → Lightning 套 DeepSpeed
选型的核心不是问”哪个更好”,而是问”我的模型规模、团队能力、运维资源,分别适合哪个”。把这三点想清楚,答案自然就出来了。
本文基于 2026 年 08 月市场情况与公开技术文档整理。