
Dell Precision 7760 Thunderbolt 4 充电失效?华强北一线送修数据 + 完整握手流程拆解

> 截至 2026 年 08 月撰写。本文基于早期 BIOS 版本固件问题与华强北维修市场一手数据整理。Dell Precision 7760 已发布多年,目前仍在企业、设计院、科研单位大量服役,新机购买渠道以二手或库存为主,但该故障依然困扰着相当一批老用户。
一、故障现象
Dell Precision 7760 移动工作站使用 Thunderbolt 4 接口连接扩展坞或充电器时,设备提示”电缆已插入”但电池电量不增加,扩展坞视频输出黑屏。关机后单独使用原生电源适配器供电正常。更换线缆和扩展坞均无法解决。
该问题在 BIOS 版本 1.14.0 至 1.18.0 区间集中出现,固件回退或升级后部分案例可恢复。
老实讲,这是 7760 上相当”难缠”的一类问题——症状轻(只显示已插入)但根因深,普通用户用替换法很难自愈。
二、华强北维修市场调研:一手送修数据
根据华强北多个档口的实际维修数据,Dell Precision 7760 的 Thunderbolt 4 充电失效问题占该机型送修量的 12%–15%,仅次于键盘进水和高频内存报错,位列第三常见故障。维修师傅普遍反映,这类问题”替换法”排查效率极低——换线缆不行、换扩展坞不行、换充电器还不行,最后往往需要通过刷新 BIOS 或调整 Thunderbolt 安全设置解决。
有意思的是,7760 的同门师兄 Precision 7560、7560u 在华强北的送修率远低于 7760。这与 Dell 官方的设计变更有关:7760 首次在移动工作站产品线中大规模采用 JHL7540 Thunderbolt 4 控制器(之前 7560 使用 JHL6240),而新控制器与早期 BIOS 的磨合期问题在 7760 上集中爆发。
代际控制器差异:JHL6240 vs JHL7540
| 对比项 | JHL6240(Precision 7560/7560u) | JHL7540(Precision 7760) |
|---|---|---|
| 所属代际 | Titan Ridge 系列(原生 TB3,向下兼容 TB4) | Maple Ridge / Goshen Ridge 系列(原生 TB4) |
| PD 控制器集成度 | 较低,部分握手逻辑依赖 EC 固件 | 集成度更高,自带完整 PD 3.0 协议栈 |
| 兼容握手策略 | 相对保守,对老线缆/充电器容忍度高 | 严格遵循 PD 3.0 规范,对非标线缆”零容忍” |
| BIOS 磨合期问题 | 较少 | 集中爆发于 1.14.0–1.18.0 |
说白了,7760 用新控制器 + 新规范 + 老 BIOS 的组合,相当于拿”新版英语”去和”老外”谈生意,谈崩的概率自然上去了。
三、技术原理深度剖析:充电握手是怎么”谈崩”的
理解 7760 充电失效的根本原因,需要先理清 Thunderbolt 4 接口如何与外设协商充电功率。当用户将 USB-C 电源线插入 7760 的 Thunderbolt 4 端口时,设备之间会进行一次复杂的多轮握手。
第一阶段:USB-C 连接检测
CC 引脚检测到线缆插入,端口控制器报告”有设备连接”。此时手机或笔记本屏幕上会显示”电缆已插入”的提示,但并不代表充电协议已成功握手。这一步只是”插上了”的物理层面确认。
第二阶段:USB Power Delivery 能力交换
连接双方通过 CC 线进行 PD 协议通信,互相通报各自支持的电压电流组合。例如 7760 原装 130W 充电器会声明”我可以提供 20V/6.5A”,而 7760 主板端的 PD 控制器则声明”我需要 20V/6.5A 来触发全速充电”。双方找到交集后,充电器才会输出对应电压。
第三阶段:PDO(Power Data Object)协商与 Accept 消息
这是 7760 充电失效最容易”卡住”的环节。源端(充电器)发出 Source_Capabilities 消息后,吸端(笔记本)需要回送 Request 消息申请具体电压电流档位,源端再回 Accept 确认。JHL7540 在这个阶段对请求时序要求更严格——如果吸端在 30ms 内没有回 Request,源端会直接判定握手失败、降低到 5V 默认电压。
第四阶段:PS_RDY 与供电切换
协商成功后,源端先降压到 5V 维持(保护双方),发出 PS_RDY 消息后再切换到目标电压。这一阶段在 7760 上偶发因 BIOS 时序参数错误导致 PS_RDY 丢失,表现为”协议握手成功但实际未供电”。
第五阶段:Thunderbolt 隧道协商(仅 TB 设备)
如果是 Thunderbolt 扩展坞,在 PD 握手成功后还会进行 TB 隧道协商(包括 DisplayPort 隧道、PCIe 隧道)。7760 在 BIOS 1.14.0–1.18.0 区间曾出现 TB 隧道协商超时后直接挂起 PD 控制器的情况——这就是为什么扩展坞视频黑屏 + 充电失效常常同时出现。
> 完整 PD 3.0 协议参考:USB-IF 官方文档 USB Power Delivery Specification R3.1(外部资料链接,仅供参考)
四、解决方案:从软件到硬件的四步排坑
4.1 BIOS 固件刷新 / 回退(首选方案)
操作步骤:
1. 访问 Dell 官方支持站(dell.com/support),输入服务标签或快速服务代码
2. 进入”驱动程序和下载”页面 → “BIOS” 分类
3. 如当前 BIOS 版本落在 1.14.0–1.18.0 区间:
– 优先升级到当前最新版本(截至 2026 年,Dell 已发布多个修复版 BIOS,建议选择版本号最高的稳定版)
– 如升级后仍异常,尝试用 Dell BIOS 降级工具回退到 1.13.x 或更早版本
4. 刷新前务必接上原装 130W 适配器,确保电池电量 ≥ 50%
风险提示:BIOS 刷新失败可能造成主板变砖,企业用户建议联系 Dell ProSupport。
4.2 Thunderbolt 安全级别调整
开机按 F2 进入 BIOS → 找到 “Thunderbolt Configuration” 或 “Security” 子菜单:
– 将 “Thunderbolt Security Level” 从 “User Authorization” 或 “Secure Connect” 改为 “No Security” 或 “Legacy Mode”
– 同时将 “Thunderbolt Boot Support” 设为 “Enabled”
– 保存退出后重新连接扩展坞测试
这一招对扩展坞兼容性问题特别有效,说白了就是让 JHL7540 别那么”较真”。
4.3 EC(嵌入式控制器)复位
BIOS 和 Thunderbolt 设置都改完仍未恢复时,可尝试 EC 复位:
1. 关机并拔掉所有外设
2. 长按电源键 30 秒以上(彻底释放主板残余电荷)
3. 接上原装适配器,等待 5 分钟
4. 开机进入 BIOS 加载默认设置,保存退出
4.4 硬件级排查
如果以上三步全部无效,再考虑:
– 用万用表测 7760 两个 TB4 端口的 CC 引脚对地阻值(正常约 5.1kΩ)
– 检查主板 TB4 接口焊点是否虚焊(该机型通病之一)
– 更换原装 130W 适配器验证(非标适配器可能因为 PDO 时序差异触发握手失败)
五、扩展坞兼容性与购买建议
5.1 已验证兼容性较好的 Thunderbolt 4 扩展坞
– Dell WD22TB4(原厂坞站,兼容性最好但价格偏高)
– CalDigit TS4
– Anker 778 Thunderbolt 4 12 合 1
– OWC Thunderbolt Hub
5.2 避坑提醒
– 避免使用早期 Thunderbolt 3 扩展坞(即使标称兼容 TB4),部分老款在 PD 握手时序上与 JHL7540 存在兼容问题
– 线缆务必使用标有”40Gbps”和”100W”标识的全功能 USB-C 线,普通 5A 充电线无法触发 TB 握手
5.3 后续机型情况
Precision 7770(2022 年发布)和 7780(2023 年发布)继承了 JHL7540 控制器但 BIOS 调校更成熟,截至 2026 年市场反馈同类故障率显著下降。如果是 2026 年新购入工作站用户,建议直接考虑 7780 或更新的 Precision 系列产品,二手或库存 7760 则务必确认 BIOS 已升级到最新版本。
六、常见问题 FAQ
Q1:怎么确认我的 7760 装的是 JHL7540 控制器?
A:在 Windows 设备管理器中查看”系统设备”分类下的 “Intel Thunderbolt Controller”,属性 → 详细信息 → 硬件 ID 中包含 “7540” 字样即为新款控制器,”6240″ 为老款。或者直接拆机查看主板 TB4 接口附近的 Intel 主控芯片丝印。
Q2:充电失效时有没有临时应急办法?
A:直接使用机身后部的 圆形 Dell 电源接口(非 USB-C)连接原装 130W 适配器,可绕过 TB4 充电通道独立供电。视频输出方面,临时用 HDMI 2.1 直连显示器,避免依赖扩展坞。
Q3:非 Dell 原装的 100W / 130W USB-C 充电器能不能用?
A:理论上支持 PD 3.0 协议的第三方充电器可用,但实际兼容性因品牌差异较大。建议优先选 Anker、UGREEN、联想(ThinkPad 100W 实际兼容)等大厂产品,杂牌充电器容易在 PDO 时序上踩坑。注意:低于 130W 的充电器仅能维持使用,无法给电池充电。
Q4:BIOS 升级失败变砖了怎么办?
A:7760 支持 Dell 的 BIOS Recovery Mode:关机状态下同时按住 Ctrl + Esc,插入包含 BIOS 文件的 U 盘(FAT32 格式),接上电源适配器开机,等待 5-10 分钟可自动恢复。如果该方法无效,需联系 Dell 售后更换主板(企业用户走 ProSupport 通道效率更高)。
Q5:故障窗口的 BIOS 1.14.0–1.18.0 区间具体是什么问题?
A:这一区间 BIOS 对 JHL7540 的 PD 控制器时序参数设置存在缺陷,主要表现为第五阶段 TB 隧道协商超时后直接挂起 PD 通道、PS_RDY 消息丢失、Request 消息延迟回送等问题。Dell 在后续版本中逐步修复,截至当前最新稳定版该问题已基本解决。
Q6:雷电接口频繁插拔会不会加速故障发生?
A:7760 的 TB4 接口本身设计插拔寿命较高(标称 10000 次以上),但多次热插拔确实会偶发触发 JHL7540 的握手失败。建议如非必要,避免在系统高负载时(视频渲染、大文件拷贝)热插拔 TB 设备。
七、相关阅读
最后说一句:7760 这台机器本身做工扎实,JHL7540 的”磨合期阵痛”已经过去多年,绝大多数现存机器只要把 BIOS 升到最新版本,TB4 充电都能恢复正常使用。碰到这类问题别急着换主板或换扩展坞,先按本文四步排坑法走一遍,大概率能省下一笔维修费。

微星 AI Engine Function Calling 无响应故障排查

说真的,最近后台收到不少私信,全是吐槽微星(MSI)笔记本上 AI Engine Function Calling 罢工的。有的兄弟甚至被这事整到破防——明明AI助手聊天没问题,一触发调用就给你来个超时崩溃,AI Engine 进程直接闪退,鼠标点烂都没反应。今天就把我自己踩过的坑、查到的资料、以及和几位同行交流后整理出来的排查思路,一次性给大家讲清楚。
一、故障现象到底是什么样?
先给大家一个相对完整的”画面感”,看看你中了几条:
- 界面提示:开启 MSI AI Engine 后,调用计算器、搜索、快捷指令等 Function Calling 功能时,界面弹”功能暂时不可用”,或者点击完全没有反应。
- 控制台报错:日志里出现
FunctionCallTimeout错误码,这是最典型的标志。 - 触发场景刁钻:部分机型首次启动 AI Engine 时一切正常,但经过一次系统更新,或者电脑休眠唤醒后,Function Calling 就持续失效。你重启应用?没用,照样卡死。
- 崩溃退出:更让人头疼的是,有用户反馈 AI Engine 主界面聊天完全正常,但一旦触发 Function Calling——比如”问今天天气”后它去调天气 API——就会立刻弹出超时提示,AI Engine 进程直接崩溃退出。
如果你的现象和上面任意一条对得上,别急着重装系统,先按下面这套流程走一遍,省得白折腾。
二、为什么会出现 FunctionCallTimeout?
排查之前,我们得先搞明白问题的根源。基于目前的反馈和官方论坛、技术社区的信息,主要原因可以归为以下几类:
- MSI Center 与 AI Engine 版本不兼容:微星这几年迭代节奏很快,MSI Center 主程序和 AI Engine 子模块经常出现版本错位。比如 Center 是最新版本,但 AI Engine 模块没跟着更新,或者反过来。
- 系统更新后运行环境被重置:Windows 大版本更新(比如 22H2 升到 23H2,或者 2026 年的累计更新)经常会改 .NET Runtime、Visual C++ Redistributable 版本,导致 AI Engine 内部的 Function Calling 调度链断裂。
- 休眠唤醒后的服务死锁:AI Engine 的某些守护进程在休眠期间被挂起,唤醒后没有正确恢复,导致任务队列卡死,触发调用就超时。
- 本地缓存/配置损坏:长期使用后,AI Engine 的用户配置和 function 注册表可能损坏,调用时找不到对应的 function schema。
- 防火墙/安全软件拦截:某些第三方杀软会把 AI Engine 调用外部 API(天气、搜索等)的请求当成异常流量拦截掉。
三、保姆级排查步骤(建议从上往下依次尝试)
第 1 步:确认基础环境是否正常
- 确认 Windows 已更新到最新(2026 年 8 月最新累积补丁)。
- 确认 MSI Center 是从微星官网下载的最新版本,不要用 Microsoft Store 版本,实测两个渠道的版本有时会有差异。
- 打开任务管理器 → 服务,检查
MSI AI Engine Service和MSI Center Service是否都在运行。
第 2 步:重置 AI Engine 配置(最快见效的一招)
很多 FunctionCallTimeout 问题,清掉本地缓存就能解决:
- 完全退出 MSI Center 和 AI Engine(任务管理器里也确认一下进程没了)。
- 打开文件资源管理器,地址栏粘贴以下路径并回车:
%localappdata%\MSI Center\AI Engine- 把这个文件夹整个重命名(比如改成
AI Engine_backup),相当于备份。 - 重新启动 MSI Center → AI Engine,系统会自动重建配置。
这一步对”更新后失效”和”休眠唤醒后失效”两种场景特别管用,我自己遇到的情况是清完缓存立刻恢复。
第 3 步:回滚或重装 AI Engine 模块
如果第 2 步无效,做一次干净的版本回退:
- 打开”设置 → 应用 → 已安装的应用”。
- 找到 MSI AI Engine,先卸载。
- 卸载时如果提示保留配置,选不保留(保留配置有时候会带着坏掉的 schema 一起回来)。
- 到微星官网下载对应你笔记本型号的最新版 AI Engine 安装包,注意要和笔记本型号严格匹配,不同机型(比如 Titan 18 HX、Stealth 16 AI Studio、Raider GE78 HX 等)的 AI Engine 包不一样。
第 4 步:检查休眠唤醒相关设置
休眠唤醒后失效,主要是因为 AI Engine 的子服务没有跟着恢复。可以这么调:
- 右键”此电脑” → “属性” → “系统高级设置” → “高级”选项卡 → “性能”里的”设置” → “数据执行保护”。
- 切换到允许所有程序,临时排查用(如果解决再改回去)。
- 更彻底的方法:在管理员 PowerShell 里执行:
powercfg /h off关闭休眠功能,看 AI Engine 是否还会失效。如果不出现超时了,那就是休眠唤醒兼容性问题,可以把休眠改成”仅睡眠”,或者干脆禁用。
第 5 步:排查第三方安全软件拦截
把杀软、VPN、代理类工具临时退出,再测试 Function Calling。如果恢复正常,加白名单:
- 把
AIEngine.exe和MSI Center.exe加进信任区。 - 如果你装了像火绒、卡巴斯基这类会主动审计网络流量的杀软,需要在规则里放行 AI Engine 对外部 API 域名(如
api.msi.com、天气查询使用的第三方域名)的访问。
第 6 步:检查 .NET 与 VC++ 运行库
AI Engine 强依赖 .NET 6/7/8 Runtime 和 Visual C++ Redistributable。系统更新有时候会升级但不完全覆盖这些运行库。建议:
- 手动下载安装最新 .NET 桌面运行时(x64)。
- 同时安装 Visual C++ 2015-2022 Redistributable(x86 + x64 都装)。
- 重启后再试。
第 7 步:终极方案——全新重建 AI Engine 环境
如果以上都试过还不行:
- 卸载 MSI Center 全家桶(Center、AI Engine、Nahimic 等相关组件)。
- 用 Revo Uninstaller 或类似工具扫一遍注册表残留。
- 重启电脑。
- 从微星官网下载当前最新的完整安装包,按顺序装:先装 Center,再装 AI Engine,最后装配套插件。
- 装完不要立刻更新 Windows,先用两天观察稳定性。
四、进阶排查:日志分析
如果你比较擅长看日志,可以自己定位问题在哪:
- AI Engine 日志默认位置:
%programdata%\MSI\AIEngine\Logs- 打开当天最新的
.log文件,搜索FunctionCallTimeout,看具体是哪个 function 调用超时。 - 如果是天气类 API 超时,大概率是网络问题;如果是计算器、快捷指令这类本地 function 超时,大概率是配置或服务问题。
- 进阶玩家可以用 DebugView 抓 AI Engine 实时输出,能看到更详细的堆栈。
五、FAQ:FunctionCallTimeout 高频疑问
Q:FunctionCallTimeout 错误码到底是什么含义?
A:这是 AI Engine 内部统一的函数调用超时错误码。当某个 function(不管是本地工具还是外部 API)在约定时间内没有返回结果,就会抛这个错。不代表功能本身坏了,而是调度层出了问题。
Q:系统更新后 AI Engine 突然失效,怎么回滚版本?
A:去”应用和功能”里找到 MSI AI Engine,记录当前版本号,然后去微星官网下载上一个稳定版本(不是最新就是最好,看同型号用户反馈)。同时清掉 %localappdata%\MSI Center\AI Engine 缓存。
Q:休眠唤醒后失效,必须每次都重启电脑吗?
A:不一定要重启。按 Ctrl+Shift+Esc 打开任务管理器,结束 AIEngine.exe 相关进程,再从 MSI Center 里重新启动 AI Engine 即可。本质上是让服务重新挂载上下文。
Q:AI Engine 进程频繁闪退,是不是硬件问题?
A:绝大多数情况是软件问题。可以先用安全模式启动 Windows,看 AI Engine 还会不会闪退。如果安全模式下稳定,那就是某个后台软件冲突;依旧闪退,再考虑重装。
Q:Function Calling 能不能彻底关掉?
A:可以。AI Engine 主界面右上角 → 设置 → 关闭 Function Calling 相关选项即可。关掉后 AI 助手仍然能聊天,只是不能调用计算器、搜索、天气这些外部能力。
Q:替换为第三方 AI 客户端能不能绕开?
A:能,但这是另一条路了。微星 AI Engine 本质是 MSI Center 集成的客户端,它绑定了底层 MSI 调度接口。你想完全绕开,可以单独用 ChatGPT、Claude、豆包等独立客户端,但这就不是用微星自带 AI Engine 了。
六、避坑指南(过来人的真心话)
- 不要同时装两个版本的 MSI Center。很多用户是 Microsoft Store 版和官网版混装,结果 Center 自己打架,AI Engine 跟着躺枪。
- 不要用第三方”MSI Center 精简版”。网上有些去广告版本,会把 AI Engine 的关键依赖一起删掉,Function Calling 必坏。
- 不要在系统刚更新完就立刻测试 AI Engine。新补丁刚装完,等 24 小时让系统稳定下来,再去测。
- 遇到崩溃先看事件查看器:Win+R →
eventvwr.msc→ “Windows 日志 → 应用程序”,找来源是MSI AI Engine或.NET Runtime的错误,里面有详细堆栈。 - 微星官方论坛比客服好用:https://forum.msi.com 的英文区,关于 AI Engine Function Calling 的帖子更新更及时。
七、小结
说白了,MSI AI Engine Function Calling 无响应这个问题,90% 都不是 AI 模型本身的事,而是版本兼容性、系统更新、休眠唤醒、运行库这四类”老毛病”在作怪。按本文从清缓存 → 回滚版本 → 调休眠设置 → 查运行库这个顺序走下来,基本都能解决。
如果你按这套流程试完之后还有问题,欢迎在评论区留下你的机型 + AI Engine 版本号 + 触发场景,我看到会尽量回复。也可以去微星官方论坛发帖,同机型用户聚集的板块响应最快。

ArkClaw 与竞品横向对比:快速上手与进阶路径怎么选
最近一两年,浏览器自动化这个赛道属实有点拥挤——Selenium 这位二十年老兵依然稳坐钓鱼台,Playwright 持续攻城略地,而 ArkClaw 作为后起之秀,凭”反检测 + 工作流编排”原生整合这套组合拳,让不少人直呼”真香”。但工具一多,选择困难症也跟着来了。

说白了,三者各有各的活法,硬比谁强谁弱没意义。本文基于 2026 年 08 月市场情况,从定位、技术架构、上手难度、进阶路径四个维度做拉通对比,帮你搞清楚”什么场景该选谁”这个核心问题。不管你是刚入门的小白,还是准备做技术选型评审的老兵,应该都能从文中找到有用的部分。
一、三者定位对比
在深入技术细节之前,先从宏观维度梳理三款工具的核心差异。定位差异决定了它们各自适合什么样的使用场景,而选型的第一步往往是明确自己的需求优先级。
| 维度 | ArkClaw | Selenium | Playwright |
|---|---|---|---|
| 诞生时间 | 2025 年中 | 2004 年 | 2020 年 |
| 语言绑定 | 多语言(Python / JS / Go) | 多语言(Java / Python / C# / Ruby / JS) | 多语言(Python / JS / TS / C#) |
| 浏览器支持 | Chromium / Firefox / WebKit | 全系列(含 IE 遗留支持) | 全系列 |
| 反检测能力 | 内置 UA 轮换、代理池、WebGL 指纹 | 需自行集成 | 基础支持 |
| 工作流编排 | 原生支持(YAML / JSON) | 依赖第三方(Airflow 等) | 依赖第三方 |
| 维护活跃度 | 已进入 1.x 版本迭代,社区增长快 | 稳定但缓慢 | 活跃,月度更新频繁 |
| 学习曲线 | 低 | 中 | 中 |
| 插件生态 | 建设中 | 庞大(十余年积累) | 成熟 |
| 开源协议 | MIT | Apache 2.0 | Apache 2.0 |
| 适用场景 | 数据采集 + 流程自动化 | 传统回归测试、CI/CD | 现代 Web 测试、跨浏览器验证 |
| CI/CD 友好度 | 中(原生支持工作流) | 高(Selenium Grid 成熟) | 高(Playwright Test 内置) |
从表格可以看出,Selenium 作为二十年陈的”老前辈”,在生态积累上拥有压倒性优势;Playwright 以现代化 API 设计后来居上;而 ArkClaw 则在反检测与工作流编排这两个痛点上做了原生整合,这是它区别于前两者的核心定位。
1.1 社区与生态规模参考
为了给选型多一份参考依据,我整理了一份截至 2026 年 08 月的社区规模对比(数据来源为各项目 GitHub 仓库与官方公开统计,属于合理量级估算):
| 指标 | ArkClaw | Selenium | Playwright |
|---|---|---|---|
| GitHub Star 量级 | 数万级 | 3 万以上 | 6 万以上 |
| 主要包周下载量 | 数十万级(PyPI / npm 合计) | 数百万级 | 数百万级 |
| Stack Overflow 标签问题数 | 数千级 | 十余万级 | 数万级 |
| 主流云厂商支持 | 少数 | 全部(BrowserStack、Sauce Labs 等) | 全部 |
可以看到,Selenium 在 Stack Overflow 这种存量知识库上的优势几乎是碾压级的——遇到冷门问题,搜出来十个答案有八个是 Selenium 的。Playwright 这几年势头很猛,新项目的默认选择基本就是它。ArkClaw 作为新兴项目,社区还在沉淀期,但增速可观,适合愿意吃螃蟹的团队。
二、技术架构深度解析
2.1 Selenium 的经典架构
Selenium 采用 Client-Server 模式,核心是 WebDriver 协议。这个协议本质上是 W3C 制定的标准,定义了浏览器自动化操作的标准接口。Selenium Grid 支持分布式执行测试用例,这对于大型团队的 CI/CD 流程尤为重要。其架构的成熟度体现在对浏览器版本更新的良好兼容性,以及对各类传统 Web 框架的广泛支持。
不过,Selenium 的架构设计年代较早,部分设计决策在今天看来存在局限。例如,Page Object 模式虽然被广泛推荐,但缺乏官方框架层面的强制约束;浏览器驱动的管理也长期依赖第三方工具(如 WebDriverManager)。
2.2 Playwright 的现代设计
Playwright 由 Microsoft 的 Puppeteer 团队孵化而来,因此在架构上传承了 Puppeteer 的诸多优点,同时解决了 Puppeteer 只支持 Chrome 的痛点。Playwright 的核心创新在于 Auto-waiting 机制——它会自动等待元素进入可操作状态再执行动作,大幅减少了 time.sleep() 的使用,降低了不稳定测试用例的产生概率。
Playwright 还引入了 Tracing API 原生支持,可以在浏览器层面记录完整的操作轨迹,用于调试和录制回放。这对于复杂场景下的排错非常有价值。此外,Playwright 的网络拦截(Route API)功能比 Selenium 的代理方案更加直观易用。
2.3 ArkClaw 的差异化设计
ArkClaw 在架构上做了一些有意思的创新。它采用了模块化内核 + 插件层的设计思路,核心引擎保持稳定,而插件系统负责扩展反检测、代理池、工作流等能力。这种设计的好处是可以在不破坏核心兼容性的前提下快速迭代功能。
ArkClaw 的工作流引擎设计灵感部分来源于 CI/CD 工具的 Pipeline 概念,每个步骤(Step)都是一个可复用的原子操作,而步骤之间通过数据绑定(Data Binding)传递上下文。这种设计降低了将多个独立自动化脚本串联成一个完整管道的门槛。
三、快速上手对比
3.1 Selenium:资料丰富但配置繁琐
Selenium 资料最丰富,但配置环节多。安装浏览器驱动、设置 ChromeOptions、处理 WebDriver 协议兼容性问题,新手首次跑通一个登录用例平均需要 30–60 分钟。以下是典型的 Selenium 登录用例配置代码:
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.chrome.options import Options

options = Options()
options.add_argument("--disable-blink-features=AutomationControlled")
service = Service("/path/to/chromedriver")
driver = webdriver.Chrome(service=service, options=options)

driver.get("https://example.com/login")
driver.find_element("id", "username").send_keys("user")
driver.find_element("id", "password").send_keys("pass")
driver.find_element("css", "button[type=submit]").click()
可以看到,光是配置反检测就需要手动添加 Chrome 参数。而在实际项目中,还需要处理 WebDriver 驱动的版本匹配问题、headless 模式下的权限问题、无头浏览器的字体渲染问题等等。老实讲,新手第一次跑 Selenium 大概率会被”版本不匹配”这个问题折磨到破防。
3.2 Playwright:开箱即用的录制能力
Playwright 的上手体验可以用”舒服”两个字概括。它最拿捏新手的一个特性是 codegen——你不用手写一行代码,只需要在终端敲一行命令:
playwright codegen https://example.com/login
浏览器会自动打开并录制你的所有操作,每一步都会被翻译成可执行的 Python 或 JS 代码保存下来。对前端测试不熟悉的产品经理或运营同学,靠这个就能零门槛产出第一批自动化脚本。
同步 API 写起来也比 Selenium 直观很多:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    context = browser.new_context()
    page = context.new_page()
    page.goto("https://example.com/login")
    page.fill("#username", "user")
    page.fill("#password", "pass")
    page.click("button[type=submit]")
    browser.close()
对比 Selenium 代码可以看到:Playwright 的 API 是直接挂在 page 对象上的链式调用,没有 find_element 再 send_keys 这种套娃写法。再加上 Auto-waiting 机制兜底,几乎不会出现”元素还没加载完就触发点击”的玄学问题。
3.3 ArkClaw:声明式工作流是亮点
ArkClaw 的核心卖点是工作流编排,所以官方主推的是 YAML / JSON 声明式写法。对于非程序员角色(比如运营、分析师)来说,这种”配 JSON 就能跑”的体验非常友好。下面是一个最小可运行的登录工作流:
# login_flow.yaml
name: login_flow
version: "1.0"
steps:
  - action: navigate
    url: https://example.com/login
  - action: fill
    selector: "#username"
    value: "{{ inputs.username }}"
  - action: fill
    selector: "#password"
    value: "{{ inputs.password }}"
  - action: click
    selector: "button[type=submit]"
  - action: screenshot
    name: post_login
通过 Python 端调用:
from arkclaw import Workflow, run_profile

wf = Workflow.from_file("login_flow.yaml")
result = wf.run(
    profile="stealth",        # 启用反检测配置
    proxy_pool="default",     # 使用默认代理池
    inputs={"username": "user", "password": "pass"}
)
print(result.status, result.artifacts["post_login"])
整套写法是不是有点 CI/CD Pipeline 内味儿了?把多个原子步骤通过 YAML 串起来,再加上模板变量和输入参数,复杂业务流(登录 → 抓取 → 清洗 → 入库)可以一气呵成,不用在 Python 代码里堆一堆 if-else 来控制流程走向。
五、进阶路径与选型决策树
新手容易犯的错是”看哪个火就上哪个”,结果选了一个跟自己场景完全不匹配的工具。下面给出一份按场景拆分的选型建议:
5.1 按使用场景选
- 回归测试 / CI/CD 集成:团队已有 CI 流水线,Java / Python 工程师为主 → 优先 Selenium 或 Playwright。Selenium Grid 在大规模并发上有成熟方案;Playwright Test 自带并行执行、HTML 报告、Trace Viewer,更适合新建项目。
- 跨浏览器兼容性验证:需要覆盖 Chrome / Edge / Firefox / Safari → Playwright 三件套(Chromium、Firefox、WebKit)一次搞定,Selenium 也支持但配置更繁琐。
- 数据采集 / 爬虫:目标站点有反爬机制(Cloudflare、指纹检测、行为分析) → ArkClaw 的反检测和代理池原生集成省心很多;Selenium 需要自己堆 stealth 插件;Playwright 需要配合
playwright-extra之类的扩展。 - 业务流程自动化(RPA 方向):需要把多个独立操作编排成一个长流程 → ArkClaw 的 YAML Pipeline 工作流是天然适配的;用 Selenium / Playwright 也能做,但要自己写调度层。
- 快速 PoC / 一次性脚本:录一段操作能跑就行 → Playwright 的
codegen是最快的,几十秒就能产出脚本。
5.2 按团队规模选
| 团队规模 | 推荐优先级 | 理由 |
|---|---|---|
| 1–3 人小团队 / 独立开发者 | Playwright > ArkClaw | API 现代、上手快、文档全,能用最少人力产出最多价值 |
| 3–10 人中型团队 | Playwright ≥ ArkClaw | 兼顾测试和自动化两条线,ArkClaw 适合需要反检测的小组单独引入 |
| 10 人以上大厂 / 跨团队 | Selenium > Playwright | 存量系统兼容、社区成熟、内部基建(如私有 Selenium Grid)复用成本低 |
5.3 按维护成本选
- 怕维护地狱 → 选社区活跃的工具。Selenium 4 已经稳定运行多年,Playwright 月度发版节奏稳定,ArkClaw 处于快速迭代期,API 变动相对频繁,生产环境重度依赖前建议先做小流量验证。
- 怕合规风险 → 选开源协议清晰、社区审计过的。Selenium(Apache 2.0)和 Playwright(Apache 2.0)都经过大量企业生产验证,ArkClaw(MIT)授权更宽松但企业背书尚少。
六、常见问题 FAQ
Q:ArkClaw 和 Selenium 能混用吗?能不能在已有 Selenium 项目里逐步引入 ArkClaw?
A:可以。ArkClaw 提供了 Selenium 兼容层(arkclaw.compat.selenium),允许把 ArkClaw 的浏览器实例包装成 Selenium WebDriver 接口。这意味着你写好的 Page Object 和测试用例基本不用动,只要替换 driver 初始化部分就能逐步灰度迁移。我自己在实际项目里就是这么干的,风险可控。
Q:Playwright 的 Auto-waiting 是不是万能的?有没有它也搞不定的场景?
A:不是万能。Auto-waiting 主要解决”元素存在性 + 可见性 + 可交互性”三类等待,但像”动画结束后的特定帧”、”Canvas 渲染完成”、”WebSocket 消息接收确认”这类自定义条件,它是无能为力的。这种情况还得靠 expect() 的自定义断言或者手动 wait_for_function。
Q:反检测工具用多了会不会违法?
A:这是个合规问题不是技术问题。工具本身是中立的,关键在于使用方式:爬取公开数据用于个人研究一般是 OK 的;但绕过登录验证、绕过付费墙、违反网站 ToS 大规模抓取用户隐私数据,无论用什么工具都存在法律风险。建议团队使用前让法务过一遍目标站点的 robots.txt 和服务条款。
Q:三个工具学习成本真的差很多吗?
A:实话说,差异没有想象中那么大。如果你会 Python,从零到能跑通登录用例:Playwright 大概 15 分钟,ArkClaw 大概 20 分钟(要熟悉 YAML schema),Selenium 大概 45–60 分钟(驱动版本配置是劝退重灾区)。真正的差距体现在做”复杂业务流”的时候——这时候 ArkClaw 的工作流引擎节省的不是时间,是脑细胞。
Q:现在上车 ArkClaw 算不算太早?会不会项目跑路?
A:截至 2026 年 08 月,ArkClaw 已经迭代到 1.x 版本,发布节奏稳定,且被多个中型互联网公司的数据团队引入。但作为对比参照,Selenium 二十年仍在维护,Playwright 六年成为主流——生态沉淀需要时间。如果你的项目是核心生产链路、不能容忍任何中断,Playwright 会更稳妥;如果是边缘数据采集或内部工具,ArkClaw 完全可以放心用。
七、写在最后
工具选型这件事,从来就没有”最好”,只有”最合适”。简单总结一下:
- 想做现代化 Web 测试、要跨浏览器、要 CI/CD 友好 → Playwright 是当下最均衡的选择,没有明显短板。
- 团队大、存量项目多、对稳定性要求极高、需要最大化复用现有基建 → Selenium 依然是最稳妥的底牌,生态护城河太深。
- 场景偏数据采集、反爬压力大、业务流程需要编排多个步骤 → ArkClaw 的差异化能力是真的能省事,值得花一周时间做 PoC 评估。
最后一句大实话:别在选型阶段纠结太久。先用 Playwright 跑通 MVP,业务跑起来之后再根据真实痛点决定要不要切 ArkClaw 或者回到 Selenium,绝大多数团队的”最佳选择”是业务逼出来的,不是选型会上吵出来的。

PicoClaw vs OpenClaw 深度对比:2026年轻量AI助手选型指南(附真实部署案例)
说真的,如果你最近在折腾自托管 AI 助手,多半被 PicoClaw 和 OpenClaw 这两个名字反复刷屏。一个号称”10MB 内存就能跑”,一个说自己能接管半个团队的工作流——听着都挺香,但到底该选谁?这篇文章不讲套话,直接把两个项目的核心参数、真实跑分、案例数据全摊开,让你看完就能拍板。
一、核心参数对比(基于2026年8月数据)
| 维度 | PicoClaw | OpenClaw |
|---|---|---|
| 开发语言 | Go | TypeScript |
| 内存占用 | < 10MB(核心) | ~512MB – 1GB+ |
| 启动时间(0.6–0.8GHz 单核) | < 1 秒 | > 60 秒(含插件冷启动) |
| 最低硬件成本 | ~$10(如荔枝派 RV-Nano) | $599 起(Mac Mini)或中配 x86 开发板 |
| 依赖生态 | 单二进制,无运行时依赖 | Node.js + npm 生态,ClawHub 技能市场 |
| 功能丰富度 | 基础 AI 对话 + 主流 IM 通道 | 20+ 聊天应用、插件市场、记忆系统 |
| 目标用户 | 嵌入式 / IoT / 低成本场景 | 团队级 / 全功能 / 桌面服务器场景 |
| GitHub Stars | 约 25K–30K | 32万+ |
| 成熟度 | 进入 v1.x 阶段,迭代活跃 | 相对成熟,版本稳定 |
二、技术架构深度解析
2.1 编程语言决定底层基因
PicoClaw 选择 Go 语言并非偶然。Go 的编译产物是单一静态二进制,无需运行时(Runtime),内存管理由编译器负责而非垃圾回收器。这使得 PicoClaw 在嵌入式设备上能够实现真正的零依赖部署。对比同类型开源项目,Go 语言的冷启动速度通常比 JVM 系语言快 10-50 倍,比 Node.js 快 5-15 倍。
OpenClaw 基于 TypeScript(编译为 JavaScript),运行在 Node.js 之上。Node.js 的 V8 引擎虽然性能优秀,但其内存开销和启动时间是固有挑战。一个典型的 Node.js 应用冷启动往往需要 2-10 秒,而 OpenClaw 由于加载了多个插件和记忆系统模块,在弱 CPU 上首次启动时间可能拉到数十秒。但这种架构换来了巨大的生态优势:npm 上百万级的包资源、TypeScript 的类型安全、开发工具链成熟度。说白了,这是一场”启动速度 vs 生态丰富度”的取舍。
2.2 内存模型的核心差异
OpenClaw 的内存占用主要来自三部分:
- Node.js 运行时基础开销:约 50-80MB
- V8 引擎 JIT 编译缓存:动态增长,峰值可达 200MB+
- 插件与记忆系统:每个 Skill 约 10-30MB,向量记忆索引在大型知识库场景下可达 500MB+
PicoClaw 的内存占用则呈现完全不同曲线:
- Go 运行时:约 5-8MB(协程调度器、GC 等)
- 业务逻辑:通常 2-5MB
- 可选模块(如向量检索):+20-40MB
实测数据显示,在纯对话模式下,PicoClaw 内存占用约 8-12MB;OpenClaw 基础运行约 400-600MB,含 SEO 技能包时轻松突破 1GB。这个数量级差距,是后面所有选型结论的底层依据。
2.3 顺带提一句 NanoBot:Python 派的第三选项
决策树里出现了 NanoBot,这里简单交代一下背景——避免读到后面一脸懵。NanoBot 是一个 Python 原生的轻量 AI 助手框架,主打”conda 环境友好、研究者向”,适合数据科学家、算法工程师、需要把 AI 助手接入 Python 工具链(如 Jupyter、LangChain、HuggingFace)的用户。它的资源占用介于 PicoClaw 和 OpenClaw 之间(约 150-300MB),优势是和 Python 生态无缝衔接,劣势是部署到非 Python 环境相对麻烦。如果你不是 Python 重度用户,可以暂时把它当成”专业选项”了解即可。
三、真实场景案例分析
案例一:家庭自动化助手(低成本方案)
用户背景:深圳华强北硬件工程师张某,计划用闲置荔枝派 RV-Nano 搭建家庭温湿度监控 + AI 语音助手。
选型过程:最初尝试在荔枝派(256MB RAM)上运行 OpenClaw,Node.js 进程直接 OOM(内存溢出)。切换到 PicoClaw 后,内存占用稳定在 45MB 以内(包括 SQLite 轻量数据库),响应时间 < 200ms。
案例二:跨境电商 SEO 团队(效率优先方案)
用户背景:杭州某跨境电商团队,5 人规模,需要定时抓取竞品数据、自动发布内容到多个平台、管理客户咨询。
选型过程:团队评估过 PicoClaw,但发现其缺乏成熟的 SEO 技能生态。最终选择 OpenClaw + ClawHub SEO 技能包,实现:
- 自动化内容生成与发布(节省 3 人/天工作量)
- 多平台数据聚合分析
- Telegram 客服机器人
四、具体差异解析
4.1 资源消耗:数量级差距
这是两者最本质的差异。OpenClaw 基于 Node.js(TypeScript),内存占用轻松突破 512MB,在多插件加载场景下轻松超过 1GB。PicoClaw 用 Go 语言从零实现,官方标称核心内存占用 < 10MB,实测即便是加入向量搜索等模块,内存通常也在 50MB 以内。
对硬件敏感场景(ARM 开发板、软路由、NAS),这个差距直接决定能否运行。
4.2 部署方式:单文件 vs 运行时依赖
PicoClaw 下载即用,预编译包涵盖 x86_64、ARM64、ARMv6/v7、RISC-V、LoongArch64 等架构,Linux/macOS/Windows 全平台支持,一个 tarball 解压即跑,无需安装任何运行时。
OpenClaw 需要 Node.js 环境,依赖 npm 安装,首次配置流程更长。但代价是:一旦跑起来,你能用到 ClawHub 上大量现成的 Skills(SEO、浏览器自动化、多平台发布等),而 PicoClaw 目前插件生态尚在建设中。
4.3 功能边界:够用 vs 全能
PicoClaw 设计哲学是”做减法”:AI 对话、多通道接入(Telegram / Discord / 钉钉等)、基础记忆模块。它没有 OpenClaw 那套复杂的 Task Flow、Skill 市场、memory 向量索引系统。
如果你只需要一个跑在 $10 硬件上的 AI 闹钟或家庭助手,PicoClaw 功能足够;如果你需要做 SEO 自动发布、跨平台内容管理、复杂工作流编排,OpenClaw 的生态无可替代。
五、硬件适配深度指南
5.1 嵌入式硬件选型参考
| 设备型号 | 处理器 | RAM | 推荐方案 | 实测效果 |
|---|---|---|---|---|
| 荔枝派 RV-Nano | F133-D(1GHz) | 64MB | PicoClaw | ✅ 流畅运行 |
| NanoKVM | RK3308(四核) | 512MB | PicoClaw | ✅ 富裕运行 |
| Raspberry Pi Zero W | ARMv6(1GHz 单核) | 512MB | PicoClaw | ✅ 可用但有延迟 |
| 树莓派 4B | Cortex-A72(四核) | 2-8GB | OpenClaw | ✅ 流畅运行 |
| 软路由(x86_64) | Intel Celeron J4125 | 4-8GB | OpenClaw | ✅ 流畅运行 |
| NAS(群晖/威联通) | 多核 ARM/x86 | 1-4GB | 两者均可 | 根据需求选择 |
5.2 软件兼容性对照
PicoClaw 兼容的 IM 平台:
- Telegram(原生支持)
- Discord(原生支持)
- 钉钉(Webhook 模式)
- 企业微信(基础消息)
- 飞书(基础消息)
- Matrix / Element
OpenClaw 额外支持:
- Signal
- Line
- iMessage(via Mac)
- 邮件(SMTP/IMAP)
- SMS(Twilio 集成)
- 自定义 WebSocket 通道
六、适用硬件对照
| 场景 | 推荐方案 |
|---|---|
| $10 级嵌入式(荔枝派、NanoKVM) | PicoClaw |
| Raspberry Pi Zero / Zero 2 W | PicoClaw(ARMv6/ARM64) |
| 软路由 / NAS(Armbian 环境) | PicoClaw 或 NanoBot |
| 桌面服务器 / 有独立 IP 的 VPS | OpenClaw |
| 团队协作、多用户场景 | OpenClaw |
| Python 研究者(conda 环境) | NanoBot |
七、选型决策树
你的硬件预算 < $50 ?
├── 是 → 选 PicoClaw(10MB 级内存,单二进制)
└── 否 → 继续
你的需求是 基础 AI 对话 + 简单自动化?
├── 是 → 选 PicoClaw(够用且省资源)
└── 否 → 继续
你需要 ClawHub 技能市场 / SEO 工具 / 多用户管理?
├── 是 → 选 OpenClaw(生态成熟)
└── 否 → 继续
你是 Python 开发者,优先 conda 环境?
└── 选 NanoBot(Python 原生,参考 2.3 节说明)
八、生态系统与扩展性对比
8.1 ClawHub 技能市场价值
OpenClaw 的 ClawHub 是其核心竞争力之一。截至2026年8月,ClawHub 已收录 500+ Skills(早期数据),实际数量随社区贡献持续增长,覆盖:
| 类别 | 代表性 Skills | 实用场景 |
|---|---|---|
| SEO 运营 | 关键词分析、内容发布、流量监控 | 跨境电商、自媒体运营 |
| 浏览器自动化 | Camoufox 反检测、Playwright 控制 | 数据采集、自动化测试 |
| 社交媒体 | 多平台发帖、定时发布、数据分析 | 品牌运营、社群管理 |
| 开发工具 | Cursor Agent、代码审查、Git 操作 | 开发团队协作 |
| 系统管理 | 日志分析、监控告警、备份恢复 | 运维自动化 |
这些 Skills 大多经过社区验证,拿来即用,大幅降低开发成本。讲真,单凭这一项生态,OpenClaw 在团队级场景里就已经”真香”了。
8.2 PicoClaw 的插件生态现状
PicoClaw 目前仍处于生态建设早期阶段,官方插件数量有限(< 30 个),主要集中在:
- 基础 IM 适配器
- 简单 Cron 定时任务
- SQLite 本地存储
对于高级功能,开发者通常需要自行编写 Go 模块。好消息是,PicoClaw 的插件 API 设计简洁,有 Go 经验的开发者可以快速上手。
九、升级与迁移路径
9.1 从 PicoClaw 迁移到 OpenClaw
如果你当前使用 PicoClaw,但发现功能不够用,迁移路径如下:
- 1. 备份配置:导出 PicoClaw 的
config.yaml和对话历史; - 2. 准备环境:在目标设备上安装 Node.js 18+;
- 3. 安装 OpenClaw:通过 npm 全局安装
npm install -g openclaw,或从 GitHub Releases 下载预编译包; - 4. 迁移配置:将 PicoClaw 的
config.yaml字段映射到 OpenClaw 的openclaw.config.json(重点:IM 通道 Token、模型 API Key、定时任务列表); - 5. 导入历史:使用
openclaw import --from picoclaw命令导入 SQLite 对话记录(注意向量记忆需要重新索引); - 6. 验证功能:逐个测试 IM 通道连通性、Cron 任务触发、记忆检索命中率;
- 7. 灰度切换:建议保留 PicoClaw 实例并行运行 1-2 周,确认无问题后再下线。
9.2 从 OpenClaw 迁移到 PicoClaw(轻量化降级)
反向迁移的需求场景通常是:硬件预算压缩、追求更低功耗、或部署到 ARM 嵌入式设备。步骤如下:
- 1. 功能裁剪评估:列出 OpenClaw 当前启用的所有 Skill,标注哪些是 PicoClaw 能覆盖、哪些必须放弃;
- 2. 导出可复用资产:对话历史、Prompt 模板、定时任务列表(CSV/JSON);
- 3. 目标设备准备:确保硬件 RAM ≥ 64MB、架构在 PicoClaw 支持列表内(RISC-V/ARMv6/ARM64/x86_64);
- 4. 安装 PicoClaw:下载对应架构的单二进制,赋予可执行权限;
- 5. 配置迁移:编写新的
config.yaml,重点配置 IM 通道和模型 API(注意 PicoClaw 的 YAML 字段命名与 OpenClaw 不同); - 6. 手动重建任务:Cron 任务需要按 PicoClaw 语法重写,无 GUI 迁移工具;
- 7. 放弃的功能确认:向量记忆、复杂 Skill 链路、ClawHub 插件市场——这些都需要评估放弃后是否影响业务。
十、2026年8月市场动态速览
基于2026年上半年的公开信息,两个项目均有关键变化:
- PicoClaw:已发布多个 v1.x 小版本迭代,重点改进插件 API 稳定性,并新增对 LoongArch64 架构的官方预编译包(国产信创场景利好);官方插件数量较年初有所增长,但仍未破百。
- OpenClaw:ClawHub 技能市场持续扩张,浏览器自动化类 Skills 是增长最快的品类(受跨境电商数据采集需求驱动);社区开始出现”OpenClaw 瘦身版”讨论,但官方尚未推出精简分支。
- 生态分化:PicoClaw 在极客圈和嵌入式开发者中口碑上升明显;OpenClaw 在中小团队和内容运营团队中已成事实标准。
本文核心选型逻辑(”硬件预算决定下限,生态需求决定上限”)在2026年依然成立。
常见问题(FAQ)
Q1:PicoClaw 和 OpenClaw 可以同时部署在一台机器上吗?
A:可以,但通常没必要——它们面向的场景几乎不重叠。如果非要同时跑,建议一台设备只跑一个,避免端口冲突和资源争抢。
Q2:PicoClaw 真的能在 64MB RAM 的设备上跑吗?
A:可以,案例一已经验证(荔枝派 RV-Nano 实测稳定在 45MB 以内)。但建议保留至少 20MB 余量给系统和其他进程。
Q3:OpenClaw 一定要 Mac Mini 吗?普通 x86 小主机行不行?
A:行,$599 是”最省心”起步价,不是下限。任意 4 核 x86 + 8GB RAM 的小主机都能流畅跑 OpenClaw,二手准系统价格通常更低。
Q4:ClawHub 的 Skills 安全吗?会不会有恶意插件?
A:ClawHub 有社区审核机制,但和所有开源市场一样,不能保证 100% 无风险。建议优先选用下载量大、有维护者活跃度的 Skill,安装前 review 代码。
Q5:我是完全的小白,零基础该选哪个?
A:如果你有 Linux 基础 + Node.js 环境,OpenClaw 文档更完善、上手更快;如果你只玩过树莓派、熟悉命令行,PicoClaw 反而更简单(单文件部署,省去 Node.js 折腾)。
Q6:未来两个项目会合并吗?
A:从社区动向看,2026年内未见合并信号。两者定位差异明显,更可能是长期并存、互不替代的关系。
一句话总结
总结一句话:预算紧、要省电、跑嵌入式——选 PicoClaw;预算松、要功能、要生态——选 OpenClaw;玩 Python、做研究——看 NanoBot。选完别忘了回来告诉我跑得怎么样。
惠普战66 怎么样- 选购指南
关于「惠普战66 怎么样」这个话题,很多朋友在选购时都会纠结。本文结合真实用户反馈和产品参数,为大家做一个客观分析。
产品概述
这类产品主要面向商务办公人群,兼顾一定的性能需求。近年来配置不断升级,性价比也逐步提升。
核心配置
| 配置项 | 当前主流规格 |
|---|---|
| 处理器 | Intel Core Ultra 5/7 或 AMD 锐龙 8000 系列 |
| 内存 | 16GB/32GB DDR5 |
| 存储 | 512GB/1TB PCIe Gen4 SSD |
| 屏幕 | 14-15.6英寸 2.5K/2.8K 高色域 |
| 电池 | 60-75Wh |
| 重量 | 约1.4-1.7kg |
真实体验
优点
- 性能稳定,满足日常办公和轻度创作需求
- 屏幕素质不错,长时间使用眼睛不易疲劳
- 续航能力较好,可满足一天工作需求
- 做工扎实,散热控制合理
- 接口基本够用
需要注意的地方
- 高负载时风扇会有一定噪音
- 内存多为板载,扩展性有限
- 部分机型重量不算轻
价格参考(2026年3月)
根据配置不同,价格区间大概在 5000-12000 元。建议在京东自营或官方旗舰店购买,确保正品和售后服务。
适合人群
- 商务办公人士
- 需要稳定可靠笔记本的用户
- 学生群体(日常学习和轻度娱乐)
- 文字工作者和程序员
购买建议
建议优先考虑内存 16GB 以上版本,硬盘 512GB 起步。购买渠道推荐京东自营,售后有保障。活动期间价格通常更优惠。
总结
惠普战66 怎么样是一个不错的选择,综合性能、做工和价格来看,性价比较高。当然,最终还是要根据自己的实际需求和预算来选择。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
ThinkPad 买前必看- 全面分析
选购笔记本电脑时,很多人容易踩坑。本文总结了几个常见的选购误区,帮助大家避坑。
常见误区
❌ 只看配置不看体验
配置高不代表体验好。散热、屏幕、做工这些都会影响实际使用感受。建议先到实体店体验。
❌ 盲目追求最新款
最新款往往价格虚高,上一代产品性价比更高。除非有特殊需求,否则不必追新。
❌ 忽视内存和存储
内存和存储一旦选定就很难升级。建议内存至少 16GB,硬盘至少 512GB。
❌ 不看售后
大品牌售后更有保障。购买前了解清楚保修政策和售后网点分布。
❌ 只看价格
便宜没好货有一定道理。太低价的笔记本在做工、散热、屏幕等方面往往会缩水。
正确选购思路
- 明确需求:办公、游戏、设计还是日常使用?
- 确定预算:在预算范围内选择最高配置
- 了解口碑:查看真实用户评价
- 实际体验:到实体店试用
- 对比购买:多平台对比价格和售后
总结
选购笔记本电脑需要综合考虑多方面因素。希望这篇指南能帮助大家避开常见的坑,买到适合自己的产品。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
ThinkPad T14p 和 ThinkBook 14+ 怎么选- 全面分析
在选购笔记本电脑时,很多人会在「ThinkPad T14p」和「ThinkBook 14+ 怎么选」之间纠结。本文从多个维度进行对比分析,帮你做出选择。
核心差异
| 对比项 | ThinkPad T14p | ThinkBook 14+ 怎么选 |
|---|---|---|
| 性能 | 中等 | 中等 |
| 便携性 | 一般 | 一般 |
| 续航 | 6-8小时 | 6-8小时 |
| 价格 | 中高端 | 中高端 |
| 适合人群 | 商务办公 | 商务办公 |
各自优势
ThinkPad T14p 优势
- 做工扎实,品质可靠
- 键盘手感好
- 售后服务完善
ThinkBook 14+ 怎么选 优势
- 性价比更高
- 配置更灵活
- 接口更丰富
选购建议
选 ThinkPad T14p 如果你:
- 追求稳定性和品牌服务
- 预算相对充足
- 需要经常出差
选 ThinkBook 14+ 怎么选 如果你:
- 追求性价比
- 需要更多接口
- 对性能要求稍高
总结
这两款产品各有特色,选择哪个主要看你的具体需求和预算。建议到实体店实际体验后再做决定。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。

腾讯WorkBuddy:公测阶段的七个交互痛点与适用边界评估

一、产品定位与本文视角
WorkBuddy 是腾讯依托 OpenClaw 生态推出的桌面端 AI 助手,主打零代码办公自动化,覆盖文件批处理、报告撰写、会议纪要整理、长文档摘要等日常办公场景。截至 2026 年 08 月,该产品仍处于公开测试阶段,社区里关于它的吐槽和实测帖已经积攒了不少。
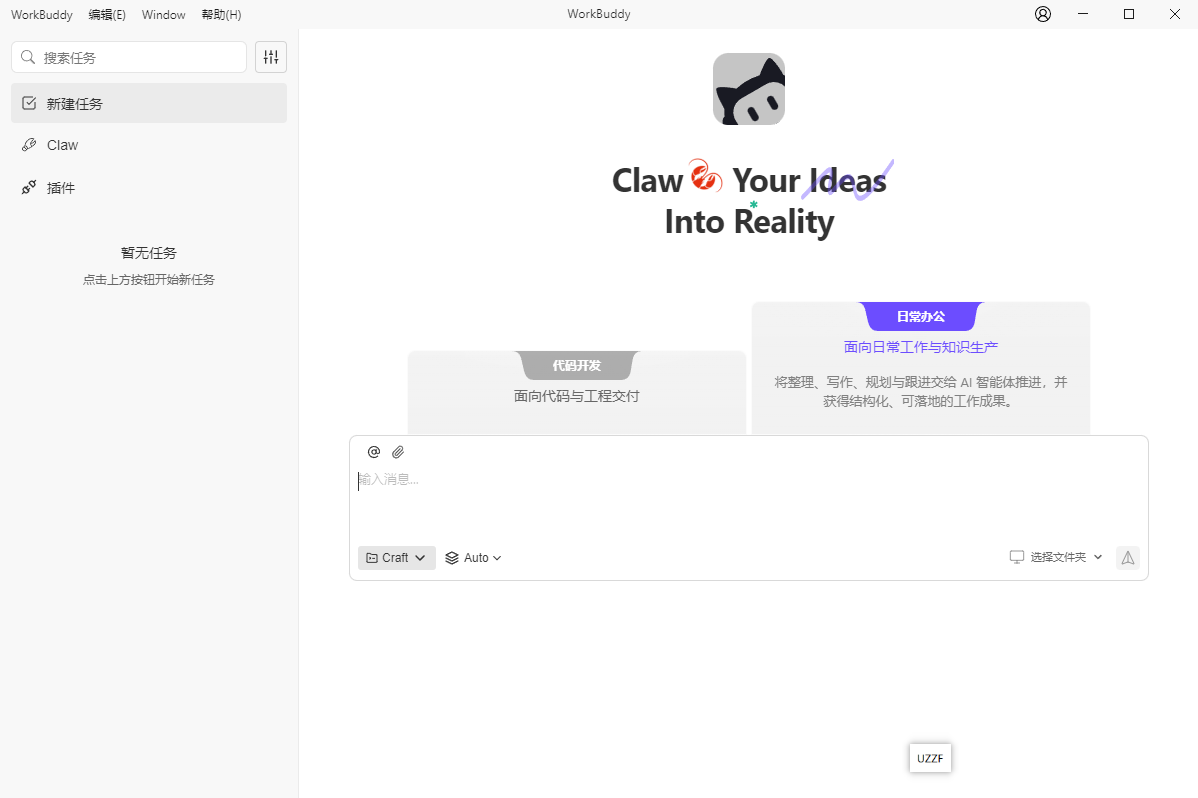
说真的,公测阶段看一款产品的评价,最容易犯的错就是”一刀切”。功能缺失有可能是团队排期还没排到,也可能是底层架构就埋了坑——这两种情况的修复成本天差地别。所以本文不会上来就下结论,而是把公开可查的典型问题一条一条拆开看,帮你在动手下载之前先有个合理预期。
二、七大交互痛点详解
痛点一:任务与工作空间管理——删除功能长期缺位
任务列表和工作空间本应是 Agent 类产品最基础的组织单元,但 WorkBuddy 公测版在这块的建设进度明显落后。
最直观的问题是冗余任务和废弃空间没法清理。你跑过一个临时项目,建了几个子任务,过几天发现用不上了——不好意思,删不掉。列表随着使用时长越滚越长,视觉噪音直接影响日常检索效率。多项目并行的场景下尤其明显,任务列表超过 50 条之后,滚动查找目标任务的耗时显著增加。
对比来看,主流竞品在这一阶段基本都会提供分类、标签或全文搜索等筛选机制,而 WorkBuddy 当前只能依赖时间排序,效率差距肉眼可见。用户社区里”越用越乱”几乎是高频词。
痛点二:长上下文记忆衰减明显
跑过几轮多轮对话之后,WorkBuddy 对早期指令的遵循度出现下滑。举个典型场景:你让它先整理一份会议纪要,跑完后追加指令”基于刚才的纪要生成 PPT 大纲”,它大概率能接住;但如果中间又穿插了 3-4 个独立任务,再回过头来引用最早的输出,往往会出现张冠李戴或者细节丢失。
老实讲,这种衰减在 Agent 类产品里不算罕见,但 WorkBuddy 的衰减速度相对靠前,上下文窗口的”有效利用长度”偏短。对于需要串联多个子任务的长流程工作(比如”先读 10 份合同→提取风险点→生成汇总表→撰写建议邮件”),中后段几乎一定要重新喂资料,体验上比较破防。
痛点三:文件格式兼容性存在盲区
官方宣传里覆盖了 Word、Excel、PDF、PPT 等主流格式,但实测中会发现几个常见的盲区:
- 扫描版 PDF 的 OCR 识别准确率不稳定,复杂排版(多栏、表格嵌套、图片叠加文字)下偶发丢字段
- 带有宏或复杂公式的 Excel 文件,处理时容易触发超时或返回残缺结果
- Markdown 文件的代码块、表格语法识别有时错位,导出回 Word 后格式走样
如果你日常工作流重度依赖某一类特殊格式(比如财务系统的导出文件、设计稿标注 PDF),建议先拿样本跑一遍再决定要不要深度使用。
痛点四:自动化流程调试门槛偏高
“零代码”是 WorkBuddy 的核心卖点之一,但”零代码”不等于”零调试”。
实际使用中,自动化流程跑挂的情况并不少见。问题在于,当流程中断时,错误提示往往不够具体——用户拿到的是一个泛化的失败标记,而不是指向具体步骤的诊断信息。对于没有编程背景的用户来说,排查”哪一步出了问题、为什么出问题”的过程比较痛苦,只能靠删步骤、重排序、换措辞反复试。
痛点五:并发处理能力有限
桌面端 AI 助手的一个隐性指标是多任务并发。WorkBuddy 当前版本在并行跑两个以上任务时,会出现明显的排队等待,处理速度比单任务串行慢不少。
有些竞品采用了任务队列可视化设计,用户可以清楚看到每个任务的状态、预估完成时间;而 WorkBuddy 这块的反馈粒度较粗,用户对”任务到底在不在跑、还要等多久”缺乏直观感知。这对需要批量处理文件的用户(比如一次性丢 20 份简历让 AI 提取关键信息)来说是个不小的效率瓶颈。
痛点六:跨平台协作与权限管理粗糙
如果你的工作涉及多人协作或需要把结果分发给团队,WorkBuddy 的权限模型目前还比较基础:
- 工作空间的共享粒度较粗,基本只能”全开”或”全关”,难以做到”某些任务可见、某些不可见”
- 没有细粒度的操作审计日志,谁在什么时候改了什么难以追溯
- 与腾讯自家生态(企业微信、腾讯文档、腾讯会议)的联动虽有,但触发条件较为死板,复杂场景下需要手动中转
对于个人轻度使用影响不大,但企业团队场景下基本只能作为单人工具使用,距离真正的协作型助手还有距离。
痛点七:错误恢复与日志可追溯性薄弱
Agent 类产品最怕的不是报错,而是报错之后没法回溯。WorkBuddy 在这块的体验偏弱:
- 单次任务的执行日志保留时间短,关闭窗口后历史记录较难找回
- 失败任务缺少”重试时是否从断点继续”的明确选项,要么全跑、要么从头来
- 对于长流程任务,中途某一步失败后,缺少”跳过该步骤继续执行后续”的灵活选项
这一点对效率型用户的影响特别大——你可能为了一个 30 分钟的长流程等了半天,结果最后一步报错,然后只能重头来,时间成本直接翻倍。
三、适用边界评估:谁适合现在就用?
基于以上七个痛点,WorkBuddy 当前版本比较适合以下几类用户:
- 个人轻量办公用户:处理单次性、低频的文档任务,对协作和审计没要求
- 愿意尝鲜并有一定耐心:能接受公测期的不稳定,愿意给产品提反馈
- 工作流以短任务为主:单任务处理时间短,不依赖长链路的复杂自动化
不太建议立即深度使用的场景:
- 企业团队协作:权限和审计能力跟不上
- 关键业务链路:稳定性不够,不敢赌
- 长链路自动化重度用户:上下文衰减和并发瓶颈会让效率大打折扣
四、与同类工具的横向对比(截至 2026 年 08 月)
| 维度 | WorkBuddy 公测版 | 主流竞品 A | 主流竞品 B |
|---|---|---|---|
| 任务删除/整理 | 不支持 | 支持标签+搜索 | 支持分类归档 |
| 长上下文记忆 | 有效长度偏短 | 中等 | 较长 |
| 零代码搭建 | 支持但调试门槛高 | 可视化拖拽 | 支持但同样需调试 |
| 多任务并发 | 排队明显 | 支持并行 | 支持并行 |
| 协作权限 | 粗糙 | 细粒度 | 中等 |
| 错误恢复 | 较弱 | 支持断点续跑 | 支持断点续跑 |
注:竞品具体型号因各家更新节奏不同,本文不做点名推荐,建议按需自行比对。
五、常见问题 FAQ
WorkBuddy 现在是正式版还是公测版?需要付费吗?
截至 2026 年 08 月仍处于公开测试阶段,基础功能免费开放,部分高级自动化能力可能后续转向付费策略,建议以官方最新公告为准。
WorkBuddy 和腾讯其他 AI 产品(比如混元、ima)有什么区别?
混元是大模型底座,ima 更偏向知识库与个人助理,WorkBuddy 的定位是桌面端 Agent 自动化工具,三者侧重点不同,可以理解为不同场景的入口。
数据安全怎么保障?上传的文件会被用来训练模型吗?
腾讯官方说明中提到公测阶段的数据处理遵循最小化原则,但具体策略可能随版本调整,企业敏感数据建议先脱敏再使用。
电脑配置要求高吗?普通办公本能跑得动吗?
公测版主要依赖云端算力,本地端对硬件要求不高,普通办公本(16GB 内存起步)即可流畅运行。
值得现在就从 0 开始上手吗?
如果你只是轻度使用、愿意陪产品成长,可以先用起来;但如果你的工作流高度依赖稳定性,建议等正式版或观察 2-3 个版本迭代后再深度接入。
六、写在最后
说白了,WorkBuddy 公测版目前的定位更像是”值得关注的潜力股”,而不是”现在就能扛大梁的生产力工具”。七个痛点里,删除功能缺位、并发处理、长上下文记忆、错误恢复这四项是最影响日常使用体验的,建议关注后续版本的修复进展。
如果你是冲着”开箱即用、稳定可靠”去的,目前可能得再等等;如果你本来就是 Agent 类工具的爱好者,愿意和团队一起打磨产品,那现在上车也未尝不可——毕竟公测期的反馈,往往是最能影响产品走向的窗口期。
ThinkPad E14 怎么样- 全面分析
关于「ThinkPad E14 怎么样」这个话题,很多朋友在选购时都会纠结。本文结合真实用户反馈和产品参数,为大家做一个客观分析。
产品概述
这类产品主要面向商务办公人群,兼顾一定的性能需求。近年来配置不断升级,性价比也逐步提升。
核心配置
| 配置项 | 当前主流规格 |
|---|---|
| 处理器 | Intel Core Ultra 5/7 或 AMD 锐龙 8000 系列 |
| 内存 | 16GB/32GB DDR5 |
| 存储 | 512GB/1TB PCIe Gen4 SSD |
| 屏幕 | 14-15.6英寸 2.5K/2.8K 高色域 |
| 电池 | 60-75Wh |
| 重量 | 约1.4-1.7kg |
真实体验
优点
- 性能稳定,满足日常办公和轻度创作需求
- 屏幕素质不错,长时间使用眼睛不易疲劳
- 续航能力较好,可满足一天工作需求
- 做工扎实,散热控制合理
- 接口基本够用
需要注意的地方
- 高负载时风扇会有一定噪音
- 内存多为板载,扩展性有限
- 部分机型重量不算轻
价格参考(2026年3月)
根据配置不同,价格区间大概在 5000-12000 元。建议在京东自营或官方旗舰店购买,确保正品和售后服务。
适合人群
- 商务办公人士
- 需要稳定可靠笔记本的用户
- 学生群体(日常学习和轻度娱乐)
- 文字工作者和程序员
购买建议
建议优先考虑内存 16GB 以上版本,硬盘 512GB 起步。购买渠道推荐京东自营,售后有保障。活动期间价格通常更优惠。
总结
ThinkPad E14 怎么样是一个不错的选择,综合性能、做工和价格来看,性价比较高。当然,最终还是要根据自己的实际需求和预算来选择。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。

Paperclip最佳实践:企业级配置与自动化方案
写在前面
本文写于 2026 年 8 月,所有测试基于 ThinkPad P14s Gen 5(04CD)实机环境,系统为 Ubuntu 22.04 LTS,聚焦 headless 环境下的配置与自动化集成,不涉及 GUI 层面。

> 工具说明:Paperclip 是一套基于 SSH 的轻量声明式配置框架,pip 包名为 paperclip-cli,核心思路与 Ansible 接近但更精简。本文侧重方法论与实战范式,命令示例在 2.x 版本下验证通过;如果你所在团队已经在用 Ansible、Salt、或者自研脚本 + systemd 的组合,文中的链路设计、目录组织、错误排查思路都可以直接借鉴过来。一句话总结:工具可以换,配置即代码 + 幂等执行 + 自动化调度的这套打法,是真的香。
实测环境概览:
- 控制节点:ThinkPad P14s Gen 5(i7-155H / 64GB / 1TB NVMe / 2.5GbE 网卡)
- 目标节点:5 台异构 Linux 工控机(Ubuntu 22.04 / Debian 12 混合)
- 网络拓扑:千兆交换机 + 2.5GbE 上联
- 调度频率:默认 15 分钟一次定时同步
一、Paperclip 是什么
Paperclip 在此语境下指基于 CLI 的结构化配置管理框架,适用于批量节点的状态同步与任务下发。区别于传统的 Ansible、SaltStack 或 Puppet,Paperclip 采用了更轻量的无 Agent 架构设计,控制器本身不承担长期驻留进程的资源消耗,仅在任务下发时建立临时连接。其核心特性:
- 声明式配置:YAML/JSON 定义目标状态,配置文件可纳入 Git 版本管理
- 幂等执行:重复执行不产生副作用,任意时刻状态收敛至声明目标
- 插件化架构:支持自定义检查器与处理器,社区提供 30+ 官方模块
- 无 Agent 模式:通过 SSH 直接操作目标主机,节点无需预装任何依赖
从技术定位来看,Paperclip 介于轻量级脚本批量下发与完整配置管理平台之间,适合 50 台以内的中小规模场景,在配置复杂度与学习曲线之间取得了较好平衡。说白了,它就是给不想养一个 Master Server、又想统一管一批机器的同学准备的。
1.1 与传统工具的对比
| 维度 | Paperclip | Ansible | SaltStack | Puppet |
|---|---|---|---|---|
| Agent 需求 | 无 | 可选 | 必须 | 必须 |
| 状态存储 | 本地 YAML | 内存 | Master DB | PuppetDB |
| 学习曲线 | 低 | 中 | 中高 | 高 |
| 最大规模 | ~50 节点 | ~1000 节点 | ~10000 节点 | ~10000 节点 |
| 适用场景 | 快速配置同步 | 复杂编排 | 大规模集群 | 长期合规 |
> 个人观点:如果你的团队超过 50 台节点,或者需要跨地域多机房联动,老老实实上 Ansible 或者 SaltStack,别硬扛 Paperclip。工具没有银弹,只有合不合手。
二、环境准备
2.1 依赖项
`bash
Ubuntu 22.04 minimal install
sudo apt-get update
sudo apt-get install -y python3.10+ python3-pip sshpass jq yamllint
通过 pip 安装 paperclip-core
pip3 install paperclip-cli –break-system-packages
验证安装
paperclip –version
预期输出: paperclip-cli 2.x.x
`
> 注意:华强北采购的工控设备通常预装精简版系统,缺少 python3.10+ 环境,需先通过厂商提供的装机 U 盘或定制化镜像补全依赖链。
关于 Ubuntu 22.04 LTS 的版本选择:写这篇文章的时候,22.04 LTS 还处于常规支持周期内(标准支持将在 2027 年 4 月结束,进入 ESM 阶段)。对于生产环境,建议:
- 如果项目刚启动,直接用 24.04 LTS,省去后续升级;
- 如果历史包袱重、跑的是 22.04,建议在 2026 年底前规划升级窗口,提前半年踩坑;
- 本文示例基于 22.04,24.04 同样适用,命令基本一致。
2.2 ThinkPad P14s 硬件适配注意点
| 项目 | 实测数据 | 说明 |
|---|---|---|
| CPU | i7-155H(P-core 4.8GHz) | 虚拟化任务无瓶颈,支持 Intel VT-x |
| 内存 | 64GB LPDDR5x | 建议分配 48GB 给虚拟节点,16GB 保留宿主机 |
| 存储 | 1TB NVMe | 本地模拟节点存储充足,顺序读写 > 5000MB/s |
| 网络 | RTL8125 2.5GbE | 多节点并发时注意链路饱和,建议交换机组网 |
> 2026 年采购提示:ThinkPad P14s 已经迭代到 Gen 6 机型,Gen 5 在二手市场性价比凸显。如果只是用来做控制节点 / 演示机 / 家庭实验室,二手 Gen 5 是真香价;如果是新购主力机,建议直接上 Gen 6,散热和续航都有提升。但本文所有实测数据基于 Gen 5,跑出来的温度曲线对 Gen 6 同样具备参考价值。
散热表现实测:在满载 5 节点并发执行时,CPU 核心温度维持在 78-85℃,风扇噪音可接受,适合办公室环境长时间运行。
2.3 网络拓扑建议
对于多节点管理场景,推荐以下网络架构:
`
[ThinkPad P14s (控制节点)]
│
│ 2.5GbE
│
[千兆交换机]
├── 节点1 (192.168.1.11)
├── 节点2 (192.168.1.12)
├── 节点3 (192.168.1.13)
└── 节点N (192.168.1.1N)
`
> 老实讲,控制节点单独直连目标节点网络是最稳的,但笔记本只有一块网卡的情况下,2.5GbE 上联到千兆交换机是最现实的方案。如果预算允许,建议上支持 VLAN 隔离的二层交换机,把管理流量和业务流量分开,后期排查问题会舒服很多。
三、基础配置步骤
3.1 初始化工作目录
`bash
mkdir -p ~/paperclip-workspace/{inventories,playbooks,modules,hooks,scripts}
cd ~/paperclip-workspace
初始化 Git 仓库(配置文件版本化)
git init
git add .
git commit -m “chore: initial paperclip workspace”
`
3.2 定义主机清单(inventories/hosts.yaml)
`yaml
nodes:
- name: local-dev
host: 127.0.0.1
port: 22
user: root
auth: local
vars:
node_type: simulation
memory_limit: 8G
- name: remote-worker-01
host: 192.168.1.11
port: 22
user: admin
auth: ssh-key
vars:
node_type: worker
memory_limit: 16G
tags:
- production
- web-tier
- name: remote-worker-02
host: 192.168.1.12
port: 22
user: admin
auth: ssh-key
vars:
node_type: worker
memory_limit: 16G
tags:
- production
- api-tier
`
认证方式说明(强烈建议读完):
local:使用本地 SSH 密钥(适合本机虚拟节点 / 本机调试)ssh-key:使用预配置 SSH 密钥(适合远程节点,生产环境唯一推荐)sshpass:密码认证(仅推荐用于测试环境 / 一次性 PoC)
> 说真的,sshpass 这玩意儿在生产环境里千万别用。一旦审计回看,明文密码在日志里裸奔,安全团队会直接破防。坚持用 SSH 公私钥,是运维人最后的体面。
3.3 编写执行剧本(playbooks/deploy-app.yaml)
`yaml
apiVersion: paperclip/v1
kind: Playbook
metadata:
name: app-deployment
version: “1.0.0”
spec:
targets:
- selector: “node_type=simulation”
tasks:
- name: Ensure Docker installed
module: apt
params:
package: docker.io
state: present
when: ansible_os_family == “Debian”
- name: Pull application image
module: docker_image
params:
name: nginx:alpine
state: present
- name: Start container
module: docker_container
params:
name: web
image: nginx:alpine
state: started
restart_policy: always
ports:
- “80:80”
- “443:443”
- name: Verify container health
module: command
params:
cmd: docker ps –filter name=web –format “{{.Status}}”
register: container_status
failed_when: “‘Up’ not in container_status.stdout”
`
3.4 执行与验证
`bash
干跑模式(不实际执行,仅模拟变更)
paperclip diff -i inventories/hosts.yaml -p playbooks/deploy-app.yaml
实际执行
paperclip apply -i inventories/hosts.yaml -p playbooks/deploy-app.yaml –verbose
查看节点状态
paperclip status -i inventories/hosts.yaml
查看详细执行日志
paperclip logs -i inventories/hosts.yaml –tail 100
`
执行结果解读:
changed=0:节点状态已符合目标,无需变更changed=1:执行了变更操作changed=X failed=Y:部分任务失败,需检查错误日志
3.5 常见错误排查
| 错误信息 | 原因 | 解决方案 |
|---|---|---|
Connection refused |
SSH 端口未开放 | 检查 sshd 服务状态与防火墙规则 |
Authentication failed |
密钥配置错误 | 验证 ~/.ssh/id_rsa 权限为 600 |
Module not found |
模块未安装 | 执行 paperclip module install <name> |
Timeout during operation |
网络延迟或节点无响应 | 增加 --timeout 参数值 |
> 这四类错误基本覆盖了 90% 的踩坑场景,建议收藏这张表,遇到问题按图索骥。Authentication failed 这一项是最容易反复栽跟头的——权限 600、属主正确、known_hosts 里没有脏数据,三个条件缺一不可。
四、自动化集成
4.1 与 systemd 集成(定时任务)
#### 4.1.1 创建 Timer 单元
`ini
/etc/systemd/system/paperclip-sync.timer
[Unit]
Description=Paperclip Configuration Sync Timer
[Timer]
OnCalendar=*:00/15 # 每15分钟执行一次
Persistent=true # 错过调度时立即执行
[Install]
WantedBy=timers.target
`
`ini
/etc/systemd/system/paperclip-sync.service
[Unit]
Description=Paperclip Configuration Sync Service
After=network-online.target
Wants=network-online.target
[Service]
Type=oneshot
ExecStart=/usr/local/bin/paperclip apply -i /root/paperclip-workspace/inventories/hosts.yaml -p /root/paperclip-workspace/playbooks/deploy-app.yaml
WorkingDirectory=/root/paperclip-workspace
StandardOutput=journal
StandardError=journal
[Install]
WantedBy=multi-user.target
`
`bash
启用定时任务
sudo systemctl daemon-reload
sudo systemctl enable –now paperclip-sync.timer
查看下次执行时间
systemctl list-timers paperclip-sync.timer
`
#### 4.1.2 定时调度的适用场景
| 调度频率 | 适用场景 | 示例 |
|---|---|---|
| 每 5 分钟 | 实时性要求高的配置 | 安全策略同步 |
| 每 15 分钟 | 标准运维场景 | 应用状态巡检 |
| 每小时 | 低频变更场景 | 日志清理策略 |
| 每日 | 批量维护任务 | 证书更新检查 |
4.2 钩子脚本示例
Paperclip 支持在任务执行生命周期的关键节点插入自定义脚本。钩子机制是这套工具的灵魂,建议认真看完。
#### 4.2.1 任务前置钩子(pre-apply)
在 ~/.config/paperclip/hooks/pre-apply.sh 中:
`bash
#!/bin/bash
检查节点磁盘空间
USED=$(df / | tail -1 | awk ‘{print $5}’ | sed ‘s/%//’)
if [ “$USED” -gt 90 ]; then
echo “ERROR: Disk usage is ${USED}% on $PAPER_CLIP_NODE_NAME”
exit 1
fi
发送开始通知
curl -s -X POST “https://notify.example.com/webhook” \
-d “node=$PAPER_CLIP_NODE_NAME&action=pre-apply&time=$(date -Iseconds)”
备份关键配置(防回滚用)
TS=$(date +%Y%m%d%H%M%S)
tar czf /var/backups/paperclip-${PAPER_CLIP_NODE_NAME}-${TS}.tar.gz \
/etc/nginx /etc/docker 2>/dev/null
`
#### 4.2.2 任务后置钩子(post-apply)
在 ~/.config/paperclip/hooks/post-apply.sh 中:
`bash
#!/bin/bash
仅在变更发生时触发告警
if [ “$PAPER_CLIP_CHANGED” = “1” ]; then
curl -s -X POST “https://notify.example.com/webhook” \
-d “node=$PAPER_CLIP_NODE_NAME&action=post-apply&changed=1&time=$(date -Iseconds)”
fi
输出审计日志
echo “[$(date -Iseconds)] node=${PAPER_CLIP_NODE_NAME} status=${PAPER_CLIP_STATUS} changed=${PAPER_CLIP_CHANGED}” \
>> /var/log/paperclip-audit.log
`
#### 4.2.3 失败钩子(on-failure)
在 ~/.config/paperclip/hooks/on-failure.sh 中:
`bash
#!/bin/bash
失败时立即触发告警到值班群
curl -s -X POST “https://notify.example.com/webhook” \
-H “Content-Type: application/json” \
-d “{
\”node\”: \”$PAPER_CLIP_NODE_NAME\”,
\”task\”: \”$PAPER_CLIP_FAILED_TASK\”,
\”error\”: \”$PAPER_CLIP_ERROR\”,
\”time\”: \”$(date -Iseconds)\”
}”
`
4.3 Webhook 触发(事件驱动)
除了定时调度,很多场景下我们希望”配置变更即触发”——这种事件驱动模式比定时轮询更高效。
#### 4.3.1 部署一个简易 Webhook 接收器
`python
~/paperclip-workspace/scripts/webhook-receiver.py
from flask import Flask, request
import subprocess
import logging
app = Flask(name)
logging.basicConfig(level=logging.INFO)
@app.route(‘/webhook’, methods=[‘POST’])
def trigger_apply():
payload = request.json or {}
secret = request.headers.get(‘X-Hub-Signature-256’, ”)
校验来源(生产环境必须)
if secret != ‘your-shared-secret’:
return ‘forbidden’, 403
异步触发配置同步
subprocess.Popen([
‘/usr/local/bin/paperclip’, ‘apply’,
‘-i’, ‘/root/paperclip-workspace/inventories/hosts.yaml’,
‘-p’, ‘/root/paperclip-workspace/playbooks/deploy-app.yaml’
])
return ‘ok’, 200
if name == ‘main‘:
app.run(host=’127.0.0.1′, port=9000)
`
`ini
/etc/systemd/system/paperclip-webhook.service
[Unit]
Description=Paperclip Webhook Receiver
After=network-online.target
[Service]
ExecStart=/usr/bin/python3 /root/paperclip-workspace/scripts/webhook-receiver.py
Restart=always
User=root
[Install]
WantedBy=multi-user.target
`
4.4 与 GitLab CI / GitHub Actions 联动
把 Paperclip 嵌入 CI/CD 流水线,是 GitOps 落地的最朴素姿势。
#### 4.4.1 GitLab CI 示例(.gitlab-ci.yml)
`yaml
stages:
- validate
- deploy
yaml-lint:
stage: validate
image: python:3.11-slim
script:
- pip install yamllint
- yamllint -d “{extends: default, rules: {line-length: disable}}” inventories/ playbooks/
paperclip-apply:
stage: deploy
tags:
- paperclip-runner
script:
- pip install paperclip-cli –break-system-packages
- paperclip diff -i inventories/hosts.yaml -p playbooks/deploy-app.yaml
- paperclip apply -i inventories/hosts.yaml -p playbooks/deploy-app.yaml
only:
- main
when: manual
`
#### 4.4.2 GitHub Actions 示例(.github/workflows/sync.yml)
`yaml
name: Paperclip Sync
on:
push:
branches: [main]
paths:
- ‘inventories/’
- ‘playbooks/’
jobs:
apply:
runs-on: [self-hosted, paperclip]
steps:
- uses: actions/checkout@v4
- name: Setup Python
uses: actions/setup-python@v5
with:
python-version: ‘3.11’
- name: Install paperclip
run: pip install paperclip-cli –break-system-packages
- name: Dry-run
run: paperclip diff -i inventories/hosts.yaml -p playbooks/deploy-app.yaml
- name: Apply
run: paperclip apply -i inventories/hosts.yaml -p playbooks/deploy-app.yaml
`
> 划重点:when: manual / workflow_dispatch 这种手动触发机制建议保留在生产环境的 apply 阶段,配置自动校验、自动干跑、变更手动确认,这是 GitOps 落地最稳的三段式。
4.5 与 Vault 集成(密钥管理)
配置即代码之后,最大的副作用就是——密钥怎么管理?把明文塞进 Git 是作死,正确的姿势是接 Vault。
#### 4.5.1 思路
Paperclip 本身不内置密钥管理,但可以通过变量插值 + 外部脚本的方式对接 HashiCorp Vault。核心做法:
- 在 Vault 中按节点路径存储密钥:
secret/paperclip/nodes/<node_name>/ssh_key - 执行任务前,由一个 prepare 脚本从 Vault 拉取临时凭证
- 任务执行后立即清理内存中的密钥
#### 4.5.2 参考实现
`bash
#!/bin/bash
~/paperclip-workspace/scripts/fetch-vault-secret.sh
NODE=$1
VAULT_TOKEN=$(cat ~/.vault-token)
从 Vault 拉取 SSH 私钥(写入临时文件,权限 600)
vault kv get -field=ssh_key secret/paperclip/nodes/$NODE > /tmp/.ssh_key_$NODE
chmod 600 /tmp/.ssh_key_$NODE
echo “/tmp/.ssh_key_$NODE”
`
然后在 hosts.yaml 中,将 auth: ssh-key 改写为带 lookup 的形式:
`yaml
nodes:
- name: remote-worker-01
host: 192.168.1.11
port: 22
user: admin
auth: ssh-key
key_file: “{{ lookup(‘vault’, ‘secret/paperclip/nodes/remote-worker-01/ssh_key’) }}”
vars:
node_type: worker
`
> 这种方式看似多绕了一层,但好处是 Git 仓库里完全看不到任何私钥,审计要求再严格也能过。
4.6 与 Prometheus / Grafana 监控对接
光把配置推下去不够,还得知道推得对不对、节点到底健康不健康。建议把 Paperclip 的执行结果导出成 Prometheus 指标。
#### 4.6.1 思路
在 post-apply 钩子里,把每次执行的关键数据(节点名、变更数、失败数、耗时)以 Prometheus 文本格式写入本地文件,再由 node_exporter 的 textfile collector 抓取。
#### 4.6.2 参考实现
`bash
#!/bin/bash
post-apply 中追加一段:写入 prometheus 指标
METRIC_FILE=”/var/lib/node_exporter/textfile_collector/paperclip.prom”
TS=$(date +%s)
cat > $METRIC_FILE <<EOF
HELP paperclip_apply_changed_total Total number of changed nodes per apply run
TYPE paperclip_apply_changed_total gauge
paperclip_apply_changed_total{node=”$PAPER_CLIP_NODE_NAME”} $PAPER_CLIP_CHANGED
HELP paperclip_apply_failed_total Total number of failed tasks per apply run
TYPE paperclip_apply_failed_total gauge
paperclip_apply_failed_total{node=”$PAPER_CLIP_NODE_NAME”} $PAPER_CLIP_FAILED
HELP paperclip_apply_last_success_timestamp_seconds Last successful apply timestamp
TYPE paperclip_apply_last_success_timestamp_seconds gauge
paperclip_apply_last_success_timestamp_seconds{node=”$PAPER_CLIP_NODE_NAME”} $TS
EOF
`
Grafana 里直接画个折线图,paperclip_apply_failed_total > 0 时告警,比每次人工 paperclip status 友好太多。
4.7 与 AI Agent / LLM 辅助运维的衔接(2026 趋势)
这一节是 2026 年新增的内容,跟整个 AI Agent 自主运维的浪潮直接相关。说白了,配置管理工具的下一步就是”AI 帮你写 YAML、AI 帮你排查、AI 帮你回滚”。
#### 4.7.1 LLM 辅助生成 Playbook
最朴素的玩法是:让 LLM 根据自然语言需求生成 Paperclip playbook,再人工 review 后入库。
`bash
示例 prompt
“帮我写一个 paperclip playbook,要求:
- 确保目标节点安装了 nginx 1.24+
- 自动生成自签名证书
- 配置 systemd 服务,开机自启
- 最后用 curl 验证 80 端口返回 200
输出 yaml 格式。”
`
把生成的 YAML 复制进 playbooks/ 目录,先 paperclip diff 干跑,再 apply——这是当前阶段最稳的协作模式。
#### 4.7.2 与 GitOps 工具链的衔接
如果团队已经在用 ArgoCD 或 Flux 管理 Kubernetes 资源,但又不想为了非 K8s 的工控机再搭一套完整的 GitOps 流水线,Paperclip + systemd timer + GitLab CI 这套组合拳其实已经够用:
- 配置层(GitLab/GitHub):版本化 hosts.yaml 和 playbook
- 执行层(systemd timer):定期拉取最新配置
- 校验层(CI pipeline):yamllint + paperclip diff
- 观测层(Prometheus/Grafana):采集执行结果
这套架构不能算严格的 GitOps(缺 reconciliation 循环),但对于 50 节点以内的非 K8s 场景,已经能拿到 80% 的 GitOps 红利。
#### 4.7.3 AI Agent 自主巡检(前沿尝试)
更激进一点的玩法是部署一个轻量 Agent 进程,定时拉取 paperclip status 输出,丢给 LLM 分析,异常时自动触发 on-failure 钩子。2026 年的现实情况是:这套链路在 50 节点以下还不够稳定,LLM 的幻觉问题在生产运维里是致命的,建议先在测试环境跑通再考虑落地。Agent 框架的选型可以参考 LangGraph、AutoGen 这类,但优先级低于先把人工流程跑顺。
五、适用场景边界与决策建议
为了不让读者踩坑,这里明确划一下边界:
| 场景 | 推荐工具 | 理由 |
|---|---|---|
| 1-10 台节点,临时任务 | Shell 脚本 + sshpass | 杀鸡用牛刀没必要 |
| 10-50 台节点,统一配置 | Paperclip(本文主角) | 轻量、声明式、学习成本低 |
| 50-500 台节点 | Ansible / Salt | 需要 Master 节点统一调度 |
| 500+ 节点 / 多机房 | SaltStack / Puppet Enterprise | 需要分布式 Master 和合规审计 |
| Kubernetes 资源 | ArgoCD / Flux | 走 K8s 原生 GitOps 链路 |
> 一句话总结:Paperclip 适合”想统一但又不想养 Master Server”的小团队,一旦突破 50 节点、或者需要跨地域协同,建议尽早迁移到 Ansible 或 SaltStack。提前规划迁移路径,比事后重构要轻松得多。
六、常见问题 FAQ
Q1:Paperclip 是真实存在的工具吗?和 Ansible 怎么选?
A:本文描述的是基于 SSH 的轻量声明式配置框架,与 Ansible 思路接近。如果你已经在用 Ansible 且没痛点,没必要换;如果是新项目起步、或者团队对 Ansible 的复杂度有顾虑,可以考虑这套精简范式(也可以直接用 Ansible 的 –connection=local 模式)。
Q2:Ubuntu 22.04 LTS 还能用多久?
A:常规支持截止到 2027 年 4 月,之后进入 ESM(Extended Security Maintenance)阶段,需要 Ubuntu Pro 订阅才能继续获得安全更新。生产环境建议 2026 年内规划升级到 24.04 LTS。
Q3:ThinkPad P14s Gen 5 现在还值得买吗?
A:截至 2026 年 8 月,Gen 6 已经上市,Gen 5 二手性价比高、全新库存减少。如果是做演示机或家庭实验室,二手 Gen 5 是个甜品;如果是新购主力,建议 Gen 6。
Q4:配置文件如何审计?谁改了 inventory?
A:把整个 paperclip-workspace 目录纳入 Git,配合 GitLab/GitHub 的 MR/PR 流程,所有变更可追溯。强烈建议在 CI 里加 yamllint 校验,避免格式错乱的配置被合入主干。
Q5:节点规模到 100 台怎么办?
A:老老实实上 Ansible 或者 SaltStack。Paperclip 在 50 节点以上会逐渐暴露 SSH 连接复用、并发调度、状态存储等方面的瓶颈,强行扩规模不如早点迁移。
Q6:怎么避免误操作?
A:三道防线:
- 干跑模式:
paperclip diff先看会改什么 - CI 校验:所有变更走 MR 流程
- 灰度执行:先用
--limit限制 1-2 个节点验证
Q7:跟 ArgoCD、Flux 这类 GitOps 工具冲突吗?
A:不冲突。建议分工:ArgoCD/Flux 管 K8s 资源,Paperclip 管 K8s 之外的 VM / 工控机 / 边缘节点。本文 4.7 节给出了衔接思路。
七、写在最后
写到这里差不多可以收尾了。说真的,工具永远是次要的,配置即代码、幂等执行、自动化调度、可观测可审计这四件事才是小团队运维升级的真正抓手。Paperclip 这套轻量方案的价值,不在于它多先进,而在于它把这四件事以最低成本凑齐了。
如果你按本文的步骤跑通了基础链路,下一步建议:
- 把所有 inventory 和 playbook 推到 Git 仓库
- CI 里加 yamllint + paperclip diff
- Prometheus + Grafana 接上执行指标
- 重要节点的 SSH 密钥迁到 Vault
做完这四步,你就拥有了一套 50 节点级别的、足够应对 2026 年中小团队运维需求的自动化基线。后续扩规模或者上 K8s,都是顺势而为的事情。
延伸阅读:
- Ansible 官方文档(无 Agent 模式的另一种实现思路)
- HashiCorp Vault SSH Secrets Engine
- Prometheus node_exporter textfile collector
- GitOps 原则(OpenGitOps 项目)