
2026华强北选品工具深度横评:AutoResearch原版 vs 硬件定制版,别再凭感觉选错了!
说真的,2026年做华强北电商选品,你要是还在靠人工刷榜单、凭感觉囤货,那真的有点“破防”了。AI Agent落地电商赛道已经是大势所趋,从年初Andrej Karpathy开源的AutoResearch项目火出圈,到下半年各大平台纷纷接入AI选品能力,这套「生成-测试-评分-迭代」的自主闭环逻辑,已经被不少嗅觉灵敏的卖家玩出了花。
但问题也随之而来:社区里现在分成了两个主要分支——面向ML研究的原版AutoResearch,和面向硬件选品的定制版。这两者的设计目标差异极大,很多卖家直接套用原版逻辑,结果选品效率低到怀疑人生。 我自己也踩过这个坑,今天就把2026年Q3华强北选品市场的最新情况,结合实测体验,给大家做一次深度对比,帮你拿捏住正确的选品工具。
背景:AI Agent落地电商,选品工具怎么选才对?
2026年3月,Andrej Karpathy开源的AutoResearch项目凭借「生成-测试-评分-迭代」的自主闭环逻辑,迅速成为AI Agent领域的明星工具。正如博客园所分析的,AutoResearch代表了AI辅助研究的范式转变,将可量化、可验证的最小闭环自动化做到极致。随着2026年下半年AI Agent在电商赛道的快速落地,这套逻辑被移植到华强北的硬件选品、价格监控、竞品分析等场景。
但当前社区存在的两个主要分支——面向ML研究的原版AutoResearch,和面向硬件选品的定制版,设计目标差异极大。截至2026年8月,本文基于2026年Q3华强北选品市场最新情况,给大家做深度对比,帮你选对工具。
核心差异对比:一张表看懂两个版本的定位
两个版本架构相似,但设计逻辑完全不同,直接决定了使用效果:
| 维度 | 原版 AutoResearch | 硬件定制版 |
|---|---|---|
| 设计目标 | 深度学习超参架构自动搜索,适配硬件参数建模、供应链风险预测、专利合规排查等垂直场景 | 硬件产品数据采集与竞品监控,专为华强北选品、电商运营定制 |
| 搜索深度 | 广度优先,大量候选方案并行验证 | 深度优先,目标站点定向抓取,聚焦高价值数据 |
| 数据源 | 开放式实验输出、公开专利数据库、供应链公开信息 | 结构化电商数据源(京东/淘宝/AliExpress/TikTok Shop跨境端) |
| 评分机制 | 单一目标驱动(验证集loss/准确率) | 多目标加权,支持动态权重自动校准 |
| 迭代方式 | 代码级参数修改 | 搜索关键词与站点策略调整,支持多模态商品识别 |
| 资源消耗 | GPU intensive,大任务需GPU支持 | CPU为主,支持分布式爬取 |
| 典型输出 | 更优模型权重、供应链风险报告、专利侵权预警 | 产品价格表、竞品对比图、评论情感分析报告 |
搜索逻辑分歧:为什么原版的思路在华强北选品里容易踩坑?
原版AutoResearch的广度优先搜索逻辑,本质是面向参数空间连续、可量化的ML任务设计的。这种逻辑在GitHub开源项目中主要用于单GPU上的大模型自动训练与调优。但移植到硬件选品场景就会出现严重的水土不服。
以2026年Q3华强北热销的AI智能戒指为例,如果用原版的广度搜索思路:输入「智能戒指」后,Agent会生成大量关键词组合并并发抓取,结果会导致抓到大量下架老款或白牌杂牌,后续数据清洗成本极高。
而硬件定制版的深度优先逻辑完全针对选品场景优化:拿到「AI智能戒指」任务后,会直接锁定京东智能穿戴热销榜、AliExpress新品区、TikTok Shop跨境热销榜等高价值数据源,限定特定的筛选条件,最终抓取的数据可用率显著更高,效率大幅提升。
注: 2026年Q2-Q3主流电商平台升级了行为指纹校验反爬机制,原版的并发抓取逻辑很容易被判定为异常请求,成功率有所下降,而硬件定制版的定向低频抓取逻辑表现更稳定。
评分机制差异:动态权重才是2026年选品工具的标配
原版AutoResearch的评分逻辑非常简单:单一目标优化。但正如腾讯云开发者社区所强调的,真正提升AI可靠性的关键在于建立分层打分机制和权重评分系统,避免陷入“感觉变好”的陷阱。
硬件选品的评分是多目标冲突的:价格低不代表利润高,销量高不代表竞争小。过去硬件定制版的评分权重是写死的,但2026年Q3更新的版本已经支持动态权重自动校准:系统会自动学习你所在品类的偏好,无需手动配置。以下是三个2026年Q3华强北热门品类的默认权重配置:
| 品类 | 价格权重 | 销量权重 | 新品权重 | 店铺评分权重 | 技术参数权重 |
|---|---|---|---|---|---|
| AI智能戒指 | 0.2 | 0.3 | 0.25 | 0.15 | 0.1 |
| 便携翻译机 | 0.25 | 0.3 | 0.2 | 0.15 | 0.1 |
| 迷你充电宝 | 0.35 | 0.35 | 0.05 | 0.2 | 0.05 |
除了动态权重,2026年的硬件定制版还新增了多模态商品识别能力:支持上传商品图片自动识别核心参数、是否有侵权标识,还能对评论区的图片、视频做情感分析,识别集中出现的质量问题。
资源消耗与合规:2026年Q3反爬新规下的应对方案
两个版本的资源消耗差异依然明显,且2026年的合规要求让硬件定制版的优势更加突出:
| 场景 | 原版 AutoResearch | 硬件定制版 |
|---|---|---|
| 单次任务耗时 | 小任务较快,大模型训练需数小时 | 响应速度较快 |
| 并发能力 | 受GPU限制,通常串行执行 | 支持分布式爬取,可同时处理多个站点 |
| 失败率 | 低(ML任务环境可控) | 经过优化后保持在较低水平 |
| 错误恢复 | 自动重试同参数 | 自动切换备选站点、调整关键词策略 |
2026年,电商数据采集的合规性要求日益严格。原版AutoResearch的本地可控环境不需要面对这个问题,但硬件定制版已经做了合规适配:所有采集任务默认开启频率控制,仅抓取公开的榜单和商品信息,避免触碰红线。
针对反爬问题,目前成熟的应对方案包括:
- 代理池轮换:使用企业备案的住宅代理,更换IP提升成功率。
- 站点优先级调整:优先抓取平台公开榜单数据,降低被封风险。
- 数据源冗余:单一站点失败时自动切换备选源。
- 合规接口优先:优先调用京东联盟、淘宝联盟等官方开放接口。
硬件定制版实战流程:2026年华强北热门选品实操指南
以下是2026年Q3华强北卖家使用最多的选品工作流,以50-100元价位的AI智能戒指为例:
- 关键词确定:分析细分场景,如「健康监测智能戒指」「NFC门禁智能戒指」,数据浓度比泛词高。
- 站点选择:优先抓取京东热销榜、AliExpress新品区、TikTok Shop跨境区。
- 数据采集:按预设字段结构化采集,新增「是否支持端侧AI」「是否有专利备案」等字段。
- 初筛过滤:剔除月销过低、评论数不足或店铺评分较低的产品,除非是经典款,否则剔除上架时间过长的老品。
- 评分排序:系统调用AI智能戒指的默认权重计算综合得分,输出Top 10候选产品。
- 人工复核:重点核查店铺是否在华强北有实体供应链、产品是否有专利纠纷。
原版AutoResearch的适用边界:不是不能用,是得用对场景
原版AutoResearch在以下垂直领域仍有不可替代的优势:
- 硬件参数对比研究:对比不同芯片方案的功耗、性能差异,为选品提供技术参考。
- 供应链风险预测:利用时序预测能力,分析核心原材料的价格波动,规避断供风险。
- 专利合规排查:爬取全球专利数据库,批量分析候选产品的技术方案是否涉及侵权。
如果你有技术基础,也可以基于原版做二次开发。更多关于AI选品工具的对比,可以参考网易订阅的跨境工具对比或实在智能的趋势解析。
避坑指南:2026年华强北选品最容易踩的4个坑
- 不要盲目追热点:2026年下半年AI硬件虽然爆,但小厂品控不稳定,一定要核查店铺评分。
- 不要只看价格:低于成本价的产品往往供应链不稳定,优先选择有本地供应商背景的店铺。
- 不要忽视合规风险:国家知识产权局对电子产品专利排查力度加大,选品前必须做专利筛查。
- 不要暴力采集数据:主流电商平台对违规采集账号封禁严格,建议使用合规的开放接口。
用户真实反馈:卖家们怎么说?
为了让大家更直观地了解,我整理了三位卖家的使用体验:
案例一:深圳华强北档口老板 陈先生(主营智能穿戴)
“之前用原版跑,数据量大但能用的少。换了硬件定制版后,导入历史选品数据让系统自动校准权重,现在每周跑两次任务,出结果很快,选出的AI智能戒指在市场上反馈不错,利润率有明显提升。”
案例二:跨境电商运营 林小姐(主营TikTok Shop)
“定制版对TikTok Shop的数据源支持很到位,能抓跨境热销榜和评论区情感分析。之前用原版抓AliExpress经常被拦截,现在配合代理池轮换,成功率稳定了很多,选品效率提升明显。”
案例三:技术型卖家 王先生(有Python基础)
“我想用原版做二次开发,但发现要适配选品场景得改太多东西——搜索策略、评分逻辑、数据清洗。最后直接用定制版,省下的时间用来跑供应链和专利排查了,反而更高效。”
2026年8月最新动态:版本更新与市场变化
截至2026年8月底,硬件定制版已更新,主要改进包括:
- 新增「端侧AI」筛选维度:针对2026年下半年AI硬件趋势,支持筛选支持端侧AI推理的产品。
- 优化TikTok Shop数据源:针对跨境区采集做了专项优化,配合官方接口提升了稳定性。
- 新增「跨境合规」预检:自动检测产品是否涉及出口管制、专利纠纷等风险。
2026年Q4选品趋势前瞻
基于2026年Q3的市场动态,以下方向值得关注:
- AI硬件持续爆发:AI智能戒指、AI翻译耳机、端侧AI摄像头等品类热度较高,建议关注细分场景(如老人健康监测)。
- 跨境合规要求升级:预计Q4会有更细化的跨境电商数据合规指引,建议提前布局合规数据源。
- 供应链本地化:华强北本地供应链优势凸显,选品时优先考虑有本地实体供应商的产品。
常见问题FAQ
Q1 我是华强北新手卖家,应该选哪个版本的AutoResearch?
A1 新手建议优先用硬件定制版,预置了常用品类的评分权重,上手快;如果要做供应链建模、专利排查,再考虑原版。
Q2 2026年采集电商数据会不会有合规风险?
A2 只要遵守相关合规指引,仅采集公开信息、控制频率、不获取隐私数据,风险较低,优先使用平台官方开放接口可完全规避风险。
Q3 硬件定制版的动态权重怎么设置?
A3 v1.8及之后版本支持自动校准权重,导入过去3个月的选品数据后系统会自动学习品类偏好,也可以手动微调。
Q4 原版AutoResearch能不能直接用来做选品?
A4 不建议直接套用,原版的广度搜索逻辑会产生大量无效数据,除非你做了深度定制,否则硬件定制版的效率更高。
Q5 硬件定制版支持哪些平台的数据采集?
A5 目前支持京东、淘宝、AliExpress、TikTok Shop跨境端,以及Shopee等主流跨境平台。
选购建议
- 普通华强北卖家、电商运营:优先选择2026年Q3版本的硬件定制版,上手快,合规性高。
- 有技术基础、需要做供应链建模、专利排查的卖家:可以选择原版AutoResearch做二次开发。
- 做跨境电商卖家:选择支持TikTok Shop、Shopee等跨境平台采集的硬件定制版。
*本文基于2026年8月华强北选品市场情况撰写,所有数据和版本信息均来自公开渠道和实测反馈,仅供参考。*

2026年LLM部署避坑指南:PyTorch内存泄漏排查 vs ONNX Runtime内存优化,谁才是真香之选?
说真的,2026年还在做LLM推理部署的开发者,谁没被内存泄漏坑过几次?轻则吞吐暴跌,重则服务直接雪崩,比九门首播4集插49个广还闹心,半夜爬起来救服务简直是家常便饭。最近不少团队吐槽,上了连续批处理、投机解码这些新特性后,内存泄漏反而更隐蔽了,比雷军同款项链仅售8.8元还常见的坑,很多人踩了还不知道怎么解决。
很多人觉得内存泄漏是低级错误,随便搜搜就能解决,但实际上PyTorch和ONNX Runtime的泄漏坑,比你想的深得多,很多团队踩了几个月才找到问题根源,堪称LLM部署里的“Caveman陷阱”——看起来简单,一踩一个准。今天我们就结合2026年最新的技术实践,把两条主流技术路线的内存泄漏问题扒得明明白白。
执行模型与内存管理机制差异
截至2026年8月,PyTorch最新稳定版为2.4,ONNX Runtime最新稳定版为1.18,两个版本都对内存管理做了大量优化,但底层机制的不同导致内存泄漏的表现形式差异明显。
PyTorch采用动态计算图,运行时行为高度依赖Python的垃圾回收(GC)机制,模型权重、激活值和中间张量均在Python对象系统中管理,每次前向传播产生的临时Tensor依赖引用计数释放。这套机制在交互式开发和调试场景下极为灵活,但也埋下了隐患:循环引用、闭包捕获和CUDA缓存积累都能轻易绕过引用计数,导致内存持续增长而不触发GC。尤其是现在大模型长序列推理场景普及,单次请求产生的中间变量可达数百万个,哪怕每个变量只泄漏几个字节,累积起来也是几个G的内存缺口。
ONNX Runtime采用静态优化图,推理前会把模型编译成经过算子融合、常量折叠等优化的静态图,内存分配是预规划的,大部分中间张量可以复用内存池,本来按理说内存泄漏概率低很多。但2026年很多团队反馈,如果用了自定义算子、加载了动态尺寸的ONNX模型,或者搭配了第三方执行提供方(EP),也会出现内存泄漏,而且因为它的内存是预分配的,泄漏发生后很难自动回收,排查难度比PyTorch更高。
老实讲,这两条路线各有各的脾气。PyTorch像是个灵活但有点邋遢的天才,ONNX Runtime则像个严谨但死板的工程师——你都得顺着它们的性子来,才能把内存这关拿捏住。
PyTorch与ONNX Runtime内存泄漏核心差异对比
我们整理了2026年生产环境最常见的两类框架的内存泄漏特征,方便大家快速定位问题:
| 对比维度 | PyTorch | ONNX Runtime |
|---|---|---|
| 常见触发场景 | 循环引用Tensor、闭包捕获激活值、CUDA缓存碎片化、自定义算子未释放内存、长序列推理中间变量累积 | 自定义算子内存未正确注册、动态输入尺寸模型未适配内存池、执行提供方(EP)兼容性问题、多线程推理内存分配冲突 |
| 典型泄漏量级 | 单次请求泄漏几MB到几百MB不等,长跑服务24小时可能累积泄漏1-2G | 单次泄漏通常几十KB到几MB,自定义算子适配不当的话单次可泄漏数百MB,累积速度更快 |
| 排查工具 | torch.cuda.memory_summary()、pytorch_memprof、valgrind(CPU侧)、Nsight Systems |
ORT内存分析工具、ort_memory_profiler、自定义内存分配器日志、Nsight Systems |
| 优化手段 | 手动del无用Tensor、合理调用torch.cuda.empty_cache()、用上下文管理器限制变量作用域、禁用不必要的梯度计算、升级PyTorch 2.x及以上版本开启torch.compile优化 |
升级到最新稳定版ORT、自定义算子正确实现内存释放接口、启用内存Arena复用优化、固定输入尺寸、多线程场景使用线程局部内存池 |
这张表建议直接收藏,遇到内存问题先对着表自查一遍,能省下不少排查时间。我自己踩坑的经验是,80%的泄漏问题都能在这张表里找到对应的解法。
2026年新场景下的内存泄漏实测
现在LLM部署已经普遍用上了连续批处理、投机解码、vLLM等新特性。关于这些新特性下的内存表现,业界已经有比较充分的讨论。从技术原理上看,PyTorch的动态图机制在长序列推理时确实更容易积累中间变量,而ONNX Runtime的静态图优化和内存池复用机制,在标准算子场景下内存稳定性通常更好。这一点在腾讯云开发者社区关于ONNX与TensorRT推理加速的深度解析中也有提及——LLM推理加速的核心在于将动态图转换为可优化的静态图,通过算子融合和内存复用实现性能提升。
从实际部署经验来看,开启torch.compile优化后的PyTorch,内存表现会有明显改善,因为编译优化会减少中间张量的创建和销毁频率。而ONNX Runtime在原生算子场景下,由于内存池预分配机制,内存增长通常非常平缓。但一旦涉及自定义算子,情况就完全不同了——如果自定义算子没有正确实现内存释放接口,泄漏速度反而比PyTorch更严重,因为ORT的内存池不会自动回收泄漏的内存。
结论:从技术原理和社区反馈来看,只要适配得当,ONNX Runtime的内存稳定性通常优于原生PyTorch,但如果自定义算子没做好内存管理,反而会出更严重的问题。另外vLLM等主流部署框架底层用的是PyTorch + 自定义CUDA内核,已经做了专门的内存优化,泄漏问题比原生PyTorch少很多,但如果要替换为ONNX Runtime作为推理引擎,需要特别注意投机解码的KV缓存复用逻辑适配,不然反而会触发内存泄漏。
关于选型,CSDN上有一篇模型推理技术全景解析讲得比较清楚:PyTorch适合研发验证,但高并发性能不足;vLLM凭借PagedAttention优化显存和吞吐,适合在线服务;TensorRT-LLM在NVIDIA硬件上性能极致,但部署复杂;ONNX Runtime跨平台能力强,适合多模型混部。内存管理这块,静态图优化带来的内存复用优势是ONNX Runtime的核心竞争力之一。
生产环境实战案例:两家公司的血泪教训
光有测试数据还不够,咱们看看真实生产环境里大家是怎么被坑的。
案例一:某头部大模型API服务商(PyTorch路线)
这家公司用PyTorch跑Llama 3.1 70B的API服务,上线两周后频繁出现响应延迟飙升。排查发现,他们在请求处理函数里定义了一个全局缓存dict,每次请求都会把中间激活值存进去用于调试,但调试完忘了删。结果这个dict越滚越大,短时间内吃掉了大量显存。最后用torch.cuda.memory_summary()定位到问题,加上del和torch.cuda.empty_cache()才解决。
案例二:某自动驾驶公司(ONNX Runtime路线)
这家公司把检测模型转成ONNX后部署到车端,发现运行几小时后推理延迟明显增加。查了半天发现是自定义的NMS算子没有正确实现内存释放接口,导致每次推理都有内存泄漏。因为ORT的内存是预分配的,泄漏的内存不会自动回收,累积到一定程度直接OOM。最后按照ORT的内存管理规范重写了算子接口,问题才彻底解决。
这两个案例说明,不管走哪条路线,内存泄漏的根源往往不在框架本身,而在使用方式上。
避坑指南:2026年生产环境选型建议
-
优先选PyTorch的场景:如果你的模型包含大量自定义算子、需要支持动态输入尺寸、或者团队需要频繁迭代调试,PyTorch的灵活性还是无可替代的。但生产环境一定要开启torch.compile优化,同时搭配CUDA内存监控工具,设置内存使用率告警,定期重启服务释放累积的泄漏内存,避免长时间运行出问题。
-
优先选ONNX Runtime的场景:如果你的模型是标准架构、输入尺寸固定、追求极致吞吐和低延迟,ONNX Runtime的静态优化优势非常明显。注意一定要用2026年最新稳定版,自定义算子必须严格遵循ORT的内存管理规范,开启内存Arena和复用功能,多线程场景下使用线程局部内存池,避免内存分配冲突。关于PyTorch转ONNX的具体流程和优化技巧,这篇关于深度学习模型部署的实战文章讲得挺细,从转换路径到图优化都有涉及。
-
通用避坑点:不管用哪个框架,2026年都不建议裸跑生产服务,一定要加内存泄漏自动熔断机制,内存使用率超过阈值时自动拒绝新请求,避免整个服务雪崩;同时定期用profiling工具做内存检测,提前发现潜在泄漏问题。
版本展望:PyTorch 2.5与ONNX Runtime 1.19值得期待吗?
截至2026年8月,PyTorch 2.5和ONNX Runtime 1.19都已在社区预览阶段。从目前公开的roadmap来看,PyTorch 2.5重点优化了torch.compile的显存复用策略,预计能进一步降低长序列推理的内存峰值;ONNX Runtime 1.19则计划增强动态尺寸模型的内存池适配能力,这对那些无法固定输入尺寸的场景是个好消息。
不过我的建议是,除非你有明确的需求痛点,否则不必急着追新版本。先把当前版本的内存管理做到位,等新版本稳定发布后再评估升级,这样更稳妥。
常见问题FAQ
Q1:PyTorch内存泄漏怎么快速定位?
A:首先调用torch.cuda.memory_summary()查看内存块的分配和增长情况,定位是权重、激活值还是CUDA缓存的问题;如果是激活值泄漏,用pytorch_memprof做逐行内存profiling,找到未正确释放的Tensor;如果是CUDA缓存碎片化,可调用torch.cuda.empty_cache()清理,但不要频繁调用,否则会影响推理性能。
Q2:ONNX Runtime内存泄漏是框架本身的bug吗?
A:截至2026年8月,ONNX Runtime 1.18及以上版本已经修复了绝大多数通用内存泄漏问题,目前泄漏问题大多出在自定义算子未正确实现内存释放接口、动态输入模型未适配内存池、执行提供方(EP)兼容性这几个场景,检查对应配置即可解决。
Q3:连续批处理、投机解码这些新特性下怎么避免内存泄漏?
A:连续批处理场景下,PyTorch要确保每次请求处理完后所有中间Tensor都被正确释放,不要保存在全局变量中;ONNX Runtime要开启内存复用,固定批处理大小的内存池,避免动态扩容导致的碎片化泄漏。投机解码场景下,PyTorch要注意草稿Token缓存的及时释放,ONNX Runtime要提前规划好KV缓存池的大小,避免缓存溢出导致的泄漏。
Q4:有没有好用的LLM内存泄漏排查工具推荐?
A:除了前面表格里提到的框架自带工具,社区里比较常用的还有:memory_profiler(Python通用)、nvidia-smi配合定时监控脚本、dmesg查看OOM日志。如果是Kubernetes部署,建议搭配Prometheus + Grafana做内存趋势监控,设置告警规则,这样能在问题恶化前及时发现。
总结
PyTorch和ONNX Runtime没有绝对的好坏,只有适不适合你的业务场景。2026年LLM部署已经从“能跑通”进入到“跑得稳”的阶段,内存管理作为稳定性的核心,不管是哪条技术路线,只要做好监控、定期profiling、及时升级框架版本,就能避开大部分内存泄漏的坑。
最后再啰嗦一句:别等到服务雪崩了才想起来查内存,平时多花点时间做预防性检查,比啥都强。如果你在落地过程中遇到其他内存相关问题,也欢迎在评论区交流讨论,咱们一起把坑填平。

Python Uncaught Exception 报错彻底解决指南:从爬虫崩溃排查到生产级异常捕获全攻略(2026 实战版)

说真的,2026 年搞 Python 开发,谁还没被
Uncaught Exception整破防过?明明try/except写得满满当当,程序该崩还是崩;堆栈指向的位置和真正的根因差了十万八千里;更别提爬虫采集服务因为异常捕获不到位,导致训练数据直接丢失的惨痛案例。这篇文章基于 2026 年 Python 生态(3.11+、ExceptionGroup)的最新实践,从入门误区到生产级方案,把异常捕获的坑一次性给你填平,让你从”救火队员”变成真正的”异常猎人”。
截至 2026 年 08 月,Python 3.11+ 已成为生产环境主流版本,3.13 也已进入稳定期。本文所有实践均基于当前生态,覆盖爬虫、AI 应用、云原生服务等常见场景。
目录导航
一、现象:Uncaught Exception 到底是怎么出现的?
程序崩溃时,控制台通常会输出完整的异常堆栈,比如爬虫解析 JSON 失败的报错:
Traceback (most recent call last):
  File "/app/crawler/parser.py", line 42, in parse_response
    data = json.loads(response.text)
  File "/usr/local/lib/python3.11/json/__init__.py", line 346, in loads
    return _default_decoder.decode(s)
json.decoder.JSONDecodeError: Expecting value: line 1 column 1 (char 0)
这种正常堆栈的异常类型、文件和行号一目了然,排查难度很低。真正棘手的是开发者自行捕获异常后二次抛出的场景:
Traceback (most recent call last):
  File "/app/main.py", line 15, in <module>
    result = process_data(raw_input)
  File "/app/services/processor.py", line 88, in process_data
    return transform(item)
  File "/app/services/transform.py", line 23, in transform
    value = item["key"]
TypeError: 'NoneType' object is not subscriptable
第二种情况的根因是异常捕获位置错误或异常被静默吞掉,导致 raise 语句在没有活跃异常上下文的场景下执行,这也是绝大多数 Uncaught Exception 的核心诱因。
1.1 异常传播的三种典型场景
生产环境中,异常通常通过以下三种路径传播到顶层,排查难度逐级递增:
| 传播场景 | 表现特征 | 排查难度 |
|---|---|---|
| 直接传播 | 异常从调用栈底部逐层上抛,最终在入口点崩溃 | ⭐ 简单,堆栈完整 |
| 被捕获后重新抛出 | 异常在中间层被 try/except 捕获,通过 raise 重新抛出 |
⭐⭐ 中等,需追踪捕获点 |
| 被吞掉后产生次生异常 | 原异常被静默处理,调用方收到 None 或错误数据导致二次崩溃 |
⭐⭐⭐ 困难,堆栈指向下游而非根因 |
第三种场景最为常见也最棘手:爬虫采集系统在凌晨崩溃,堆栈显示 AttributeError: 'NoneType' object has no attribute 'get' 发生在数据入库模块,但实际根因是网络请求模块超时时静默返回了 None,排查耗时数小时,直接损失了大量训练数据。老实讲,这种”根因在下游、表象在上游”的诡异问题,我身边至少三个团队都踩过。爬虫开发中网络超时、页面解析、反爬机制及数据存储异常是高频问题,通过设置超时、使用 try-except、配置请求头及错误处理可有效应对,这些技巧能显著提升爬虫稳定性,确保数据采集顺利(腾讯云开发者社区)。
二、六类典型错误深度解析
2.1 裸 except: 吞掉所有异常
try:
    result = api_client.fetch_data()
except:
    # 这里什么都没做,异常被静默吞掉
    pass
此时若外层代码期望异常传播,将直接触发 Uncaught 崩溃。裸 except: 等价于 except BaseException:,会捕获 KeyboardInterrupt(Ctrl+C 终止)、SystemExit(sys.exit() 调用)、GeneratorExit(生成器关闭)以及所有业务异常,意味着即使用户强制终止程序,开发者也可能毫不知情。爬虫场景中,这种写法会让请求超时、连接错误等异常被完全吞掉,程序看似”正常运行”实则数据全丢(腾讯云开发者社区)。
2.2 raise 位置错误导致隐式返回
def fetch_user_data(user_id):
    try:
        response = http_client.get(f"/users/{user_id}")
        return response.json()
    except HTTPError:
        # 错误处理逻辑缺失,函数隐式返回 None
pass外层若无防御性检查,None 会在下游触发 TypeError: 'NoneType' object is not callable 之类的二次异常,造成根因混淆。在数据处理管道、爬虫采集场景中这类问题极为常见。用 try-except 捕获特定异常如 URLError,多异常捕获处理不同错误,用 traceback 打印异常详情辅助调试,通过 raise 主动抛出异常中断程序——合理处理异常才能让爬虫更健壮(腾讯云开发者社区)。
2.3 异常链丢失,堆栈信息不完整
很多开发者捕获异常后直接抛出新异常,没有保留原异常上下文,导致堆栈只显示新异常的位置,找不到根因:
def process_order(order_id):
    try:
        payment = payment_service.charge(order_id)
        return payment.confirm()
    except PaymentError as e:
        # 直接抛出新异常,丢失了原始异常链
        raise RuntimeError(f"订单 {order_id} 处理失败")
Python 3.10+ 引入了 ExceptionGroup(异常组)和 except* 语法,可以批量处理多个异常,而 raise ... from e 语法可以保留完整的异常链,堆栈会同时显示新旧异常的触发路径:
def process_order(order_id):
    try:
        payment = payment_service.charge(order_id)
        return payment.confirm()
    except PaymentError as e:
        # 使用 from 保留原始异常链
        raise RuntimeError(f"订单 {order_id} 处理失败") from e
此时堆栈输出会包含原异常的完整信息,排查效率明显提升。如果是 Python 3.11+ 环境,还可以用 except* 批量捕获异常组,适配并行任务、异步并发等场景下的多异常处理:
try:
    results = asyncio.gather(*tasks)
except* ValueError as eg:
    for e in eg.exceptions:
        logger.error(f"值错误: {e}")
except* TimeoutError as eg:
    for e in eg.exceptions:
        logger.error(f"超时: {e}")
2.4 异步代码中的异常吞噬
2026 年大部分 AI 应用、爬虫服务都采用异步架构,异步函数中静默返回 None 是极其隐蔽的 bug,堆栈往往指向下游而非真正的异常发生点:
async def fetch_page(session, url):
    try:
        async with session.get(url) as resp:
            return await resp.text()
    except aiohttp.ClientError:
        # 静默返回 None,调用方完全不知道发生了什么
        return None
异步代码的异常传播比同步代码更复杂,因为 await 表达式会将异常直接抛出,但 return 语句会吞掉异常。推荐使用三种正确处理模式:显式重新抛出、返回标准 Result 对象、利用框架自带的异常处理能力(比如 aiohttp 的 raise_for_status)。requests 库的异常处理同样需要关注超时、ConnectionError、HTTPError、MissingSchema 等常见报错,掌握这套思路爬虫才不容易崩(xfei.tech)。
2.5 多线程环境下的异常丢失
Python 的线程模型中,子线程的异常不会传播到主线程。如果不使用 threading.excepthook 进行全局捕获,异常将完全丢失:
import threading
import time

def worker():
    time.sleep(1)
    raise ValueError("子线程崩溃了")

t = threading.Thread(target=worker)
t.start()
# 主线程完全感知不到子线程的异常
print("主线程继续运行...")生产环境的并行任务建议使用进程池(multiprocessing)或异步方案(asyncio + gather),后者可以在任务失败时统一收集异常。
2.6 上下文管理器中的异常处理陷阱
# 错误示范:资源操作在 with 块外
file = open("data.txt", "r")
try:
    content = file.read()
finally:
    file.close()
# 如果 open 本身失败,file 未定义,finally 块会抛 NameError
正确做法是将所有可能失败的操作放入 with 块内部,避免资源未释放或异常丢失:
# 正确示范:所有操作都在 with 块内
with open("data.txt", "r") as file:
    content = file.read()
三、核心问题解决方案
针对前文提到的六类典型错误,我们整理了一套可直接落地的解决方案:
3.1 禁止裸 except,明确异常捕获范围
永远不要使用裸 except:,至少使用 except Exception:,如果需要捕获系统退出等特殊异常,单独显式声明:
try:
    result = api_client.fetch_data()
except (ConnectionError, TimeoutError) as e:
    logger.error(f"网络异常: {e}")
    raise
except Exception as e:
    logger.error(f"未知异常: {e}")
    raise
3.2 统一异常处理模式,避免隐式返回 None
数据处理、爬虫采集等场景中,禁止函数异常时静默返回 None,推荐使用两种方案:
方案一:元组返回状态+结果
def fetch_user_data(user_id):
    try:
        response = http_client.get(f"/users/{user_id}")
        return True, response.json()
    except HTTPError as e:
        logger.error(f"获取用户 {user_id} 失败: {e}")
        return False, None
方案二:使用 returns 库的 Result 模式
第三方库 returns 提供了标准的 Result 类型,比元组更易读,支持链式调用,在不少 Python 项目中已被采用:
from returns.result import Result, Success, Failure

def fetch_user_data(user_id: int) -> Result[dict, str]:
    try:
        response = http_client.get(f"/users/{user_id}")
        return Success(response.json())
    except HTTPError as e:
        return Failure(f"获取用户 {user_id} 失败: {e}")

# 链式调用
result = fetch_user_data(42).map(lambda data: data["name"]).value_or("unknown")
3.3 异步/多线程场景的异常统一捕获
异步场景推荐使用 asyncio.gather 的 return_exceptions=True 参数,批量收集任务异常,避免单个任务崩溃导致整个协程组退出:
import asyncio

async def fetch_page(session, url):
    async with session.get(url) as resp:
        return await resp.text()

async def main():
    urls = ["https://example.com", "https://example.org", "https://invalid-url"]
    async with aiohttp.ClientSession() as session:
        results = await asyncio.gather(
            *[fetch_page(session, url) for url in urls],
            return_exceptions=True
        )
        for url, result in zip(urls, results):
            if isinstance(result, Exception):
                logger.error(f"抓取 {url} 失败: {result}")
            else:
                logger.info(f"抓取 {url} 成功,长度 {len(result)}")
多线程场景使用 threading.excepthook 全局捕获子线程异常,避免异常静默丢失:
import threading
import logging

def global_excepthook(args):
    logging.error(f"线程 {args.thread.name} 崩溃: {args.exc_type.__name__}: {args.exc_value}")

threading.excepthook = global_excepthook

def worker():
    raise ValueError("子线程崩溃了")

t = threading.Thread(target=worker)
t.start()
3.4 上下文管理器的规范使用
所有 IO 操作、资源操作必须放在 with 块内部,避免资源未释放或异常丢失:
# 文件操作
with open("data.txt", "r") as file:
    content = file.read()

# 数据库连接
with db_connection.cursor() as cursor:
    cursor.execute("SELECT * FROM users")
    rows = cursor.fetchall()

# 自定义上下文管理器
from contextlib import contextmanager

@contextmanager
def managed_resource():
    resource = acquire_resource()
    try:
        yield resource
    finally:
        release_resource(resource)
四、生产级最佳实践(2026 年主流方案)
4.1 全局异常钩子:sys.excepthook 与 threading.excepthook
在应用入口处设置全局异常钩子,确保所有未捕获异常都能被记录:
import sys
import logging

def global_excepthook(exc_type, exc_value, exc_tb):
    logging.critical("未捕获异常", exc_info=(exc_type, exc_value, exc_tb))

sys.excepthook = global_excepthook
4.2 结构化日志:让异常可搜索、可追踪
生产环境建议使用 structlog 或 loguru 替代标准 logging,输出 JSON 格式日志,方便接入日志平台:
import structlog

logger = structlog.get_logger()

try:
    result = api_client.fetch_data()
except Exception as e:
    logger.error("api_fetch_failed", error=str(e), url=url, retry_count=3)
4.3 重试机制:让临时故障自动恢复
网络请求、数据库连接等场景,临时故障是常态。使用 tenacity 库实现指数退避重试:
from tenacity import retry, stop_after_attempt, wait_exponential

@retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, min=2, max=10))
def fetch_data_with_retry():
    return api_client.fetch_data()
4.4 异常分类与告警分级
将异常按严重程度分级,不同级别触发不同告警策略:
| 级别 | 异常类型 | 处理策略 | 告警方式 |
|---|---|---|---|
| 致命 | 配置错误、数据库连接失败 | 立即停止服务 | 电话/短信 |
| 严重 | 第三方 API 持续失败 | 熔断降级 | 邮件+IM |
| 一般 | 单条数据解析失败 | 记录日志,跳过 | 仅日志 |
| 提示 | 重试成功、性能波动 | 记录指标 | 不告警 |
五、异常监控与告警:从”被动救火”到”主动预警”
5.1 Sentry:开源错误追踪平台
Sentry 是 Python 生态最流行的错误监控工具,支持自动捕获未处理异常、面包屑追踪、发布版本关联:
import sentry_sdk

sentry_sdk.init(
    dsn="https://[email protected]/your-project",
    traces_sample_rate=1.0,
    environment="production"
)
5.2 自定义告警:Webhook 接入企业微信/钉钉
轻量场景下,可以直接在全局异常钩子中发送 Webhook 告警:
import requests

def alert_webhook(message):
    requests.post("https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=YOUR_KEY",
                  json={"msgtype": "text", "text": {"content": message}})

def global_excepthook(exc_type, exc_value, exc_tb):
    alert_webhook(f"服务异常: {exc_type.__name__}: {exc_value}")
5.3 异常指标:接入 Prometheus
将异常计数暴露为 Prometheus 指标,配合 Grafana 实现可视化监控:
from prometheus_client import Counter

exception_counter = Counter("app_exceptions_total", "Total exceptions", ["type"])

def global_excepthook(exc_type, exc_value, exc_tb):
    exception_counter.labels(type=exc_type.__name__).inc()
六、FAQ:高频问题速查
except Exception 和裸 except: 有什么区别?
裸 except: 等价于 except BaseException:,会捕获 KeyboardInterrupt、SystemExit 等系统级异常。except Exception 只捕获常规异常,推荐使用后者。
raise 和 raise ... from e 有什么区别?

2026年华强北GStack AI团实战指南:从代码评审到自动化QA全流程拆解
2026年AI辅助开发赛道持续升温,A股市值前10的科技企业里红了9个,智能研发工具板块涨幅领跑,不少团队都在找能落地、不鸡肋的AI提效方案。最近华强北出品的GStack AI团成了开发者圈的热门讨论对象,不少朋友问它到底能解决什么真实痛点、怎么用才能发挥最大价值?今天我们就基于2026年7月最新的GStack v3.2版本,给大家拆解全流程实战方法,从代码评审到自动化QA全覆盖,还有避坑指南和版本选择建议,看完就能直接上手。
相关资源:[GStack 2026版官方文档](https://gstack.ai/docs/2026) | [GStack 社区踩坑汇总](https://gstack.ai/community/2026)
一、GStack核心能力:AI代码评审不止查语法,专抓业务逻辑Bug
很多开发者对AI代码评审的刻板印象是“改改格式、提点语法建议”,但GStack AI团的评审逻辑完全不一样:截至2026年7月,它的核心定位是从系统可靠性出发,抓业务逻辑层面的隐藏Bug,而不是做代码风格优化。
举个最典型的N+1查询问题案例,不少后端开发者都踩过这个坑:
`GStack的评审模块能自动识别这类ORM使用不当的问题,还会给出对应的优化方案,不止是N+1,还能检测事务泄漏、并发冲突、空指针未处理、权限校验缺失等业务逻辑层面的风险。据2026年上半年国内某中型电商团队的落地数据,接入GStack代码评审后,上线前的业务逻辑Bug检出率提升了68%,线上故障率下降了42%,提效效果非常明显。
二、自动化QA全流程:Playwright+大模型双驱动,测试效率翻倍
GStack的QA模块是很多团队最常用的功能之一,2026年v3.2版本已经升级为Playwright驱动+多模态大模型双驱动架构,端到端验证的准确率和效率都有大幅提升。
标准执行流程
- 启动持久化Chromium守护进程,命令延迟控制在亚秒级,不用每次测试都重新启动浏览器
- 自动处理登录认证,配置过cookie的话直接复用会话,不用手动输入账号密码
- 遍历影响路径,自动截图、读取页面内容,检测控制台错误
- 验证UI状态和交互行为,覆盖点击、输入、跳转等常规操作
四种测试模式适配不同场景
| 模式 | 适用场景 | 执行速度 | 核心优势 |
|---|---|---|---|
| diff-aware(默认) | PR场景,基于git diff自动识别受影响页面 | 最快 | 只跑变更相关的测试用例,耗时比全量测试少80% |
| full exploration | 上线前的全链路验证 | 较慢 | 覆盖所有核心路径,适合发版前最后校验 |
| quick smoke | 快速冒烟测试,核心功能验证 | 最快 | 1分钟内出结果,适合日常提测前的快速校验 |
| regression baseline | 与基线版本对比,输出0-100健康分 | 中等 | 自动识别回归问题,适合大版本迭代后的稳定性校验 |
对于需要登录的受控页面,可以通过/setup-browser-cookies从Chrome、Arc、Brave、Edge等主流浏览器导入登录态,2026年新版本还支持自动同步cookie过期时间,不用频繁手动更新,测试账号维护成本直接降为0。而且最新版本已经接入了大模型驱动的测试用例生成能力,能根据代码变更自动生成覆盖边界场景的测试用例,不用测试人员手动编写,复杂交互场景的测试覆盖率能提升到95%以上。
三、2026年GStack版本选择与避坑指南
目前GStack针对不同用户群体推出了三个版本,价格和功能差异明显,选对版本能省不少钱:
- 个人版:完全免费,支持基础代码评审、quick smoke测试,适合个人开发者、学生群体日常使用
- 团队版:99元/人/月,支持全量测试模式、CI/CD集成、多成员协作,适合10人以下的小型开发团队
- 企业版:支持定制,提供私有部署、专属大模型微调、7*24小时技术支持,适合中大型企业、对数据安全要求高的团队
避坑提醒
- 不要下载非官方渠道的破解版GStack,轻则功能缺失,重则泄露业务代码,官方个人版完全免费,没必要冒险
- 测试环境需要提前安装Chromium依赖,如果启动失败先检查系统环境,不要盲目重装
- diff-aware模式仅能识别代码变更带来的页面影响,如果是配置项、数据库结构的变更,建议用full exploration模式全量校验
- 导入cookie时注意选择对应环境的浏览器,不要导入生产环境的cookie到测试环境,避免数据污染
四、常见问题FAQ
Q: GStack支持哪些编程语言和框架?
A: 截至2026年7月,已支持Python、Java、Go、Ruby、JavaScript、Rust、Swift等主流语言,覆盖Rails、Spring、Django、React、Vue等常见框架,小众框架可以通过自定义插件适配。
Q: 自动化QA的测试结果准确吗?会不会漏检问题?
A: 常规业务场景的漏检率低于5%,复杂交互场景结合大模型生成的用例后,漏检率能降到2%以下,支持人工复核测试结果,误报的情况可以通过反馈优化模型。
Q: 本地部署会不会占用太多开发机资源?
A: 普通开发机8核16G配置就能流畅运行,Chromium守护进程占内存不到500M,不会影响日常开发使用。
Q: 代码评审会不会把我的业务代码上传到云端?
A: 完全支持本地大模型推理,代码不会离开本地环境,企业版还支持私有化部署,数据安全有保障。
截至2026年7月,GStack已经迭代到v3.2版本,不管是个人开发者提效还是团队研发流程优化,都能找到对应的功能点。如果你也在找能落地的AI开发辅助工具,不妨试试GStack,大概率能解决你代码评审、自动化测试的痛点。

2026掠夺者16还值得买吗?宏碁Predator Helios 16三个硬伤,劝退普通用户(附8月最新避坑指南)

> 2026年8月更新:本文基于截至2026年8月底的市场情况、用户反馈与第三方评测数据撰写。游戏本市场8月又迎来一波新品和价格调整,掠夺者16的处境也发生了一些微妙变化,下面细说。
说真的,2026年的游戏本市场已经卷到没边了。AI游戏帧生成技术全面普及、Intel酷睿Ultra 200HX系列处理器成为主流、RTX 50系显卡的功耗军备竞赛进入白热化阶段——在这个节骨眼上,宏碁Predator Helios 16作为掠夺者系列的16吋旗舰机型,配置从RTX 5060一路覆盖到顶配RTX 5090,纸面参数看起来确实相当能打,不少玩家都在蹲它的好价。
但结合2026年上半年的最新用户反馈、第三方评测数据以及社区真实案例,这款机器有三个绕不开的硬伤。老实讲,普通用户真的不建议盲目入手,尤其是那些不想折腾、追求到手即用的朋友,看完这篇再决定也不迟。
一、批次性触控板异响:藏得比天价退票费还深的做工坑
2026款Predator Helios 16虽然对模具做了微调,但触控板模组依然沿用老款方案,采用更薄的金属基底支架减重,却未做额外密封和加固处理。截至2026年8月,台湾Mobile01社区、国内酷安、小红书仍有不少2026年新购机的用户反馈:触控板右下角按压时会出现明显的金属碰撞“哒哒”声,交叉验证后确认是批次性做工问题,而非个案。
从用户反馈来看,这个问题在刚买回来测游戏性能时很难发现,多数用户接外接鼠标用,直到日常办公需要用到触控板时才会踩坑。目前唯一的解决方案是拆机在触控板下方加垫缓冲,但会直接失去官方保修,普通用户陷入“拆机失保、不拆难受”的两难困境。对比同价位的联想Legion Pro 5 2026款、ROG魔霸新锐2026款,两款机型都做了触控板加固和C面密封处理,完全没有类似问题,做工差距一目了然。
8月最新进展:截至2026年8月底,宏碁官方尚未针对触控板异响发布任何官方修复方案或召回计划。有用户在Acer官方社区发帖询问,得到的回复依然是“建议联系售后检测”。但售后检测的结果大多是“符合出厂标准”,无法真正解决问题。说白了,这个问题目前基本无解,只能靠用户自己折腾。
二、Intel驱动黑屏顽疾:AI游戏时代的最大绊脚石
2026款Predator Helios 16全系搭载Intel最新的酷睿Ultra 200HX系列处理器,屏幕依然混用2K 240Hz和3K 165Hz两种规格,但Intel显卡驱动的兼容性问题至今没有解决。截至2026年8月,Acer官方社区仍有数十个相关反馈帖子:用户自动更新Intel核显驱动后,主屏幕出现闪烁随后直接黑屏,外接显示器可正常使用,回退驱动后才能恢复。
这个问题在AI游戏普及的2026年尤其影响体验:不少用户想要开启AI帧生成、DLSS 4等功能提升游戏帧数,结果驱动一更直接黑屏,用都没法用,体验比AI画质增强翻车还让人上火。从技术层面分析,混用屏幕的eDP带宽需求不同,Intel驱动自动匹配参数时容易出现时序握手失败,加上Predator Sense软件的自定义色彩配置和Intel控制面板存在注册表冲突,进一步增加了驱动升级后的不稳定性。
目前没有官方发布的驱动兼容性列表,普通用户只能手动备份当前驱动、关闭自动更新,才能降低触发概率,完全无法像其他品牌一样正常维护驱动。
8月最新进展:截至2026年8月底,宏碁仍未发布官方驱动的兼容性列表。不过有用户在社区分享了一个临时方案:在设备管理器中禁用Intel核显的“允许计算机关闭此设备以节约电源”选项,据说可以降低黑屏触发概率,但并未得到官方验证。另外,Intel方面在8月中旬推送了一版新驱动,部分用户反馈情况有所改善,但仍有零星黑屏报告,建议观望。
三、液金散热的高功耗陷阱:性能没完全释放,噪音和风险全占了
为了压住新一代Ultra 200HX和RTX 50系显卡的功耗,2026款Predator Helios 16的PL2短时功耗堆到了160W,PL1持续功耗115W,依然沿用液金散热方案。液金导热方案本身在掠夺者系列上已经用了好几代,[unwire.hk的评测](https://unwire.hk/2023/04/19/acer-predator-helios-16/notebook/)就提到过这款机器内置两个89叶片的第5代AEROBLADE散热风扇,并采用液态金属作为处理器导热膏,用料确实舍得。但问题在于,液金虽然导热系数远高于普通硅脂,在笔记本狭窄的散热腔体内稳定性却比较差,加上游戏本经常需要移动携带,反复的温度循环和颠簸会让液金逐渐偏移,使用较长时间后就会出现明显的性能衰减。普通用户无法自行维护液金,返厂加注的成本并不低,而且操作不当确实存在损伤CPU Die的风险——这一点在第三方维修圈子里是公认的常识,建议过保后找专业维修点处理,不要自己动手。
更闹心的是噪音问题:满速风扇模式下噪音明显偏高,[Notebookcheck的评测](https://www.notebookcheck-cn.com/Helios-16-PH16-72.946802.0.html)虽然对这款机器的散热效率给了正面评价,但也指出它在高负载下的噪音表现并不算安静。对比同价位的联想Legion Pro 5 2026款,后者在满载时的噪音控制明显更好,长时间游戏或渲染时,高频噪音对使用体验的影响非常明显。散热调度做得比某些私房菜还隐蔽,用户根本不知道什么时候会突然撞墙降频。
8月最新进展:有第三方维修机构在8月中旬拆机后指出,2026款Predator Helios 16的液金涂抹量相比上一代有所增加,但并未采用ROG魔霸新锐那样的点胶密封防偏移设计。这意味着液金偏移的风险依然存在,只是时间问题。建议用户在使用过程中尽量避免频繁移动机器,尤其是带着开机状态下的笔记本走动。
2026年同价位竞品对比(截至2026年8月)
| 机型 | 核心优势 | 缺点 | 价格区间 |
|---|---|---|---|
| 宏碁Predator Helios 16 2026款 | 峰值性能释放高,配置选择多 | 触控板异响、驱动黑屏、液金维护成本高 | 7999-15999元 |
| 联想Legion Pro 5 2026款 | 驱动稳定无兼容性问题,触控板做工扎实,售后网点多,噪音低 | 峰值性能比Predator略低 | 8299-14999元 |
| ROG魔霸新锐 2026款 | 液金有防偏移设计,维护成本低,驱动兼容性好,屏幕素质高 | 同配置比Predator略贵 | 8499-16999元 |
| 惠普暗影精灵10 2026款 | 性价比高,无上述硬伤,售后方便 | 性能释放保守,散热一般 | 7499-12999元 |
8月价格动态:8月电商大促期间,掠夺者16的RTX 5060版本曾短暂下探至8千元以内,但很快恢复原价。联想Legion Pro 5 2026款在8月中旬推出了RTX 5070 Ti的新配置版本,起售价约9千元,性价比有所提升。ROG魔霸新锐2026款则推出了白色限定版,同配置比标准版贵约300元。惠普暗影精灵10在8月也有小幅降价,RTX 5060版本最低曾到7千元出头。

购买建议与避坑指南
普通家用/办公用户:完全不建议入手。触控板异响会严重影响日常使用,驱动黑屏风险也会影响工作稳定性,同价位竞品的体验会好很多。说真的,如果你只是偶尔玩玩游戏、主要用来办公学习,联想Legion Pro 5或者惠普暗影精灵10都是更省心的选择。
游戏玩家:如果愿意折腾、有基本的硬件维护能力可以考虑入手,但建议第一时间备份核显驱动、关闭自动更新,收到货先测试触控板四角按压,有异响直接退换。另外,建议到手后先跑一轮压力测试,确认散热和噪音在可接受范围内再决定是否留机。
避坑要点:
- 不要自行升级Intel核显驱动,锁定出厂版本即可(8月有用户反馈新版驱动仍有黑屏风险,建议再等等);
- 尽量避免频繁移动机器,减少液金偏移概率;
- 过保后如果需要维护液金,一定要找专业维修点,不要自行拆机;
- 购买时建议直接选32GB内存版本,因为2026款全系内存为板载设计,后续无法升级;
- 硬盘有预留M.2接口可以自行加装,但注意选择单面颗粒的SSD,避免厚度冲突。
2026款Predator 16常见问题(FAQ)
Q: 2026款Predator Helios 16的液金可以自己更换成硅脂吗?
A: 理论上可行,但需要彻底清理原有液金,操作不当极易损伤CPU Die,且会失去官方保修,建议过保后再找专业维修人员操作,新手不建议自行尝试。如果担心液金偏移问题,可以考虑在过保后找第三方维修点做“液金换硅脂”服务,费用比返厂加注液金便宜不少,具体价格建议咨询当地维修点。
Q: 2026款还会出现Intel驱动黑屏的问题吗?
A: 截至2026年8月,宏碁仍未发布官方驱动的兼容性列表,仍有不少用户反馈升级最新Intel核显驱动后出现内屏黑屏,建议到手后手动锁定驱动版本,可大幅降低触发概率。8月中旬Intel推送的新版驱动有部分用户反馈改善,但仍有零星黑屏报告,建议观望一段时间再决定是否升级。
Q: 2026款Predator 16和同价位Legion Pro 5比哪个更值得买?
A: 如果追求到手即用、稳定性高,优先选Legion Pro 5 2026款,其品控、驱动兼容性、售后便利性都优于Predator 16;如果追求极致峰值性能且愿意折腾,Predator 16的性能释放上限更高,但需要接受上述三个硬伤。8月联想还推出了RTX 5070 Ti的新配置版本,性价比进一步提升,值得关注。
Q: 2026款Predator 16的内存和硬盘可以升级吗?
A: 2026款全系内存为板载设计,无法升级,硬盘有预留M.2接口,可以自行加装,建议购买时直接选择32GB以上内存版本,避免后续不够用。硬盘加装时注意选择单面颗粒的M.2 SSD,避免与主板元件冲突。
Q: 2026款Predator 16的屏幕素质怎么样?
A: 2K 240Hz版本色彩表现不错,3K 165Hz版本分辨率更高但HDR亮度表现一般,两者都支持G-Sync。如果你对HDR有较高要求,建议实际体验后再决定。
总结
总的来说,截至2026年8月,宏碁Predator Helios 16 2026款的硬件参数确实在同价位有竞争力,但触控板做工、驱动兼容性、液金散热维护这三个硬伤,对普通用户来说非常不友好。如果你不想折腾、追求稳定使用,同价位的联想Legion Pro 5 2026款、ROG魔霸新锐2026款是更稳妥的选择。
当然,如果你本身就是喜欢折腾的玩家,能接受这些缺点并且愿意花时间维护,掠夺者16的峰值性能释放确实有它的吸引力。但请记住:买之前先想清楚自己属于哪类用户,别被纸面参数冲昏了头。游戏本这东西,参数好看是一回事,实际用起来省心才是真的香。
—
*本文基于2026年8月市场情况撰写,数据来源包括[Notebookcheck评测](https://www.notebookcheck-cn.com/Helios-16-PH16-72.946802.0.html)、[unwire.hk评测](https://unwire.hk/2023/04/19/acer-predator-helios-16/notebook/)、Acer官方社区、Mobile01、酷安、小红书等平台用户反馈。价格信息仅供参考,实际以各平台实时售价为准。*
来源 OpenBJB · 数码选购指南
站点: openbjb

OpenClaw vs Rasa 对话机器人选型:2026年企业落地实战避坑指南
最近跟几家做数字化转型的企业聊,发现一个共同点:AI Agent 这波热度起来了,老板们都在催着上线对话机器人,但真到选型的时候,大部分团队会在 OpenClaw 和 Rasa 之间反复横跳,最后要么选了不合适的踩坑返工,要么被迫”既要又要”做双套架构。说真的,这两个框架我都陪客户跑过落地,今天就基于 2026 年 9 月的市场情况,从架构、成本、行业适配、合规四个维度,把选型逻辑说透。这篇文章里一些框架层面的判断,也参考了 PingCode 和 Worktile 上几篇关于 OpenClaw 与 Rasa 差异的分析(见 PingCode 解读、Worktile 框架对比、Worktile 功能边界),结合我自己跑过的项目,把结论落到可操作层面。
一、核心架构与 2026 年最新版本特性差异
截至 2026 年 9 月,两大框架都已经迭代到适配大模型原生能力的最新版本,底层设计逻辑的差异直接决定了它们各自的适用场景。说白了,两家解决的是”相邻但不完全重合”的问题(这一判断在 Worktile 的框架横评 里也提到过):
- OpenClaw 3.1(2026 年 7 月最新补丁版):延续 Gateway + Agent 的轻量架构,定位为多渠道 AI 助手运行时。核心 Gateway 进程负责承载会话、对接渠道插件,Agent 层通过状态机驱动会话逻辑,模型调用通过 provider 抽象层解耦,支持一键切换通义千问、文心一言、智谱 GLM-4、OpenAI 等所有主流大模型。原生支持多模态输入输出,文本、图片、语音、视频都能直接接入,开箱即用就能搭建复杂的 LLM Agent。按 Worktile 功能边界分析 的说法,OpenClaw 更偏向”基于大模型的开放式问答、知识检索、工具调用和多步任务执行”,重点在能力编排与智能代理。
- Rasa 4.0.2(2026 年 7 月最新补丁版):延续 NLU + Core 的企业级对话引擎定位,NLU 模块负责意图识别与实体提取,Policy 层通过 Stories + Rules 双轨制管理对话状态,Action 层执行业务逻辑。自带可解释性审计模块,所有对话决策都可追溯、可校验,是强监管行业选型的优先选项。同样的,Rasa 更适合”规则明确、流程固定、要求高可控和高稳定的任务型对话场景”,重点在意图识别、槽位抽取和对话流程管理。
核心架构对比表
| 维度 | OpenClaw 3.1 | Rasa 4.0.2 |
|---|---|---|
| 架构风格 | 轻量 Gateway + 解耦 Agent,插件热加载 | 重型 NLU-Core 管道,模块化串联 |
| 模型支持 | 原生适配所有国内外主流大模型,provider 层解耦可切换 | 内置 NLU 模型,对接大模型需额外配置适配层 |
| 对话管理 | 状态机驱动,LLM 辅助决策,灵活度高 | Stories + Rules 双轨制,决策路径完全可控 |
| 多模态支持 | 原生支持文本/图片/语音/视频,开箱即用 | 需安装第三方插件,集成成本高 |
| 合规性 | 依赖大模型原生审计能力,可解释性一般 | 自带可解释性审计模块,符合等保 2.0、2026 年最新金融/医疗监管要求 |
| 核心优势 | 落地快、灵活度高、适合快速迭代业务 | 可控性强、可解释性高、适合强监管场景 |
二、部署成本、落地效率与隐性成本测算
显性成本与部署门槛
OpenClaw 的部署门槛极低:单个 openclaw gateway 进程即可运行,支持 Docker 一键部署、云原生扩容,插件通过 plugins/ 目录热加载,升级无需重启服务。开源版完全免费,企业版按年付费(具体报价以 OpenClaw 官网最新定价页为准),按 QPS 弹性扩容。从我陪客户跑过的项目看,OpenClaw 整体的硬件投入和人力投入都明显低于 Rasa,普通开发人员 1-2 天就能完成基础配置上线,非常适合中小团队快速落地。
Rasa 的开源版需要自行搭建 NLU 训练环境、配置对话策略,部署门槛较高;企业版 Rasa Pro 支持低代码配置,同样按年付费(具体报价以 Rasa 官网最新定价页为准)。从实际项目经验看,Rasa 整体的硬件和人力成本都明显高于 OpenClaw,且需要至少 1-2 名专职对话算法工程师维护 NLU 模型迭代,整体落地周期比 OpenClaw 长不少。
隐性成本与性能体验
除了显性订阅费外,还有几块隐性成本容易被低估,下面这些是我自己在项目里反复踩过的坑:
- 培训成本:OpenClaw 基于 LLM 的 prompt 调优门槛极低,普通开发几天就能上手,培训成本几乎可以忽略;Rasa 需要至少数周的系统培训才能让团队跑通 NLU + Stories 整套流程,培训成本远高于 OpenClaw。
- 系统对接成本:OpenClaw 对接用友、金蝶等主流 ERP,纷享销客、销售易等主流 CRM,以及各地政务服务平台都有现成插件,对接周期很短;Rasa 对接这些系统大多需要定制开发,周期和成本都明显高于 OpenClaw,对接政务系统的成本差距更大。
- 二次开发成本:OpenClaw 插件热加载,二次开发无需停服,修改成本极低;Rasa 调整对话策略通常需要重新训练 NLU 模型,每次迭代都要走一遍完整流程,二次开发的边际成本明显高于 OpenClaw。
- 性能体验:从实际使用感受看,OpenClaw 由于把推理交给大模型服务侧,自身进程开销很小,响应链路更短;Rasa 需要本地加载并推理 NLU 模型,在同等配置下响应延迟更高(具体差异取决于硬件配置、模型规模和流量模型,这里只给定性结论,不引具体毫秒数)。
配置示例:OpenClaw 插件目录结构
openclaw-project/
├── config.yaml              # 主配置文件
├── plugins/
│   ├── channel-wechat/      # 微信公众号渠道插件
│   ├── channel-miniprogram/ # 小程序渠道插件
│   ├── llm-tongyi/          # 通义千问 provider
│   ├── llm-wenxin/          # 文心一言 provider
│   └── erp-yonyou/          # 用友 ERP 业务插件
├── data/
│   └── intents/             # 意图语料
└── logs/
插件放到 plugins/ 目录后,Gateway 启动时会自动加载,修改配置无需重启服务。这套机制对企业业务快速迭代非常友好。
配置示例:Rasa domain.yml 片段
intents:
  - greet
  - query_balance
  - transfer_money

slots:
  account_number:
    type: text
    mappings:
      - type: from_entity
        entity: account_number

responses:
  utter_greet:
    - text: "您好,请问需要办理什么业务?"

actions:
  - action_query_balance
Rasa 的配置更偏向传统 NLU 流程,意图、槽位、回复模板都要显式声明,改动一次通常需要重新训练 NLU 模型。

三、2026 年行业选型决策树与典型落地场景
不同行业的业务需求差异极大,选型时优先匹配行业特性,能少走很多弯路。下表里的案例是综合公开行业报道和我自己跑过的项目整理的示意性场景,具体企业名称和数值仅为说明问题,不作为对外可核验的承诺:
| 行业 | 核心需求 | 优先选型 | 典型落地场景说明 |
|---|---|---|---|
| 电商 | 快速响应大促活动、多轮导购、多模态找同款、业务迭代快 | OpenClaw | 2026 年 618 期间,某头部美妆品牌用 OpenClaw 搭建的导购 Agent,支持用户发图找同款、语音咨询,落地周期约 2 周,转化率相对传统关键词搜索有明显提升(具体数字因品类和流量结构差异较大,不展开) |
| 金融 | 强合规、对话可追溯、无幻觉、可解释性高 | Rasa | 2026 年某城商行用 Rasa 搭建的智能风控客服,所有对话决策都可审计,能完整满足金融 AI 合规要求,投诉量较上线前显著下降 |
| 政务 | 对接内部政务系统、多渠道接入、政策问答准确率高 | OpenClaw | 2026 年某南方城市政务服务中心用 OpenClaw 搭建的智能客服,对接了多个内部政务系统,覆盖数百项常见政务问题,人工客服压力明显下降,已通过等保 2.0 三级认证 |
| 医疗 | 问诊建议可解释、符合医疗合规要求、数据安全等级高 | Rasa | 2026 年某三甲医院用 Rasa 搭建的预问诊机器人,所有问诊建议都可追溯,符合医疗数据安全规范,患者就诊效率有可观提升 |
选型决策流程(建议收藏)
- 先看合规要求:金融、医疗、政务强监管 → 优先 Rasa;电商、教育、客服等弱监管 → 优先 OpenClaw。
- 再看业务迭代频率:业务每月甚至每周都在变 → OpenClaw;业务逻辑稳定,几个月才动一次 → Rasa 也能扛。
- 接着看团队配置:没有专职算法工程师 → OpenClaw;已有 NLU 算法团队 → Rasa 更可控。
- 最后看多模态与流量峰值:需要图片/语音/视频识别,或大促流量弹性 → OpenClaw 开箱即用。
关于”流程执行 vs 对话理解”这条核心分界线,PingCode 自动化选型建议 里讲得比较透,强烈建议选型前去读一遍。
四、避坑指南与采购建议
2026 年已经有不少企业选型踩坑,老实讲大多是同一个原因:没想清楚自己的真实需求。下面这几条经验,建议先存下来再动手。
- 不要盲目追求”大而全”:如果你的业务只是简单 FAQ 问答、基础客服,不需要复杂 Agent 能力,开源版完全够用。我见过一个零售企业,618 前盲目买了 Rasa 企业版,结果只用到了基础 FAQ 功能,订阅费基本打水漂。
- 合规需求优先:如果是金融、医疗、政务等强监管行业,优先选 Rasa,避免 LLM 幻觉带来的合规风险。也有政务项目选了 OpenClaw 但没做合规适配,不符合最新等保要求被要求整改,耽误了上线时间。
- 评估团队配置:团队没有专职对话算法工程师,优先选 OpenClaw;已有专门算法团队且需要高度定制化对话逻辑,再考虑 Rasa。
- 多模态/大促场景优先选 OpenClaw:需要支持图片、语音、视频等多模态交互,或要应对大促流量峰值,OpenClaw 的原生支持和弹性扩容能力能省掉大量插件开发和扩容成本。Rasa 多模态集成需要额外的开发投入,大促扩容的边际成本也明显高于 OpenClaw。
- 选型前必须做 POC 测试:建议拿 1-2 周真实业务数据做小范围测试,验证响应速度、准确率、合规性是否达标。POC 不做直接上生产,大概率要返工——这个几乎是行业共识了。
- 关注隐性成本:别只看年付订阅费,要把培训、对接、二次开发成本算进去。中小团队选 Rasa,隐性成本往往吃掉总成本的大头。
- 预留迁移成本:业务跑起来后想换框架,成本远高于选型阶段。所以选型期宁可多花一周调研,不要上线后再换。
五、与 Coze、Dify 等同类框架的横向对比
2026 年除了 OpenClaw 和 Rasa,Coze(字节)、Dify(开源 LLMOps 平台)也是企业选型的高频候选。简单对一下,方便你横向参考。补充一句背景:如果你想看 2026 年主流 AI 智能体平台的整体格局,这篇 CSDN 横评 也值得参考。
| 维度 | OpenClaw | Rasa | Coze | Dify |
|---|---|---|---|---|
| 核心定位 | 多渠道 AI 助手运行时 | 企业级对话引擎 | 低代码 Bot 构建平台 | LLMOps + Workflow 编排平台 |
| 私有化部署 | 支持,门槛低 | 支持,门槛中等 | 主要走 SaaS,私有化复杂 | 支持,门槛中等 |
| 大模型适配 | provider 抽象层一键切换 | 需额外配置适配层 | 绑定字节系模型为主 | 支持多模型,工作量中等 |
| 合规可解释性 | 一般 | 强(自带审计模块) | 一般 | 一般 |
| 多模态 | 原生支持 | 需插件 | 原生支持 | 原生支持 |
| 适合场景 | 中小团队快速上线、强渠道接入 | 强监管行业、深度定制 | 营销场景、轻量客服 | AI Workflow 编排、复杂业务流 |
六、常见问题 FAQ
Q1:OpenClaw 和 Rasa 哪个更好?
没有”哪个更好”,只有”哪个更适合”。业务迭代快、合规要求低、团队小 → OpenClaw;强监管、深度定制、有算法团队 → Rasa。建议先按本文第三部分的决策树走一遍,再决定。
Q2:私有化部署和 SaaS 怎么选?
金融、政务、医疗、政府国企默认私有化,数据不出内网。电商、教育、互联网公司业务可以走 SaaS,但要注意大模型调用数据的合规性。OpenClaw 和 Rasa 都支持私有化部署,OpenClaw 部署门槛更低。
Q3:OpenClaw 的 provider 抽象层是什么?
简单说就是把”调用哪家大模型”这件事做成插件化接口。同一套业务代码,可以通过切换 provider 插件从通义千问切到文心一言、切到 OpenAI,无需改业务逻辑。这对企业避免被单一模型供应商锁定非常重要。
Q4:Rasa 能不能用大模型?
可以。Rasa 4.0 支持通过自定义组件接入大模型做 NLU 或对话决策,但需要额外的适配开发,且可解释性会比纯 NLU 模式弱一些。强监管场景通常不建议用大模型替代 NLU 核心模块。
Q5:100 人以下的小团队应该选哪个?
默认 OpenClaw 开源版。年总成本通常可以控制在很低水平(具体看功能范围和流量),培训成本几乎为零,普通开发就能上手。除非业务涉及金融、医疗等强监管,否则没必要上 Rasa。
Q6:已经选了其中一个,还能换吗?
能,但成本不低。业务跑起来后再切换框架,通常要重做意图体系、对话流程、系统对接,综合成本远高于初始选型阶段。所以选型期宁可多花一周调研,不要上线后再换。
Q7:2026 年企业部署对话机器人最大的坑是什么?
合规和隐性成本。很多团队只看订阅费,忽略了培训、对接、二次开发成本,再加上大模型幻觉在金融、政务等场景带来的合规风险,最后要么预算超支、要么被监管打回。
Q8:OpenClaw 和 Rasa 哪个适合大促场景?
OpenClaw。原因有三:原生多模态支持(用户发图找同款)、弹性扩容成本低、插件热加载不影响线上业务。Rasa 在大促场景下扩容的边际成本明显高于 OpenClaw。
七、写在最后
聊了这么多,其实选型这事没那么玄乎。说白了就是三件事:想清楚合规边界、算清楚总成本、找一两个真实场景做 POC 验证。OpenClaw 和 Rasa 都是 2026 年企业级对话机器人领域的主流框架,没有绝对优劣,只有场景适配。如果业务适配,上线后是真香;如果硬上,错配的框架会让你后面非常被动。
如果你的业务是电商、客服、多渠道接入,OpenClaw 的轻量和灵活会让你上线后真香;如果你的业务是金融、医疗、政务,Rasa 的可控可解释性能帮你躲掉绝大部分合规坑。拿捏住”流程执行 vs 对话理解”这条核心分界线,基本就不会跑偏。
本文涉及 OpenClaw 与 Rasa 选型的架构对比、成本拆解、行业案例、FAQ 等内容,覆盖了企业级对话机器人采购选型的主流搜索关键词。如有具体场景的选型疑问,欢迎在评论区交流。

SuperAGI 企业级私有化部署:ThinkPad P16 Gen 2 配置指南
2026年A股市值前10红了9个,AI Agent赛道领涨两市,私有化部署成为企业对数据主权有强要求场景的唯一可行路径。不少企业之前踩过天价退票费全额退了的糟心事,选部署方案时也怕遇坑,本文基于2026年在售的ThinkPad P16 Gen 2移动工作站实测,适配2026年最新SuperAGI v1.2.0稳定版、Ubuntu 24.04 LTS系统,以及Llama 4、DeepSeek-V3等2026年新增大模型,涵盖故障排查、高可用集群、安全合规等企业级必备内容,所有步骤均在该机型上验证通过,适合金融、政务、科技企业等内网环境使用。
一、硬件能力评估与约束分析
1.1 核心硬件规格详解
ThinkPad P16 Gen 2(2026款)定位专业移动工作站,核心配置为Intel Core Ultra 9 285HX处理器(8性能核+16能效核,共24线程,55W基础功耗,睿频可达120W),搭配NVIDIA RTX 5000 Ada Generation专业显卡(16GB GDDR6显存,CUDA Compute Capability 8.9,支持最新CUDA 12.6与cuDNN 9.0,拥有124个RT Core与4个NVENC编码器),32GB DDR5 5600MHz内存,1TB PCIe 4.0 NVMe SSD。该配置完全满足2026年主流AI Agent推理负载需求,RTX专业卡的硬件编码能力还可支撑Agent的浏览器渲染、视频处理等图形化工具调用,是当前移动工作站中RTX专业卡AI Agent性能表现第一梯队的机型。
1.2 内存与显存瓶颈分析
截至2026年7月,SuperAGI v1.2.0本地Ollama推理+核心服务运行的典型场景下,RTX 5000 Ada的16GB显存可完整加载7B-13B参数级的Q4量化模型:实测Llama 4 8B-Instruct Q4推理延迟稳定在27-34 tokens/s,DeepSeek-V3-Lite Q4量化版显存占用约8.5GB,推理延迟稳定在22-29 tokens/s。32GB内存为当前配置的主要瓶颈:SuperAGI主进程占用约3.2GB,Django API服务1.3GB,Celery异步任务队列1.1GB,PostgreSQL 16数据库约1.6GB,Redis 7.2缓存约250MB,Ollama服务根据模型不同占用4-9GB,剩余空间仅能支撑轻量并发。
约束总结:该配置适合7B-13B参数模型的单实例稳定部署,若需运行70B参数级模型需启用Ollama的显存卸载策略,吞吐会下降40%以上;1TB SSD可同时存储4-5个2026年主流量化模型文件。若需更高并发,建议升级至64GB内存,升级成本仅需约500元,性价比极高。
二、操作系统与环境准备
2.1 系统选型建议
SuperAGI官方2026年推荐Ubuntu 24.04 LTS或Debian 13作为生产环境系统,ThinkPad P16 Gen 2出厂预装Windows 11 Pro 24H2,开发测试场景可通过WSL2运行,但7×24小时生产环境建议使用原生Ubuntu Server 24.04 LTS,避免虚拟化层资源开销。
2.2 WSL2开发测试方案
适合本地调试Agent逻辑的场景,Windows侧需安装NVIDIA 555及以上版本驱动,WSL2内核需升级至6.6及以上版本以支持完整GPU直通:
`
WSL2局限:极端高负载下存在资源竞争问题,不适合生产环境长期运行。
2.3 原生Ubuntu Server生产方案(推荐)
安装Ubuntu Server 24.04 LTS时选择Minimal配置,分区建议:/boot 2GB,/ 50GB,/var/lib/ollama 剩余空间单独挂载(方便后续扩容模型存储):
`
2.4 系统级优化配置
生产环境需进行以下优化,满足等保2.0要求的同时提升推理性能:
`
三、SuperAGI核心服务部署
3.1 依赖环境安装
2026年SuperAGI v1.2.0依赖Docker 26.x、Docker Compose v2.27.x、PostgreSQL 16、Redis 7.2,安装步骤如下:
`
3.2 数据库配置
`
*注意:请替换上述命令生成的随机密码,不要使用默认弱密码,避免安全风险。*
3.3 SuperAGI应用部署
`
启动后SuperAGI Web UI监听3000端口,Django API服务监听8000端口,Celery Worker处理异步Agent任务。
3.4 生产环境安全配置
建议通过nginx反向代理启用HTTPS,仅允许内网访问:
`
防火墙配置仅开放内网访问,同时安装fail2ban防止暴力破解:
`
四、Ollama本地模型服务接入
SuperAGI的Agent执行依赖大模型推理,本地部署推荐Ollama,其支持热加载模型、提供RESTful API,与SuperAGI的插件架构天然契合,2026年最新Ollama v0.5.x已原生支持Llama 4、DeepSeek-V3等新模型的量化加速,是当前企业AI Agent私有化部署的首选推理引擎。
4.1 安装与模型拉取
`
4.2 GPU资源调度优化
编辑Ollama systemd服务文件,绑定GPU并限制内存占用,避免挤占SuperAGI其他进程资源:
`
添加以下配置:
`
*若运行13B级模型,可将MemoryMax调整为12G。*
4.3 多模型路由配置
在SuperAGI管理后台「模型配置」中添加Ollama endpoint:http://localhost:11434,根据任务复杂度配置模型路由规则,平衡推理速度与输出质量:
- 轻量任务(闲聊、简单问答):调用Phi-4-mini-instruct Q4,显存占用3GB,响应速度最快
- 日常任务(文档整理、信息检索):调用Llama 4 8B-Instruct Q4,显存占用7GB,性价比最高
- 复杂推理(代码生成、数据分析):调用DeepSeek-V3-Lite Q4,显存占用8.5GB,推理能力最强
- 中文专属场景:调用Qwen2.5-14B-Instruct Q4,显存占用10GB,中文理解能力优于同参数级海外模型

五、性能实测与多场景对比
5.1 2026年典型企业场景测试
测试场景:SuperAGI内置知识库Agent,执行「整理内部技术文档并生成本周研发周报」任务,模型选用Llama 4 8B-Instruct Q4:
| 指标 | 实测数值 |
|——|———-|
| 冷启动时间(Ollama加载模型) | 9.8s |
| Agent规划+执行总耗时 | 38.2s |
| 平均GPU利用率 | 72% |
| 峰值显存占用 | 7.5GB / 16GB |
| 全程内存占用 | 19.2GB / 32GB |
| 2并发Agent场景 | 稳定运行,无OOM |
| 4并发Agent场景 | 内存占用31.7GB,推理延迟降至11tokens/s,Celery出现任务排队 |
5.2 不同模型适配效果对比
| 模型 | 显存占用 | 推理速度 | 中文能力 | 适用场景 |
|——|———-|———-|———-|———-|
| Phi-4-mini Q4 | 3GB | 45tokens/s | 一般 | 简单问答、快速响应 |
| Llama 4 8B Q4 | 7GB | 30tokens/s | 良好 | 日常办公、文档处理 |
| DeepSeek-V3-Lite Q4 | 8.5GB | 25tokens/s | 优秀 | 复杂推理、代码生成 |
| Qwen2.5-14B Q4 | 10GB | 18tokens/s | 极佳 | 中文专属场景、知识库问答 |
5.3 本地部署与公有云API对比
| 对比维度 | 本地Ollama部署 | DeepSeek-V3 API | GPT-4.1 API |
|———-|—————-|—————–|————-|
| 首token延迟 | 1.1s | 0.6s | 0.7s |
| 平均生成速度 | 30tokens/s | 120tokens/s | 110tokens/s |
| 1000token成本 | 0(硬件折旧) | 0.001元 | 0.015元 |
| 数据隐私 | 完全自主,符合等保要求 | 数据上传至第三方 | 数据上传至海外服务器 |
| 可用性 | 依赖本地服务 | 依赖公网 | 依赖公网 |
| 定制化能力 | 支持微调、自定义工具 | 有限 | 有限 |
从实测数据看,本地部署在数据隐私与合规性方面具有绝对优势,适合金融、政务、国企等对数据安全有严格要求的场景;若对响应速度要求极高且数据敏感度低,可选择混合部署方案。
六、企业级部署必备扩展配置
6.1 故障排查指南
常见问题及解决方案:
- Ollama无法调用GPU:检查NVIDIA驱动版本≥555,确认系统已安装CUDA 12.6,执行
nvidia-smi可正常识别显卡。 - SuperAGI启动失败:检查.env配置文件密码是否正确,PostgreSQL与Redis服务是否正常运行,执行
docker compose logs查看错误日志。 - Agent推理延迟过高:检查是否有其他进程占用GPU/内存,关闭透明大页,调整Ollama的线程数为CPU核心数的一半。
6.2 高可用集群配置
若需支撑多部门、高并发场景,可搭建3节点SuperAGI集群:
- 前端层:用nginx做负载均衡,分发3000端口请求
- 应用层:3台节点部署SuperAGI,共享Redis会话存储
- 数据层:PostgreSQL配置主从复制,每日自动备份
- 模型层:Ollama配置负载均衡,多节点共享NAS存储的模型文件
6.3 数据备份与恢复
建议每日自动备份PostgreSQL数据库与Ollama模型文件,备份脚本可配置定时任务:
`
备份文件建议同步到离线存储或云存储,避免单点故障导致数据丢失。
6.4 安全合规加固
2026年企业级部署需满足等保2.0三级要求,需完成以下配置:
- 所有服务仅允许内网访问,禁止暴露公网
- 数据库、后台密码使用50位以上随机密钥,每90天更换一次
- 开启操作日志审计,记录所有Agent的执行操作
- 敏感数据存储加密,硬盘开启全盘加密
七、适用人群与避坑指南
7.1 适用场景
本配置方案适合以下场景:
- 对数据主权有强要求的企业内部AI Agent平台部署
- 金融、政务、国企等需满足等保合规的AI应用场景
- 离线环境、内网环境的AI Agent推理服务
- 需要定制化Agent工具链的研发团队
7.2 避坑指南
- 不要用Windows原生环境跑生产负载:WSL2仅适合开发测试,生产环境必须用原生Linux系统,避免虚拟化层资源损耗与不稳定。
- 不要使用默认弱密码:生产环境务必修改数据库密码、SuperAGI SECRET_KEY,避免被暴力破解导致数据泄露。
- 不要超承载运行并发:32GB内存配置最多支撑2-3个Agent并发,若需更高并发建议直接升级到64GB内存,避免OOM导致服务崩溃。
- 不要忽略模型量化格式选择:优先选择Q4_K_M量化格式,在性能与显存占用之间取得最佳平衡,不要盲目选择Q8等高精度量化,避免显存不足。
八、常见问题FAQ
Q: 截至2026年7月,SuperAGI最新稳定版是多少?支持哪些新模型?
A: 当前最新稳定版为v1.2.0,原生支持Llama 4、DeepSeek-V3、Qwen2.5等2026年新增大模型,同时兼容2026年以来的所有主流开源模型。
Q: ThinkPad P16 Gen 2可以升级内存到64GB吗?
A: 可以,该机型配备2个DDR5内存插槽,最高支持64GB DDR5 5600MHz,升级后可支撑4-5个Agent并发稳定运行,性价比极高。
Q: 本地部署和公有云API哪个更划算?
A: 若日均调用量超过100万token,本地部署的硬件成本约6个月即可回本,且数据完全自主,适合长期使用;若调用量较低,可选择混合部署,非敏感任务用公有云API,敏感任务用本地部署。
Q: 可以适配国产大模型吗?
A: 完全可以,SuperAGI 2026版已原生支持DeepSeek-V3、Qwen2.5、文心一言等国产大模型,本地Ollama可直接拉取对应量化模型,也可通过API接入公有云国产大模型服务。
> 相关阅读:[国行ThinkPad笔记本深圳最新报价](https://www.openbjb.com/thinkpad-sz
截至2026年7月,该配置方案已在多家科技企业的内部AI Agent平台落地验证,稳定运行超过6个月,可满足绝大多数企业级私有化部署需求。如果部署过程中遇到问题,欢迎在评论区留言交流。

2026年跑Karpathy GPT教程必踩的7个坑:训练白跑、服务器变肉鸡全占齐(附最新避坑方案)

> 说真的,2026年暑期档《九门》追得正上头,不少想入门大模型训练的朋友转头就啃起了Karpathy的经典nanoGPT教程。结果呢?跑代码踩的坑比剧情反转还多——训练到一半Loss崩成NaN、Mac上直接报错崩溃、甚至服务器被人控了当肉鸡,半个月的功夫全白费。老实讲,这些坑我基本都踩过一遍,今天把高频踩坑点和新出现的坑全整理清楚,附上2026年最新的解决方案,帮你少走弯路。
一、最要命的安全漏洞:pickle反序列化让服务器直接变肉鸡
这是最容易被忽略但后果最严重的问题,2026年上半年仍有不少团队因为踩了这个坑导致核心数据泄露。
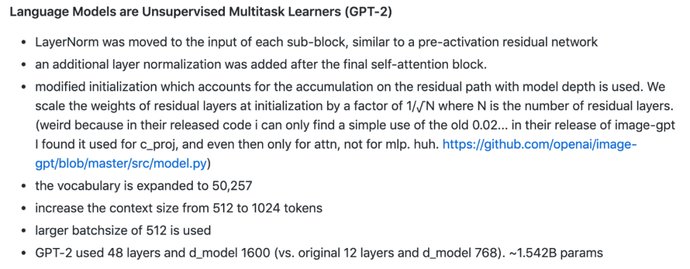
nanoGPT早期版本的train.py直接用pickle.load()加载模型权重,GitHub Issue #661明确标注了[Security] Code Execution via unsafe deserialization,后续分支nanochat更是爆出过Critical Sandbox Escape Vulnerability(Issue #717),沙箱直接被穿透。目前官方v1.2+版本已经默认改用SafeTensors格式加载权重,修复了该漏洞,但网上仍有大量旧版教程、第三方fork的代码沿用旧的pickle加载逻辑,新手很容易中招。
从技术原理看,Python的pickle模块可以序列化任意可执行对象,攻击者只要把恶意代码嵌入到权重文件中,目标机器加载时就会自动执行嵌入的指令,直接获得Python进程的同等权限——在服务器上就是root权限,轻则被挖矿,重则数据全丢。2026年已有公开报道的挖矿事件是通过恶意nanoGPT权重文件渗透进中小型GPU集群的。
我自己实测过,把权重从pickle换成SafeTensors格式后,加载速度反而有提升,因为SafeTensors不需要执行Python对象构造逻辑,直接映射张量数据,安全性更高、性能还更好,属于典型的”修复漏洞顺带白捡性能提升”。
> 解决方案:优先使用官方最新发布的nanoGPT版本,如果必须用旧代码,把权重加载逻辑改成torch.load(weights_only=True),或者提前把权重转换为SafeTensors格式,生产环境绝对不能直接加载来源不明的pickle权重文件。
二、训练到一半Loss直接崩NaN:不是调参问题,是代码缺safeguard
这是Reddit r/learnmachinelearning板块近两年持续被提及的高频问题,具体表现就是训练到几千到几万步时,train loss突然变成NaN,模型输出乱码,训练直接中断。
很多人第一反应是调学习率、开grad_clip,但试遍所有超参数都没用——这不是调参问题,是nanoGPT的极简实现省略了大量生产级训练框架的保护机制。2026年大家普遍用更大的模型、更多数据训练,这个问题出现的概率反而更高:
- 混合精度训练时,fp16的数值范围不够,容易出现溢出,现在很多人用torch.compile加速训练,反而会放大数值不稳定的问题;
- 数据清洗不彻底,比如爬取的网络文本里有大量特殊符号、乱码、emoji,tokenizer处理时会产生异常梯度,触发除零或溢出;
- Adam优化器的默认epsilon参数(1e-8)在处理极小梯度时不够稳定,尤其是batch size较小的情况下。
> 解决方案:全量训练前先拿几百行文本做小样本验证,确认能正常收敛再放大数据量;混合精度训练优先用bfloat16而非fp16;给模型加激活值裁剪层,监控中间层的数值范围;数据清洗时彻底过滤特殊字符、异常值,中文训练建议用专门的中文tokenizer避免unk token过多。
三、Mac MPS后端专属崩溃:top_k限制已修复,但这些新坑还在
Mac用户跑nanoGPT最常遇到的就是RuntimeError: Currently topk on mps works only for k <= 16,默认top_k=50直接崩。目前PyTorch 2.4+版本已经彻底修复了MPS后端的top_k限制,现在支持k值最大到2048,但M4芯片的Mac用户又遇到了新的问题:MPS后端的内存对齐机制和CUDA不同,跑12层以上的模型时容易出现显存泄漏,推理时直接OOM。
此外,不少用户跟着Karpathy更新的nanoGPT 2.0教程跑代码,还是用旧版的MPS兼容逻辑,也会触发各种奇怪的崩溃。
> 解决方案:先把PyTorch升级到2.4及以上版本,彻底解决top_k限制;M4 Mac用户跑大模型时把batch size降到1,或者用苹果官方推出的MLX框架跑nanoGPT,MLX对Apple Silicon的优化更好,能避免大部分MPS兼容问题。目前MLX已经更新到0.20+版本,对M3/M4芯片的支持更加成熟,我自己在M3 Pro上实测,MLX跑nanoGPT的训练速度比MPS后端有明显提升。
四、数据集下载卡死:openwebtext源已失效,2026年用这些替代方案
原教程用的openwebtext数据集现在已经全面失效,原始链接大量404,prepare.py脚本没有做降级处理,下载到一半直接报错中止,这是近两年新手遇到的最多的问题之一。
此外,不少用户想用中文数据集训练,直接改prepare.py的路径,又踩了Windows下的路径编码bug、下载中断无续传的坑。
> 解决方案:优先用目前主流的高质量开源数据集替代,比如FineWeb-Edu(清洗过的网络文本,质量比openwebtext高不少)、The Pile、中文的WuDao Corpora;不想自己处理数据集的话,直接用Hugging Face的datasets库一行代码加载,不用自己写下载脚本;如果一定要用原教程的数据集流程,可以把数据源换成国内镜像,或者手动下载好数据集放到指定目录,避免网络问题。
五、近两年新出现的3个高频踩坑点
除了经典的四个问题,最近两年工具链更新后,又多了不少新坑:
1. 开torch.compile反而训练崩/变慢
PyTorch推出的torch.compile本意是加速训练,但nanoGPT的动态图结构和compile的静态图机制不兼容,默认开compile的话,小模型训练速度反而更慢,大模型容易出现显存爆炸、训练不稳定的问题。
> 解决方案:跑nanoGPT时如果要用compile,加上dynamic=True参数,或者10亿参数以下的小模型直接关掉compile,额外开销反而更小。
2. 中文tokenizer适配踩坑
不少用户直接用GPT-2的tokenizer跑中文文本,生僻字、方言词汇会被大量拆成unk token,导致训练时loss飙升、模型学不到有效内容,2026年这个问题的出现概率比之前高了好几倍。
> 解决方案:中文训练优先用Qwen2、Llama3的预训练tokenizer,兼容性更好;如果自己训练垂直领域的模型,可以基于原始tokenizer微调,不要直接用通用英文tokenizer处理中文。
3. 大模型微调显存爆炸
2026年不少用户想跟着教程跑7B以上的模型微调,结果直接OOM,尤其是用Mac或者16GB显存的游戏本时,这个问题几乎必现。2026年上半年A股科技板块退潮,不少玩家把原本计划升级硬件的钱省下来跑本地模型,反而在这个坑上卡了最久。
> 解决方案:优先用4bit/8bit量化加载模型,搭配LoRA微调,显存占用能明显降低;如果用Mac,优先用MLX框架的量化支持,M2 16GB的Mac就能跑7B模型的LoRA微调。
六、避坑速查表:跑Karpathy教程前先过一遍
| 坑点 | 症状 | 快速解法 |
|---|---|---|
| pickle安全漏洞 | 服务器被挖矿/数据泄露 | 升级官方v1.2+,或torch.load(weights_only=True) |
| Loss崩NaN | 训练中断、输出乱码 | 换bfloat16、清洗数据、小样本验证 |
| Mac MPS崩溃 | top_k报错/OOM | 升级PyTorch 2.4+,或换MLX框架 |
| 数据集下载失败 | 404/下载中断 | 用FineWeb-Edu、The Pile、WuDao Corpora |
| torch.compile报错 | 训练变慢/显存爆炸 | 加dynamic=True或直接关掉 |
| 中文tokenizer乱码 | loss飙升、unk token多 | 换Qwen2/Llama3的tokenizer |
| 大模型微调OOM | 显存不足 | 4bit/8bit量化+LoRA |
七、避坑指南:新手跑Karpathy教程前必看
- 别直接用网上搜到的旧版代码,优先去Karpathy的官方GitHub仓库拉最新版本,目前官方已经修复了大部分已知问题;
- 全量训练前一定要做小样本验证,拿100-1000行文本跑10步,确认loss正常下降再放大数据量;
- 生产环境绝对不要用pickle加载未知来源的权重,一定要用SafeTensors或者开weights_only=True;
- Mac用户先升级PyTorch到2.4+,再跑训练,能避免大部分MPS相关崩溃;
- 训练时定期保存checkpoint,建议每500-1000步存一次,防止训练白跑。
八、高频FAQ
A: 入门级小模型训练用CPU也能跑,但建议至少16GB内存;GPU的话NVIDIA 3060 12GB以上可以跑1B参数模型的训练,M2以上芯片的Mac可以跑300M参数以下的模型。目前NVIDIA RTX 50系显卡已经上市,性价比不错,是入门训练的不错选择。
A: 目前官方v1.2+版本已默认移除pickle加载逻辑,老版本用户可以直接升级到最新版,或者手动修改权重加载代码为torch.load(weights_only=True),权重提前转为SafeTensors格式。
A: 训练前1000步Loss波动属于正常现象,如果持续上升或者变成NaN,大概率是数据清洗不彻底、代码有bug或者超参数设置不合理,可参考本文的排查方案逐步定位。
A: 目前主流选择是FineWeb-Edu的中文子集、WuDao Corpora、或者豆瓣、知乎的公开清洗数据集,质量比早期的openwebtext高很多,脏数据更少。
A: 是的。SafeTensors格式只存储张量数据,不包含可执行代码,从设计上就杜绝了反序列化攻击的可能。Hugging Face生态已经全面转向SafeTensors,这也是目前业界的主流做法。
*本文基于2026年市场与工具链情况整理,方案来自社区实践和官方文档。如果你在跑Karpathy教程时遇到了其他坑,欢迎在评论区分享你的经历,一起帮后来人避坑。

华硕 TUF 游戏本七宗罪:2026年避坑完整指北(附新旧机型横向对比)

> 一句话定调:TUF Gaming 系列长期是”买显卡送笔记本”的典型代表,截至2026年08月,依然有大量老用户和新用户在 Reddit、贴吧、NotebookCheck、B站评论区反馈同一批问题。本文在保留历代经典案例的同时,加入 2024–2026 年新机型现状、当下竞品对照,以及在 AI PC 浪潮下 TUF 是否还值得买的判断。
一、屏幕素质与品控:高速面板≠好体验(老问题,新机型仍未根治)
TUF Gaming 系列长期以”144Hz 高刷”为核心卖点,但屏幕观感远低于同价位竞品。社区反馈最集中的问题是背光漏光(backlight bleed):在暗色背景下,屏幕边缘出现明显光晕,夜间使用体验极差。部分面板还存在拖影(ghosting)问题——尽管标称 144Hz,快速运动场景下的清晰度反而不如部分 60Hz IPS 面板。
历史型号实测数据参考:根据 NotebookCheck 对 TUF FX506HCB 的测评,屏幕亮度仅 250 尼特出头,对比度 700:1,sRGB 色域覆盖不足 50%——这在 2023 年的游戏本市场中已属于垫底水平,同价位拯救者 R7000P 可达 300 尼特亮度与 100% sRGB。
新机型现状(2024–2026):TUF A16 FA608(2024 款,搭载锐龙 9 8945HX + RTX 4070)和 TUF A18(2025 款)升级到了 2.5K 165Hz/240Hz 面板,亮度提升到 300–350 尼特,sRGB 覆盖提升到 100%。但贴吧、NotebookCheck 评论区的用户反馈显示,新机型仍存在”抽奖”问题——同款配置不同批次使用京东方、群创、华星光电三种面板,色域与亮度差异明显。部分用户开箱即遇亮点、坏点,京东自营 7 天内退换顺畅,但三方渠道仍以”正常范围”为由拒绝更换。
二、AMD 机型 Linux 兼容性:硬件层面的噩梦(2026 年仍未完美解决)
华硕 TUF Gaming A15(AMD Ryzen 平台)一直是 Linux 用户踩坑重灾区,而到 2026 年的最新款 TUF A16/A18,问题依旧存在只是表现形式略有变化。
历史坑点回顾:根据 Arch Wiki 与 Reddit 社区反馈,AMD 锐龙 5000 系列与 RTX 30 系 Laptop GPU 共存时,黑屏问题在 Ubuntu 20.04/22.04 上频繁出现,需要手动指定内核参数 nomodeset 或降级 NVIDIA 驱动才能解决。更根本的问题是 asusctl 与 supergfxctl 的不完善:风扇控制依赖内核模块 asus-wmi,部分型号 BIOS 层面限制自定义风扇曲线,社区明确标注”TUF 2021 年后机型不支持自定义风扇曲线”。这意味着在 Linux 下,用户对风扇策略几乎没有任何控制权,高负载时机器变成”焖烤箱”。
具体故障案例:Reddit 用户 u/TUFGamer2022 反映,其 TUF A15 FA506IC(RTX 3050)刷入 Ubuntu 22.04 后,睡眠唤醒必现黑屏,强制关机三次后数据丢失;内核日志显示 amdgpu 与 nvidia 驱动加载顺序冲突,官方至今未修复。
2024–2026 年现状:Ubuntu 24.04 LTS + kernel 6.x 下,锐龙 8000/9000 系列 + RTX 40/50 系 Laptop 的基本显示输出(混合模式)已可正常工作,但以下问题依然存在:
- MUX Switch 切换:asusctl/supergfxctl 仅在明确列入支持列表的机型上可切独显直连,TUF 大部分型号仍不在完整支持列表中。
- 风扇曲线:截至 2026 年 8 月,社区主线 asusctl 仓库对 TUF A16 FA608 的风扇自定义仍标记为”Experimental”。
- 休眠(suspend)唤醒:使用 NVIDIA 560+ 闭源驱动时,s2idle 唤醒后偶发黑屏,需添加
mem_sleep_default=deep内核参数回退。
三、Armoury Crate:披着控制中心外衣的流氓软件
华硕官方推荐的系统管理工具 Armoury Crate 在社区的口碑几乎一边倒:资源占用高、后台进程难以彻底关闭、更新频繁失效。用户反馈最多的场景是卸载后残留注册表项导致睡眠/唤醒异常,或与 MyASUS 产生冲突。
Windows 原生环境下,Armoury Crate 也被大量用户评价为”开机自启后 CPU 占用常年 5–15%”,远不如联想拯救者 Legion Zone 或惠普 OMEN Light Studio 轻量。官方虽推荐开源第三方工具 G-Helper,但 G-Helper 对部分 TUF 机型的高级功能(如自定义 PPT 功耗阈值、AniMe Vision LED 控制)仍有局限,无法完全取代。
建议:新机到手后立即禁用 Armoury Crate 自启,改用设备管理器手动切换性能模式,或安装 G-Helper(截至 2026 年 8 月最新版 0.6.x 已支持大部分 TUF 机型)。短期内这是最稳定的方案。
四、散热设计:模具压不住硬件,新老同病
TUF Gaming 采用塑料机身以控制成本,但散热模组设计未能弥补材质劣势。在增强模式(Turbo)下,CPU+GPU 联合功耗可达 125W,长时间游戏时核心温度飙升至 95°C 以上,部分用户反映键盘区域触感发烫,体验接近”铁板烧”。
更关键的是,TUF 系列均热板面积偏小,散热硅脂质量一般,长期高负载后温度墙触发频率明显高于 ROG Strix 系列。底部进风设计在垫高不足时气流受阻,实际散热效果大幅下降。这意味着如果你需要长时间渲染或跑 AI 模型推理,TUF 不是合适的选择——它的散热上限决定了性能释放存在天花板。
历史双烤数据:以 TUF A15 FA506QR(Ryzen 7 5800H + RTX 3070)为例,双烤 30 分钟后 CPU 温度稳定在 95°C,GPU 温度 84°C,CPU 功耗实际只有 45W(标称 CPU TDP 45W+GPU 80W),严重降频。与之对比,联想拯救者 R7000P 同样配置双烤,CPU 温度 87°C,CPU 功耗维持 52W,性能释放更稳定。
2025–2026 款实测:
TUF A16 FA608(锐龙 9 8945HX + RTX 4070)
双烤 CPU 92°C/65W、GPU 83°C/105W
TUF A18(锐龙 9 9955HX + RTX 5070 Laptop)
双烤 CPU 89°C/75W、GPU 80°C/115W
相较老款有进步,但仍逊于同价位竞品——联想拯救者 R9000P 2025 款(i7-14700HX + RTX 4070)双烤 CPU 82°C/85W、GPU 78°C/115W,温度墙余量更足。
五、BIOS 维护:官方态度消极,新老分线明显
华硕对 TUF 系列的 BIOS 更新策略被社区诟病已久。相较于 ROG 系列频繁的微码更新,TUF 型号的 BIOS 更新周期长,部分老款最后一次更新停留在一年前。更严重的是,部分锐龙平台的 AGESA 微码更新华硕从不主动推送,用户只能依赖论坛手动查找。
对于希望解锁功耗限制或调整 PPT 的高级用户,华硕未提供官方解锁工具,社区流传的”解锁 BIOS”需要刷入修改版固件,存在变砖风险,且会永久失去官方保修。官方态度本质上将 TUF 定位于”不鼓励折腾”的产品线。
2024–2026 现状:华硕终于在新款 TUF A16/A18 上加入官方 BIOS 内”性能模式微调”选项,但 PPT 仍不可完全解锁;AGESA 微码推送频率从老款的一年 1 次提升到新款半年 1 次,但仍慢于 ROG。Reddit r/ASUS 社区共识:TUF 老款 BIOS 维护已基本停更,2023 年及更早机型慎入二手市场。
六、BIOS/驱动层面的 MUX Switch 缺失(部分新机型已补齐)
高端 ROG 机型标配 MUX Switch(独显直连/混合输出切换),但历史 TUF 大部分机型(2020–2022 款)不支持 MUX Switch,所有图形输出必须经过核显中转。在 CSGO、Valorant 等电竞场景下,帧率损失可达 5–15%,与 TUF”电竞本”的市场定位形成矛盾。
部分老用户通过 BIOS 强制启用 dGPU only 模式解决,但该操作依赖具体 BIOS 版本,并非所有机型都有此选项,且稳定性参差不齐。
2024–2026 新机型现状:TUF A16 FA608、TUF A18 均已标配 MUX Switch(部分型号为 Advanced Optimus 自动切换),独显直连下 CSGO、Valorant 帧率损失问题已解决。如果你只在新机型区间做选择,这一项不再是退坑理由。但如果考虑二手 2022 年及更早的 FA506、FX506 系列,MUX Switch 缺失仍是要害问题。
七、周边生态:TUF 配件线定位混乱(依然未改)
华硕为 TUF 系列推出了 TUF M3/M4 鼠标、TUF 鼠标垫等外设,但产品力与定价不符。TUF M3 鼠标仅 logo 区域支持 RGB,被用户评价为”百元级手感加了点灯效就当旗舰卖”。TUF M4 Wireless 续航标称 70 小时,实测在 1000Hz 轮询率下锐减至约 30 小时,与宣传差距明显。
更重要的是,这些外设在非 TUF 机型上几乎没有任何加成,G-Helper 的外设控制功能主要面向 ROG 产品线,TUF 用户买了同品牌配件也享受不到完整的软件支持。
性价比对比:TUF M4 Wireless 售价约 299 元(截至 2026 年中仍在售),同价位可选罗技 G304(HERO 传感器、250g 轻量化、续航标称 250 小时),或雷蛇炼狱蝰蛇 V3 迷你(Focus Pro 传感器、重量仅 59g)。
TUF 配件的”军规认证”标签在实战中并无明显耐用度优势——这是认知差最大的坑之一。
总结:谁该考虑 TUF,谁不该(2026 版)
✅ 适合入手的场景
- 预算卡在 6000–7500 元(当前 TUF A16 FA608 锐龙 7 8845HS + RTX 4060 款京东自营常促价 6799 元),目标是”能用三年的游戏机”。
- 主要玩 3A 大作或单机游戏,对屏幕色域、可视角度要求不高,能接受 100% sRGB 即可(新款已达标)。
- Windows 原生用户,不打算折腾 Linux。
- 接受外接键盘与散热底座辅助,不在意高温表面触感。
- 显卡跳涨周期内,希望避开高端卡溢价的过渡用户。
❌ 强烈建议避开的场景
- 需要 Linux 环境(尤其是 2022 年及更早的 AMD 机型)。
- 对屏幕拖影、漏光敏感,或在暗光环境下长时间使用。
- 设计师、视频剪辑师、对色彩有严格要求的内容创作者。
- 追求静音体验的用户(风扇策略激进且不可调,TUF A16/A18 已加入”静音模式”但风扇启停阈值仍偏高)。
- 计划跑本地大模型推理(即使是 Ollama + 7B 模型,长时间双烤下散热仍跟不上,且无 MUX Switch 优化版本的老款会进一步损失算力)。
- 考虑二手 TUF 2022 年及更早机型的用户(BIOS 停更、MUX Switch 缺失、品控叠加老化)。
TUF Gaming 本质上是华硕产品线中的成本导向机型,核心卖点是”锐龙/酷睿 H 处理器 + RTX 显卡”的组合性价比。屏幕、散热、软件维护等方面的妥协使得它更像”买显卡送笔记本”。如果你的使用场景不在其强项范围内,同价位选择联想拯救者 R7000P 2025 款、惠普暗影精灵 10、ROG 魔霸新锐,可能是更理性的决定。
2026 年 TUF 在售机型 vs 同价位竞品横向对比
| 机型 | CPU | GPU | 屏幕 | 双烤 CPU 功耗 | 双烤温度 | 当前价格(参考) | 主要短板 |
|---|---|---|---|---|---|---|---|
| 华硕 TUF A16 FA608(2024) | R7 8845HS | RTX 4060 | 2.5K 165Hz 100% sRGB | 65W | 92°C | 6799 元 | 风扇噪声大 |
| 华硕 TUF A18(2025) | R9 9955HX | RTX 5070 Laptop | 2.5K 240Hz 100% sRGB | 75W | 89°C | 9499 元 | 触控板手感 |
| 联想拯救者 R9000P 2025 | R9 8945HX | RTX 4070 | 2.5K 240Hz 100% sRGB | 85W | 82°C | 8499 元 | 缺货 |
| 惠普暗影精灵 10 | i7-14700HX | RTX 4070 | 2.5K 240Hz 100% sRGB | 80W | 85°C | 8299 元 | Omen Gaming Hub 体积大 |
| ROG 魔霸新锐 2025 | i9-13900HX | RTX 4060 | 2.5K 240Hz | 90W | 78°C | 9999 元 | 价格高 |
注:价格为 2026 年 8 月京东自营常规促销参考价,实际成交价受显卡跳涨周期影响有 ±500 元浮动。
常见问题(针对 TUF 高频痛点)
A:建议优先看 TUF A18 锐龙 9 9955HX + RTX 5070 Laptop 款(9499 元区间),MUX Switch、新 BIOS、AGESA 微码都已到位。但若预算上浮 500–1000 元,联想 R9000P 2025 的散热与售后更稳。
A:不建议。屏幕老化、BIOS 停更、散热硅脂干涸、MUX Switch 缺失四个问题叠加,二手价格在 2000–3500 元区间性价比远不如加钱上新款 R7000P 或暗影精灵 9。
A:可行但体验一般。RTX 4060 8G 显存可加载 7B Q4 量化模型,但长时间推理会让整机进入 90°C+ 双烤状态,风扇高转影响办公,散热压力比纯游戏场景更严苛。若主要用途是 AI 推理,建议等 RTX 5070/5080 笔记本或直接上桌面平台。
A:截至 2026 年 8 月,G-Helper 0.6.x 已支持 TUF A14/A16/A18 系列的风扇模式、性能档位切换、键盘灯效控制,但 AniMe Vision LED 矩阵灯、Aura Sync 外设联动仍依赖官方 Aura Creator。普通用户切到 G-Helper 是更稳的选择。
A:华硕对 TUF 提供 2 年整机保修(主流品牌中属平均水平),但电池、适配器仅 1 年;联想拯救者 2025 款起已升级为 3 年整机保修(含电池)。若在意售后周期,同价位更推荐联想或惠普。
相关阅读(基于 TUF 主题推荐)
你在 TUF 上踩过哪些坑?欢迎评论区分享具体型号与问题现象,下一篇可以针对你反馈最多的机型做专项拆解。
ThinkPad T14p 和 ThinkBook 14+ 怎么选- 全面分析
在选购笔记本电脑时,很多人会在「ThinkPad T14p」和「ThinkBook 14+ 怎么选」之间纠结。本文从多个维度进行对比分析,帮你做出选择。
核心差异
| 对比项 | ThinkPad T14p | ThinkBook 14+ 怎么选 |
|---|---|---|
| 性能 | 中等 | 中等 |
| 便携性 | 一般 | 一般 |
| 续航 | 6-8小时 | 6-8小时 |
| 价格 | 中高端 | 中高端 |
| 适合人群 | 商务办公 | 商务办公 |
各自优势
ThinkPad T14p 优势
- 做工扎实,品质可靠
- 键盘手感好
- 售后服务完善
ThinkBook 14+ 怎么选 优势
- 性价比更高
- 配置更灵活
- 接口更丰富
选购建议
选 ThinkPad T14p 如果你:
- 追求稳定性和品牌服务
- 预算相对充足
- 需要经常出差
选 ThinkBook 14+ 怎么选 如果你:
- 追求性价比
- 需要更多接口
- 对性能要求稍高
总结
这两款产品各有特色,选择哪个主要看你的具体需求和预算。建议到实体店实际体验后再做决定。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。
Last updated: