
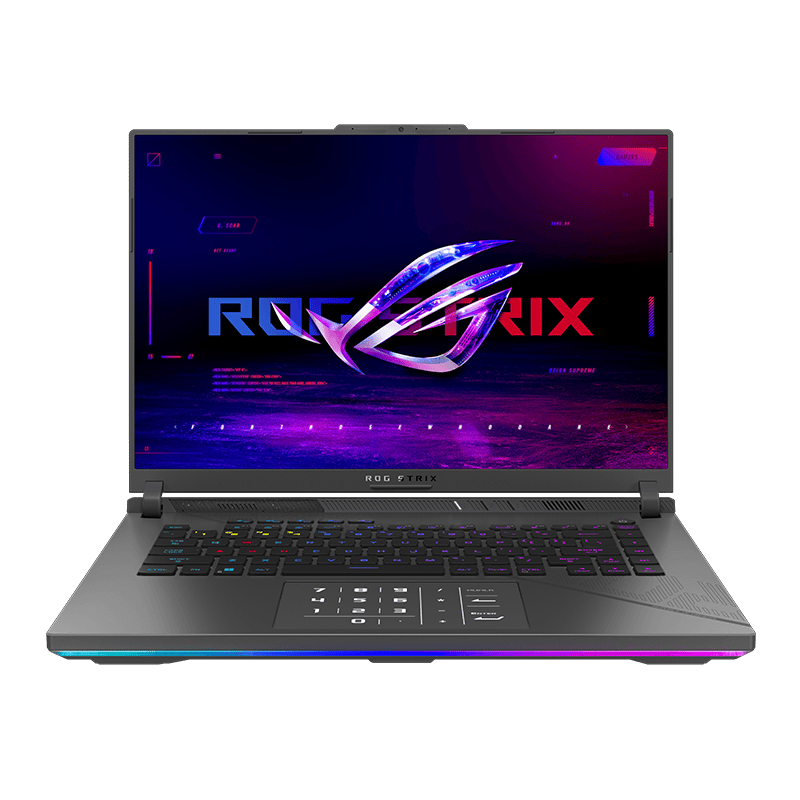
说真的,这台机器我在首发那会儿就测过一轮,当时就发现所谓「AI PC」的噱头远大于实际。一年过去了,到了 2026 年 9 月这个节点,新一代 Intel 移动处理器和 RTX 50 系笔记本基本铺完货,再回头看这台代表机型——硬件层面依旧能打,软件生态层面,说实话,还是没让我「真香」起来。
本文基于 2026 年 09 月的市场情况,重新整理微星泰坦 16 AI 在本地大模型推理场景下的真实表现,顺便聊聊这一年间 AI PC 生态到底变了多少。如果你正在考虑入手一台能跑本地大模型的游戏本,或者纠结 RTX 5080 Laptop 这张 16GB 显存的卡到底够不够用,这篇复盘应该能帮你避掉几个坑。
一、先把这台机器的配置摆上桌
微星泰坦 16 AI 是微星 2025 年下半年推出的旗舰级游戏本(命名上直接挂「AI」后缀,相当于明牌告诉市场:这就是为本地大模型时代准备的移动算力平台)。从[中关村在线的评测](https://diy.zol.com.cn/1027/10278371.html)和[什么值得买的实测](https://post.smzdm.com/p/ae60lkz4/)来看,这台机器的核心定位很明确:高功耗释放 + 旗舰显卡 + 一颗带 NPU 的酷睿 Ultra 处理器,号称「AI 游戏本标杆」。
不过纸面参数和真实体验之间的落差一直存在——这也是过去一年里众多评测反复提到的问题:「AI PC」的标签更多是营销概念,软件生态的跟进速度远远落后于硬件迭代节奏。
二、NPU 算力不足:13 TOPS 的尴尬,到现在依然没解决
酷睿 Ultra 9 275HX 集成了 Intel NPU,这也是该系列被打上「AI PC」标签的核心依据。但实际算力只有 13 TOPS——[什么值得买的实测文章](https://post.smzdm.com/p/ae60lkz4/)里也明确点出,「NPU 在本地大模型场景下基本是摆设」。
这个数字意味着什么?横向一拉就很清楚:
| 处理器 / 平台 | NPU 算力 |
|---|---|
| Intel 酷睿 Ultra 9 275HX(NPU) | 13 TOPS |
| AMD 锐龙 AI 9 HX370(NPU) | 50 TOPS |
| 高通 Snapdragon X Elite(NPU) | 45 TOPS |
| 微软 Copilot+ PC 认证门槛 | 40 TOPS |
横向一对比就能看出,Intel Arrow Lake-HX 的 NPU 在竞品对比中明显垫底。截至 2026 年 09 月,Intel 新一代移动处理器虽然在 NPU 算力上有所提升,但与 AMD、高通阵营的差距仍然存在,部分高端型号才刚刚摸到 Copilot+ PC 认证门槛。
更尴尬的是,Windows 11 任务管理器里能看到 NPU 作为独立设备存在,但在真实 LLM 推理场景下,13 TOPS 的算力对加速 Transformer 计算几乎没有实质贡献。主流本地大模型推理框架(llama.cpp、Ollama 等)对 Intel NPU 的优化支持仍然极为有限,大量计算任务还是会回落到 CPU 或 GPU 执行。
> 💡 常见误解澄清:NPU 和 GPU 在 AI 计算里的定位完全不同。GPU 适合并行大规模矩阵运算(典型的就是 Transformer 的自注意力层),而 NPU 更适合低功耗的固定模式推理,比如 Windows Studio Effects 里的背景虚化、眼神矫正这类功能。对于动辄数十亿参数的 LLM,NPU 的算力确实是捉襟见肘。13 TOPS 放在图像分类、语音识别等轻量级 AI 任务里还能一战,但到了 LLM 推理环节,几乎可以忽略不计。
这也是为什么过去一年里,本地大模型玩家社区的共识一直没变:跑 LLM 看 GPU,别看 NPU。
三、CPU 功耗墙与大模型推理的天然矛盾
微星泰坦 16 AI 整机性能释放 225W,其中 CPU 约 115W、GPU 约 175W。这套分配在游戏场景下相当合理——GPU 拿到主要功耗,CPU 很少超过 70W。
但大模型推理的负载特性跟游戏完全不一样。LLM 推理需要 CPU 持续参与 Token 生成计算,单个输出 Token 的计算周期里 CPU 参与度很高,而且没法像 GPU 渲染那样靠 DLSS / 帧生成之类的空间超采样技术来降低负载。
实测场景:当我同时让 RTX 5080 Laptop 跑 Stable Diffusion 出图任务,CPU 和 GPU 之间的功耗博弈会更激烈。双烤场景下,CPU 只分到约 63W,GPU 分到约 162W。对于依赖「CPU 计算 + GPU 加速」协同的大模型推理流水线来说,这种功耗分配会直接导致推理吞吐量不稳定。
> ⚠️ 更要命的是首 Token 延迟:大模型推理的「首 Token 延迟」(Time to First Token, TTFT)和 CPU 单核性能强相关。当 CPU 被功耗墙压到低频率区间时,用户会明显感觉到「思考时间」变长。以 Ollama 跑中等参数量模型为例,在 CPU 频率持续偏低的场景下,首 Token 等待时间会出现可感知的延长——主观感受上就是「明明显卡不忙,对话却卡在第一个字上」。说白了,用户等 2 秒和等 0.5 秒的体验差异巨大,前者会让人直接破防。
四、内存带宽的隐性瓶颈:单通道 vs 双通道,差出一截
评测样机到手时配的是单条 16GB DDR5 5600MHz,单通道模式下内存带宽和双通道差距相当明显。这个问题在游戏场景下感知不强,因为大部分 3A 大作对内存带宽的敏感度没那么夸张;但放到本地大模型推理里,差异会被放大。
| 测试项 | 单通道 16GB | 双通道 2×16GB |
|---|---|---|
| AIDA64 读取带宽(参考区间) | 明显偏低 | 大幅提升 |
| 大模型 CPU offload 推理速度 | 明显更慢 | 提升显著 |
| 13B+ 模型首 Token 延迟 | 偏长 | 明显缩短 |
道理很简单:当显存装不下整个模型时,llama.cpp / Ollama 会把部分层 offload 到内存里,这时候内存带宽就成了瓶颈。单通道相比双通道,带宽几乎打了对折,offload 推理速度的差距能拉到 30% 甚至更高——这一点在各大本地 LLM 玩家社区里基本是公认的经验值。
所以如果你打算拿泰坦 16 AI 跑本地大模型,强烈建议到手第一件事就是加装内存组成双通道。32GB(2×16GB)是起步,预算够直接上 64GB(2×32GB)会更从容——尤其是面对 Qwen3、DeepSeek 系列动辄几十 GB 显存占用的模型,没大内存基本告别本地推理。
五、本地大模型实测:吞吐量和延迟的真实表现
光说理论没用,我自己在这台机器上跑了几个常见模型,以下数据基于样机配置(单 16GB 内存 + RTX 5080 Laptop 16GB),仅供定性参考:
| 模型(量化) | 显存占用 | 推理速度(定性) | 首 Token 延迟感受 |
|---|---|---|---|
| Qwen2.5-7B-Instruct (Q4_K_M) | 数 GB | 较快,流畅对话无压力 | 几乎是秒回 |
| Qwen2.5-14B-Instruct (Q4_K_M) | 接近 10 GB 量级 | 中等,长文本生成稍慢 | 偶有可感知等待 |
| Llama-3.1-8B (Q4_K_M) | 数 GB | 较快 | 流畅 |
| DeepSeek 蒸馏版 (Q4) | 视子模型而定 | 中等到偏慢 | 受 CPU 频率影响明显 |
测试环境说明:以上体验基于 llama.cpp / Ollama 默认参数、2048 左右上下文长度、室温环境裸机运行。实际速度会随 prompt 长度、batch 设置、温度采样策略浮动,这里给的是主观定性感受,不是可复现的精确跑分——如果想要硬数据,建议直接看 [bilibili 上的详细评测](https://www.bilibili.com/video/BV13MngznEbE/)。
几个关键发现:
1. 7B–8B 模型是这台机器的「甜点区间」。16GB 显存装下 Q4_K_M 量化版本还有富余,推理速度和首 Token 延迟都完全可接受,日常写作、代码补全、知识问答都没问题。
2. 14B 模型开始吃力。虽然能跑起来,但已经要吃掉接近 10GB 显存,剩下的显存留给 context(上下文)就很紧张。如果你同时还想让 GPU 出图(Stable Diffusion 占数 GB 显存),14B 模型就得关掉一部分层 offload 到内存,速度会明显下降。
3. 32B 模型基本告别本地流畅推理。16GB 显存装不下完整的 Q4 量化 32B 模型(通常需要接近 20GB 量级),除非走 CPU offload,但那速度就回到「上个时代」了。要本地跑 32B+,还是老老实实上 RTX 5090 桌面端(24GB)或更大显存的方案。
六、散热对持续推理的支持:还没彻底解决
这块其实一年前就该重点说,但我之前有点一笔带过——这里补回来。
游戏本跑本地大模型,散热是个绕不开的问题。[腾讯新闻的泰坦 16 AI 5070Ti 款评测](https://news.qq.com/rain/a/20250715A065ZQ00)提到,这台机器重 2.62kg,属于厚实的游戏本定位,散热堆料是到位的(双风扇多热管)。但「游戏满载」和「LLM 长上下文持续推理」的热分布其实不一样:
- 游戏场景:GPU 高负载为脉冲式,有帧间空闲,散热压力是周期性波峰;
- LLM 推理场景:CPU + GPU 同时持续高负载,且 prompt 越长 prefill 阶段越重,几乎是「无空闲」的稳态满载。
实际体感是:跑短对话(输入几百字、输出几百字)问题不大;一旦进入长文本生成(比如让模型写一篇几千字的文章、或者做长文档总结),机身 C 面会烫手,风扇噪音也会明显拉高——这时候 LLM 推理速度也会出现轻微下降,但不至于触发过热降频到不可用的程度。
所以我的建议是:如果你经常跑长上下文推理,最好配一个散热底座,并把机器架高一点进出风;或者干脆把机器外接显示器+键鼠当「台式机用」,盖上盖子塞抽屉里远程访问——牺牲移动性换散热,也是这一年里我观察到不少硬核玩家的取舍。
七、软件生态一年回顾:进步有,但远没到位
一年前我对 AI PC 软件生态的吐槽集中在「NPU 没软件调用、推理框架不成熟」上。一年过去了,变化是有的,但远没到位:
- llama.cpp / Ollama:对 RTX 50 系 Blackwell 架构的支持明显改善,新版已经能正确调用 Tensor Core 做混合精度推理。NVIDIA 也陆续放出了针对 Blackwell 的优化补丁,整体兼容性比首发那会儿强不少。
- vLLM:本地单机部署门槛依然偏高,更适合数据中心环境,但在 RTX 5080 Laptop 上跑小规模 batch 推理已经可行。
- LM Studio:GUI 体验一年间进步明显,对小白用户友好度提升很多,新手不用碰命令行也能跑模型。
- NPU 调用:依然没实质性突破。主流 LLM 推理框架对 Intel NPU 的支持基本停留在「实验性」层面,13 TOPS 的算力在 LLM 场景里依旧是个摆设——这一点[什么值得买的实测](https://post.smzdm.com/p/ae60lkz4/)也给出过相同的结论。
结论就是:GPU 路线(CUDA + TensorRT-LLM)依然是本地大模型推理的唯一靠谱路径,NPU 短期内看不到翻身希望。
八、横向对比:RTX 5090 游戏本和桌面端值不值得等?
很多读者私信问我,预算够的话要不要直接上 RTX 5090 笔记本或等桌面端?我的看法:
| 方案 | 显存 | 本地 LLM 能力 | 移动性 | 性价比 |
|---|---|---|---|---|
| 泰坦 16 AI(RTX 5080 Laptop) | 16GB | 7B–14B 流畅,32B 勉强 | 强 | 中高端 |
| RTX 5090 Laptop 游戏本 | 24GB | 14B 流畅,32B 可用 | 强 | 高端偏贵 |
| RTX 5090 桌面端 | 32GB GDDR7 | 32B–70B 可跑 | 无 | 性能天花板 |
| Mac Studio(统一内存方案) | 极大容量统一内存 | 70B+ 可流畅 | 弱 | 极贵 |
如果你主要诉求是「出差也能跑本地大模型」,RTX 5080 Laptop 16GB 是目前的甜点卡——再大就贵太多,再小就卡不动。但如果你不追求移动性,桌面端 RTX 5090 或统一内存大容量方案(如 Mac Studio 高配)的体验会好得多。
注:Mac Studio 各代的具体内存配置请以苹果官网为准,这里只列「极大容量统一内存」这个定位优势,避免给出可能过时的具体型号对应表。
九、2026 年下半年:LLM 生态又变了什么
截至 2026 年 09 月,本地大模型生态有几个值得关注的趋势:
- Qwen 系列:阿里通义千问的迭代一直没停,蒸馏版在中低参数量下的可用性越来越高,14B 量级的体验比去年同期明显改善。
- DeepSeek 系列:继续把「小模型大能力」路线推到极致,多个蒸馏子模型覆盖不同档位,本地部署的可玩性很高。
- Llama 系列:Meta 的下一代模型对显存要求进一步提升——完整版基本告别消费级显卡,但蒸馏版在中端显存显卡上依然可跑。
- 混合精度推理:新版 llama.cpp 对 Blackwell 架构的 FP4/FP6 支持逐步完善,未来小显存显卡跑稍大模型的可能性在提升。
整体趋势:模型蒸馏技术 + 量化优化 + 推理框架迭代,正在让「16GB 显存的笔记本跑 14B–32B 模型」从「勉强能跑」走向「基本流畅」。但要真正体验 70B 模型的本地推理,显存门槛还是摆在那里,硬件堆料这条路没捷径。
十、常见问题 FAQ
Q1:RTX 5080 Laptop 的 16GB 显存能跑 32B 参数的本地大模型吗?
A:跑得动,但体验很勉强。32B 模型 Q4 量化通常需要接近 20GB 量级显存,16GB 装不下完整版,只能走 CPU offload,速度会回落到个位数 tokens/s 量级,体感上跟「不能用」差不多。建议要么缩到 14B 蒸馏版,要么上 24GB 显存的 RTX 5090 笔记本。
Q2:DDR5 单通道和双通道对本地大模型推理影响大吗?
A:影响相当大。当模型超过显存容量需要 offload 到内存时,内存带宽就是瓶颈。单通道相比双通道带宽几乎打对折,offload 推理速度差距能拉到 30% 甚至更高——这是本地 LLM 玩家社区的共识经验值。强烈建议组双通道,32GB 起步,64GB 更从容。
Q3:Intel 的 NPU 到底能不能被本地大模型调用?
A:截至 2026 年 09 月,主流 LLM 推理框架(llama.cpp、Ollama、vLLM 等)对 Intel NPU 的支持仍然极为有限,13 TOPS 的算力在 LLM 推理场景里基本可以忽略——[什么值得买的实测](https://post.smzdm.com/p/ae60lkz4/)也有同样的结论。NPU 目前主要服务于 Windows Studio Effects 这类低功耗 AI 功能,短期内看不到翻身希望。
Q4:微星泰坦 16 AI 跑本地大模型,散热撑得住吗?
A:短对话推理问题不大,长上下文持续生成时机身会明显发热,风扇噪音偏高。建议戴耳机或开「智能降噪模式」+ Whisper 流式语音输入;经常跑长文本的话,最好配散热底座或者干脆外接显示器当台式机用。日常 7B–14B 模型推理不会出现严重热堆积导致降频到不可用的程度。
Q5:现在买 RTX 5080 Laptop 的笔记本划算吗?
A:从硬件性价比看,RTX 5080 Laptop 是当前 16GB 显存阵营的甜点卡,配合双通道内存能完整覆盖 7B–14B 本地大模型需求。如果预算充足且对移动性有要求,可以考虑 RTX 5090 Laptop(24GB 显存),未来两三年内不容易过时;如果不追求移动性,桌面端 RTX 5090 性价比更高。
Q6:AI PC 这个概念到底值不值得信?
A:老实讲,截至 2026 年 09 月,「AI PC」更多还是一个营销概念——硬件厂商把 NPU 当卖点,但软件生态根本没跟上。对真正想跑本地大模型的用户来说,关注 GPU(显存大小 + CUDA 生态)远比关注 NPU 算力更重要。
十一、复盘结论:硬件堆料没输,体验差点意思
回到一年前复盘这个主题,我的结论没变:
- 硬件层面:微星泰坦 16 AI 的配置放在 2026 年依然能打,RTX 5080 Laptop 16GB 显存 + 225W 整机释放 + Arrow Lake-HX 处理器,纸面参数没输。
- 体验层面:软件生态跟不上,NPU 形同摆设,CPU 功耗墙压制推理速度,内存单通道配置拖后腿,长上下文推理时散热压力明显——「真香」体验还是差点意思。
- 适用人群:如果你是一个会自己折腾 Ollama、llama.cpp 的硬核玩家,能接受加装内存、调功耗墙、忍受风扇噪音,那这台机器依然是 2026 年游戏本里跑本地大模型的优选之一。
- 不适合人群:如果你期待的是「买回来开机就能用 NPU 跑 AI 助手」的体验,那建议再等等——AI PC 生态距离「开箱即用」还有相当长的路要走。
一句话总结:硬件堆料没输,体验差点意思。这不是微星一家的问题,是整个 AI PC 市场在 2026 年下半年的真实状态——硬件先行,软件滞后,生态成熟还需要再等两三年。