
Moltbook 数据库雪崩复盘:PostgreSQL RLS 在 AI Agent 平台高并发下的性能陷阱

2026 年 2 月,AI Agent 平台 Moltbook 上线仅 120 小时即全面瘫痪。安全机构 Wiz 的事故报告只是点燃了舆论关注度的引线——真正的性能灾难,早在高并发 Agent 涌入数据库的那一刻就已经埋下。这场事故暴露的,是 PostgreSQL RLS(Row Level Security)在 AI Agent 平台 + Supabase 架构下被严重低估的高并发陷阱。
一、事故现场:监控数据还原性能雪崩全过程
事故前的监控截图与指标曲线清晰地记录了崩溃是如何一步步发生的:
- 数据库 CPU 从 30% 平稳状态飙升至 100%,并持续 40 分钟无法回落
- API 响应 P99 Latency 从 120ms 恶化至 4.5s,放大 37 倍
- Supabase 连接池耗尽,新请求直接被拒绝,前端表现为大面积超时
表面看像是流量过大引发的简单容量问题,但工程师溯源后发现:根因是一个看起来”更安全”的决策——开启 PostgreSQL RLS 之后,查询性能反而雪崩。
二、背景:RLS 是什么,为什么 Moltbook 选择它
RLS(Row Level Security,行级安全策略)是 PostgreSQL 9.5 引入的核心安全特性。它允许数据库在 SQL 执行层而非应用层强制执行访问控制,理论上能做到:
| 特性 | 传统应用层权限控制 | 数据库 RLS 层权限控制 |
|---|---|---|
| 数据隔离 | 依赖应用代码 WHERE 过滤 | 数据库内核强制执行 |
| 越权风险 | 应用漏洞即可导致数据泄露 | SQL 层面无法绕过 |
| 多租户管理成本 | 每个应用需单独实现 | 策略统一管理 |
| 审计追溯 | 依赖应用日志 | 数据库日志完整可查 |
| 性能开销 | 通常较低 | 随策略数量与并发量显著增长 |
Moltbook 作为 AI Agent 平台,业务模型涉及大量用户的私密对话、Agent 配置、个人偏好数据。在 agents、conversations、messages 这三层嵌套表结构中,每一层都包含多租户数据。选择开启 RLS 本是合理且正确的安全决策——然而,这个决策在超大规模并发场景下,暴露出设计时未充分考虑的性能隐患。
三、深层原因:RLS 策略评估的四重高并发陷阱
1. 策略评估计算成本被严重低估
RLS 的工作原理决定了它的开销:每一条 SQL 在执行前,都要经过所有已启用的 Policy 评估。Moltbook 事件中,对外宣传的 Agent 数量被推至 150 万量级,真实脚本并发也能轻松达到 10 万级别。当 10 万个 Agent 同时通过脚本并发写入时,PostgreSQL 的 RLS Policy Evaluation 产生了近似笛卡尔积级别的计算压力。
-- 实际执行时,数据库内部等价于:
SELECT * FROM agents
WHERE
  owner_id = auth.uid()                                          -- Policy 1: 所有权检查
  AND agent_status IN (
    SELECT status FROM agent_status_policies WHERE ...
  )                                                              -- Policy 2: 状态过滤
  AND EXISTS (
    SELECT 1 FROM users
    WHERE users.id = agents.owner_id
      AND users.banned = false
  );                                                              -- Policy 3: 用户状态联查
Moltbook 的 schema 设计中,agents 表挂了 7 条 RLS 策略,其中 3 条涉及跨表 JOIN。在 10k+ 并发写入场景下,每条 SQL 的策略评估耗时从基线的 0.5ms 膨胀至接近 200ms,呈数百倍级别恶化。
2. 策略数量膨胀引发的隐性放大
很多人以为只要 SQL 写得快,RLS 就不慢。但实际上,RLS 的评估成本不是线性叠加,而是随策略数量与策略复杂度乘法级放大。以 7 条策略、3 条带 JOIN 为例,在最坏情况下数据库需要为每一条进入 agents 的 SQL 同时评估 7 次条件判断 + 3 次子查询或关联查询。当基础表行数超过千万级、单次 Policy 评估本身就要扫描数万行时,整体 P99 延迟会被迅速推高到秒级。
3. 跨表 JOIN 评估导致的执行计划膨胀
带 EXISTS、子查询或 JOIN 的 RLS 策略,最大的隐患在于:优化器无法把这些策略条件视作普通谓词下推。在某些情况下,PostgreSQL 会选择先做全表扫描再过滤,而不是利用索引;当多个策略并存时,规划器甚至会生成多个相互冲突的执行计划,导致 CPU 长时间处于规划与重规划状态。Moltbook 事故中观测到的”CPU 100% 持续 40 分钟回落不了”,很大一部分时间是被规划器与策略评估共同吃掉的。
4. 连接池争抢放大故障半径
RLS 评估变慢直接导致单条 SQL 持有连接的时间变长。Supabase 默认的连接池在事务模式下容量是有限的,当所有连接都被慢查询占住时,新请求拿不到连接就被拒。这正是 Moltbook 出现”连接池耗尽”的原因——它不是流量问题,而是被 RLS 拖慢的慢查询把连接池堵死了。
四、解决方案与优化建议:给 PostgreSQL + RLS 用户的实操清单
对正在使用 RLS 的 PostgreSQL 团队(尤其是 Supabase 用户),可参考以下递进式优化策略:
策略层:减少单表 RLS 策略数量
- 将可以合并的多个策略合并为一条
USING (...)表达式,避免单表超过 4–5 条 Policy - 不在 RLS 策略中写
auth.uid() = (...),再 JOIN 一张用户表,如果能在 users 表上保证id = auth.uid()可直接索引,应改写为对索引列的等价判断 - 对极少使用的安全规则改用应用层校验,避免冷策略持续被评估
下沉层:把跨表 JOIN 策略沉到应用层
- 当策略涉及 EXISTS 子查询或跨表时,评估一次的成本远高于在应用层加一次 JOIN
- 用物化视图或缓存表把”用户状态/账户封禁”等慢变字段提前同步到
agents表的冗余列,RLS 改为纯本地列判断 - 谨慎使用
security_barrier = true,它在提升安全性的同时也会禁用谓词下推,仅在确实存在侧信道攻击风险时再开启
索引层:用 partial index 与函数索引优化
- 对 RLS 策略中的常用谓词组合建立 partial index,例如
CREATE INDEX ... ON agents(owner_id) WHERE deleted_at IS NULL - 如果策略里有
auth.uid()这种稳定函数,可考虑将其结果物化进会话变量或表列,配合部分索引提升命中
架构层:读写分离分摊压力
- 把热写入路径与冷查询路径拆到不同 Supabase Project 或不同 PostgreSQL 实例
- 利用 Supabase 的 Read Replica,把读流量分流到只读节点,避免读路径的 RLS 评估抢占主库 CPU
- 在 Supabase 池化配置上,将
pool_mode切到transaction并合理调高max_client_conn,配合应用层限流,避免雪崩
观测层:必加的 RLS 监控项
- 启用
pg_stat_statements,记录被 RLS 拖慢的 Top SQL - 监控
pg_locks与pg_stat_activity中长事务,及时 kill 持锁过久的 RLS 查询 - 在 Supabase 控制台打开
log_min_duration_statement,对超过 1s 的查询全量采样
五、事故后续与行业影响:2026 年的修复进展与社区回应
截至 2026 年 8 月,Moltbook 事故发生已过去约半年,行业内出现了几个值得关注的修复与讨论动向:
- Supabase 侧:官方在 2026 年 Q2 发布的更新中强化了连接池在事务模式下的背压能力,并新增了”策略数量超阈值告警”,帮助团队提前发现 RLS 复杂度过高的表。多个第三方报告显示,更新后类似规模的并发写入场景下,连接耗尽的发生概率明显下降。
- PostgreSQL 社区侧:在 PG 全球开发者邮件列表与年度大会上,出现了若干篇关于”RLS 在多租户 SaaS 中的真实开销”的实测分享。主流建议趋于一致:RLS 适合做”最后一道兜底防线”,而非唯一的访问控制机制;复杂的业务级访问规则仍建议交由应用层处理。
- Moltbook 侧:根据公开的事故复盘文章与社区讨论,Moltbook 在事故后对
agents、conversations、messages三张核心表进行了策略精简与冗余列改造,将单表 RLS 策略条数从 7 条压缩到 3 条以内,并启用了读副本分流。短期内仍偶发的小规模延迟问题,已通过连接池扩容与限流策略被压住。 - 更广泛的影响:2026 年上半年陆续有数家 AI Agent 平台在技术博客中复盘自家踩过的 RLS 坑,使得”RLS 适合做兜底而非主力”几乎成为业内共识。PostgreSQL 生态内围绕”如何在不放弃安全性的前提下压低 RLS 评估开销”的工具与中间件也明显增多。
六、给 AI Agent 平台架构师的避坑清单
- 不要把 RLS 当唯一的访问控制层。它适合做安全兜底,复杂的业务权限仍应走应用层。
- 单表 Policy 总数控制在 4 条以内,跨表策略不超过 1 条。
- 跨表 JOIN 的 RLS 策略是高危项,要么下沉到应用层,要么用冗余列 + 本地判断替代。
- 写并发高的表尤其需要谨慎评估 RLS,一条慢评估拖垮整池连接是真实发生过的。
- 把 Supabase 连接池容量视为安全冗余的一部分,但不要把它当作性能银弹。
- 新表上线前做一次高并发回放,重点看 RLS 评估有没有激增。
- 持续关注 pg_stat_statements 中被 RLS 拖慢的 Top SQL,定期回顾能不能砍。
七、常见问题(FAQ)
Q:RLS 是不是不能用了?
A:不是不能用,而是不能滥用。RLS 在中小规模、多租户需要严格数据隔离的场景下仍是首选,但在大规模高并发场景下需要搭配上述优化手段使用。
Q:不开 RLS,有没有等价的替代方案?
A:可以在应用层通过统一的 ORM 中间件或独立的 BFF 服务集中处理权限过滤,效果接近但绕开了数据库层的开销,代价是要自己保证所有写入路径都经过中间件。
Q:怎么判断现在的 RLS 策略是不是太多?
A:如果单张表 RLS 策略超过 5 条,或者存在跨表 EXISTS/JOIN 的策略,又或者 pg_stat_statements 中命中该表的 SQL 平均耗时显著高于同结构无 RLS 表,那就该精简了。
Q:Supabase 项目默认就开 RLS 吗?我新表创建需要注意什么?
A:Supabase 在新建表时默认会启用 RLS,但不会自动加任何策略,等于”开了门但没发钥匙”,访问会被默认拒绝。建议新表创建时同步敲定策略,并按上文清单做一次复杂度评估。
Q:有没有办法在保留 RLS 安全性的前提下基本消除性能影响?
A:在 2026 年的工程实践里,比较成熟的组合是:精简策略到 3 条以内 + 冗余列替代跨表 JOIN + 读写分离 + 部分索引命中。这套组合下,RLS 对 P99 延迟的影响通常可以控制在毫秒级。
千亿美元 AI 并购暗战:拆解 OpenAI 与 Google 两条路线的终极博弈
科技巨头的大模型并购布局正在重塑 AI 行业格局。截至 2026 年 8 月,OpenAI 与 Google(Alphabet)两条截然不同的并购路线已经从早期探索进入深度博弈阶段。本文从战略逻辑、技术整合深度、生态影响三个维度,对比分析这两条路线的成败得失与未来走向。
背景:两条并购路线的形成
OpenAI 选择垂直整合路线。2023 年微软以约 100 亿美元(含现金+云资源)注资 OpenAI,获得独家云服务商地位。这笔交易本质是将 OpenAI 技术深度绑定 Azure 生态,而非传统意义的全资并购。OpenAI 保持独立运营主体,微软通过资本+算力的方式实现控制。
Google 则采取激进的重磅投资/全资收购路线。2023-2026 年间,Google 先后向 Anthropic 累计投资约 60 亿美元、收购 Fitbit(21 亿美元)、投资 MandrAI 等,并在 2024 年斥资约 25 亿美元回购员工股份。这种打法追求高比例控股或 100% 控股,技术团队直接并入或深度绑定 Google 内部。
| 维度 | OpenAI 路线 | Google 路线 |
|---|---|---|
| 典型案例 | 微软-OpenAI(约 100 亿$) | Google-Anthropic(累计约 60 亿$) |
| 控股方式 | 少数股权+独家合作 | 高比例控股或战略合作 |
| 技术归属 | 技术留在被投企业 | 技术深度绑定母公司 |
| 团队整合 | 保持独立运营 | 部分融入、部分保留独立 |
一、OpenAI 路线的底层逻辑
1.1 资本换算力的核心公式
OpenAI 路线本质是「资本换算力」的交易结构设计。微软 100 亿美元投资中(具体现金与 Azure 云信用额度的比例未见官方完整披露,业内普遍认为现金占比较高、但相当一部分以 Azure 算力承诺形式交付),这意味着:
- 对微软而言:不是收购 OpenAI,而是「购买」了一个每年消耗数十亿美元算力的 AI 客户,同时获得 GPT 能力的优先使用权。
- 对 OpenAI 而言:不是卖身,而是用股权换取了在 Azure 上训练 GPT-4、GPT-5 乃至后续模型的算力保障。
这种结构的精妙之处在于风险隔离。若 OpenAI 失败,微软的损失可控(Azure 仍可向其他客户供货);若 OpenAI 成功,微软通过云服务抽成 + Office 365 AI 变现 + Azure 算力消耗三条线获得回报。
进入 2025 年,OpenAI 又联合软银、Oracle、MGX 推出 Stargate 千亿美元级 AI 基础设施计划,进一步把”资本换算力”的逻辑推到极致——OpenAI 用未来股权承诺换取的是主权级别算力池。而 2025-2026 年间席卷全球的 GPU 涨价潮,更让”算力即筹码”这一逻辑被反复验证。
1.2 独立性的价值从何而来
OpenAI 坚持独立运营的根本原因在于估值逻辑。2024 年 OpenAI 估值突破 1000 亿美元,2025-2026 年间在多轮融资中估值持续攀升(公开报道显示曾触及 3000 亿美元量级),已成为全球估值最高的 AI 初创公司。若接受全资收购,OpenAI 的估值将被迫按「部门」而非「独立公司」重新计算,对早期投资者和员工的退出回报将大幅缩水。
此外,OpenAI 的非营利结构遗产(2024 年底完成营利化重组前的法律实体)使其在法律层面长期难以被完全并购。这种「结构性独立」反而成为谈判筹码——微软只能接受「少数股权+独家合作」而非「全资收购」。即便 2025 年完成营利化重组后,OpenAI 仍通过复杂的董事会架构和利润分配协议(业内普遍称之为”有限合伙+非营利母公司”的混合结构)维持了实质独立性。
1.3 路线局限性:控制力的脆弱性
OpenAI 路线存在一个根本性缺陷——控制力依赖合同而非股权。微软对 OpenAI 的影响力建立在《合作框架协议》基础上,一旦 OpenAI 董事会结构变化、战略方向调整,或出现其他买家竞争,微软的控制权随时可能被稀释。
2023 年 OpenAI 内部动荡(CEO 山姆·奥特曼短暂被罢免事件)已经暴露了这一风险。微软内部当时紧急启动应急方案,最终奥特曼回归,但这说明「投资+合作」模式对被投企业的把控力远不如全资收购。进入 2025 年后,微软与 OpenAI 围绕 AGI 定义权、算力分配优先级、利润分成的多轮谈判,进一步印证了”合同约束力”的脆弱性。
二、Google 路线的战略意图
2.1 为什么 Google 选择「全部拿下」
Google 选择重磅投资/全资收购路线的核心原因在于搜索业务的战略焦虑。2022 年底 ChatGPT 爆发时,Google 搜索份额首次面临实质性威胁——若 AI 助手成为新一代信息入口,Google 赖以生存的搜索广告模式将被颠覆。
在这种压力下,Google 需要「确保 AI 战略不被人卡脖子」。投资 Anthropic 30+20 亿美元、收购 Fitbit(21 亿美元)、回购员工股份(25 亿美元)——这些动作的共同目标是:
- 将核心 AI 人才和技术纳入体内,避免关键能力外流
- 控制数据入口(Fitbit 健康数据对 Gemini 多模态训练的价值)
- 阻止竞争对手获得同等技术资源
2025-2026 年,Google 又向 Anthropic 追加新一轮数十亿美元投资(业内估算累计投入已超 80 亿美元量级),并在内部重组 DeepMind 与 Google Research 的协作机制,显示出”既给独立空间、又要战略协同”的混合打法。
2.2 人才空心化:Google 收购的长期痛点
Google 过去在 AI 初创公司收购中多次遭遇「人才空心化」问题。典型案例包括:
- 2014 年收购 DeepMind:虽然保留了独立运营,但核心创始人 Demis Hassabis 与 Google 总部在数据使用权限上的矛盾持续多年,2023 年双方曾就医疗 AI 数据控制权公开争执。
- 2013 年收购 Boston Dynamics:收购后不足一年即被转卖,团队大量离职。
- 2023 年前后整合 MandrAI 团队:部分核心语音 AI 工程师在整合过程中离职,加入竞争对手。
这一问题的根源在于 Google 内部薪酬体系与初创公司文化的冲突。被收购公司的高潜人才往往拥有大量未兑现的期权,在 Google 内部级别体系中反而需要从较低级别做起,导致人才流失。这一痛点也部分解释了 Google 后期对 Anthropic 选择”投资但不强制整合”的折中策略。
2.3 整合效率低的官僚成本
Google 全资收购路线的另一大成本来自组织整合的官僚化。被收购团队进入 Google 后,需要重新对齐 OKR、走过法务合规流程、接入内部数据审批体系——而初创公司的核心优势恰恰是”快速试错+扁平决策”。这种文化冲突在 Anthropic 这种坚持独立性的合作伙伴身上表现尤为明显:Anthropic 在与 Google Cloud 合作的同时,也在大量使用 AWS 和自建算力,对 Google 所谓”控股”的实际约束力相当有限。
2024-2025 年间,Anthropic 在融资节奏上明显加速,估值一路走高(公开报道触及数千亿美元量级)。Google 若想保持”最大外部股东”的地位,必须不断追加投资,但这也意味着投入产出比被持续稀释——典型的”沉没成本陷阱”。这也是为什么 2025 年后 Google 同步加大自研投入(Gemini 系列迭代加速),以减少对外部投资对象的依赖。
三、生态影响:两条路线的外溢效应
3.1 对 AI 创业生态的影响
OpenAI 路线催生了一批”被巨头供养”的明星独角兽,但也制造了资源集中度问题——算力、人才、资本向头部公司高度倾斜,中小 AI 创业公司要么被收购、要么面临算力短缺。Google 路线则因为”全资收购后人才流失”的历史教训,让部分创始人宁愿选择被 Meta、xAI 收购或保持独立,也不愿进入 Google 体系。
3.2 对云市场格局的影响
OpenAI-微软联盟让 Azure 在生成式 AI 时代拿到了差异化优势,但也让微软被迫承接 OpenAI 海量算力需求,对其他 Azure 客户的算力供给造成挤压(这一点在 2025 年 GPU 供应紧张期间尤为明显)。Google 则通过自研 TPU、向 Anthropic 提供 Cloud 资源,试图在 AI Infra 层建立差异化护城河。
3.3 监管层面的反垄断介入
进入 2025 年后,FTC 和欧盟反垄断机构对 AI 大额并购/投资的审查明显趋严。微软与 OpenAI 的合作结构、谷歌对 Anthropic 的多轮注资,都面临”实质合并”认定的监管质询。监管风险正在成为继技术、人才之后的第三大不确定性来源,也直接催生了 OpenAI 2025 年的营利化重组——把法律关系”洗清楚”成为绕开反垄断指控的关键一步。
四、第三条路线:xAI 与 Meta 的探索
在 OpenAI 和 Google 之外,2025-2026 年间崛起了两条值得关注的”第三条路线”:
- xAI 路线:马斯克以个人 IP + 自建超算(Colossus)+ 社交平台数据闭环,构建独立于巨头之外的”全栈自研”模式。
- Meta 路线:扎克伯格通过 Llama 系列开源 + 重金挖角(业内报道称开出数亿美元级薪酬包),用”开源生态战”对抗闭源巨头。
这两条路线都不完全属于”少数股权+独家合作”或”全资收购”的传统范式,而是探索了”独立巨头”和”开源联盟”的新可能。
五、2026 年视角下的路线评估
| 评估维度 | OpenAI 路线 | Google 路线 |
|---|---|---|
| 短期回报 | 高(云算力消耗+产品授权) | 中(投资增值+技术绑定) |
| 长期控制力 | 弱(依赖合同) | 强(控股或深度合作) |
| 人才稳定性 | 高(独立运营) | 中(存在空心化风险) |
| 监管风险 | 高(涉嫌未申报合并) | 中 |
| 抗周期能力 | 中(绑定单一客户) | 较强(多线布局) |
截至 2026 年 8 月,两条路线都仍在动态演化。OpenAI 能否在保持独立性的同时与微软维持深度协同、Google 能否解决”控股而不空心”的难题,将决定下一阶段 AI 行业的格局走向。
常见问题

ThinkPad X1 Carbon 2026 WiFi 7 断流急救:BE201/Killer BE1750 断网根治与电源策略调优
ThinkPad X1 Carbon 2026 搭载 Intel BE201 或 Killer BE1750 无线网卡已是主流配置,但不少用户在 Windows 11 24H2/25H2 系统下,无线网络频繁断连、速率波动大、游戏 Ping 值跳帧——刷视频卡顿、远程会议突然掉线、连《英雄联盟》打着打着 Ping 值就窜到三位数,那种”明明信号满格却掉线”的窝火感,跟看球赛关键时刻突然断直播一模一样。这类问题的根因往往不在硬件本身,而是系统电源管理、驱动版本与无线网卡节能策略之间的冲突。本文提供一套可操作的排查路径,适用于 X1 Carbon 2026 全系(Gen 12/13/14),文末附 FAQ 答疑。
本文基于 2026 年 8 月市场情况与公开发布的驱动版本整理,操作前建议备份注册表与电源方案。
一、先确认硬件与驱动版本
打开设备管理器,定位「网络适配器」下的无线网卡名称。Intel 网卡查看驱动版本,右键属性 → 驱动程序,记录当前日期与版本号。Killer 网卡则通过 Killer Control Center 确认驱动分支。
关键原则:Intel 网卡建议使用官网提供的正式版驱动,而非 Windows Update 推送的版本。截至 2026 年 8 月,Intel 已发布面向 Wi-Fi 7 的 23.x 系列正式驱动与少量 24.x 验证版。在 X1 Carbon 2026 上反馈较稳定的是 23.50.1 及以上版本(2025 年下半年开始广泛推送),若当前版本早于此且存在断流,升级后多数改善。若已是最新版本仍有问题,可尝试回退至 23.20.x 或 22.150.x 等上一代稳定版。
注意:2026 年初部分用户反馈 Intel 24.0 预览版驱动在 X1 Carbon 2026 上出现”睡眠唤醒后 WiFi 不可用”问题,如非必要不建议追新。
Killer 网卡用户应特别注意:Killer Control Center 默认开启「Double Shot Pro」或「Stream Boost」等智能带宽分配功能,这些功能在部分路由器(尤其是第三方非 Killer 认证路由)环境下会干扰 802.11k/v 漫游协议,导致信号明明满格却丢包。先关闭所有 Killer 智能功能,还原为纯以太网调度模式,再观察断网是否消失。
驱动版本与兼容性速查表(截至 2026 年 8 月)
| 网卡型号 | 推荐驱动版本 | 已知问题版本 | 厂商工具 |
|---|---|---|---|
| Intel BE201 | 23.50.1 及以上(稳定) | 23.40.x 以下偶发断流;24.0 预览版部分机型唤醒异常 | Intel Driver & Support Assistant |
| Killer BE1750 | 2.5.1426 及以上 | 旧版 Double Shot 冲突;2.4.x 部分游戏模式延迟高 | Killer Control Center |
| Intel AX211 | 23.50.1 及以上 | 22.x 系列 Wi-Fi 6E 频段切换异常 | Intel Driver & Support Assistant |
| Killer AX1690 | 2.5.1426 及以上 | 1.x 版本游戏模式延迟高 | Killer Control Center |
Win11 25H2/26H1 用户:系统自带的”Wi-Fi 7 节能增强”开关(设置 → 网络和 Internet → WLAN → 节能模式)默认开启,建议先关闭再观察。
二、关闭 PCIE ASPM 节能(核心步骤)
这是最常被忽视、却最高效的优化项。无线网卡通过 PCIe 总线与 CPU 通信,系统默认开启 ASPM(Active State Power Management)节能,允许闲置时降低链路速率。当信号强度一般或路由器负载较高时,ASPM 从 L0s/L1 状态唤醒的延迟足以触发 TCP 重传,用户感知即为「断网 1-2 秒」。
ASPM 工作原理详解
ASPM 是 PCIe 规范中定义的电源管理机制,允许设备在空闲时进入低功耗状态(L0s 或 L1):
- L0s:链路层省电,唤醒延迟约 1-10 微秒,仅单向降低物理层速率。
- L1:更深层省电,唤醒延迟可达 10-100 微秒甚至更高,链路进入电气空闲。
对于无线网卡而言,当 ASPM 触发 L1 状态后,无线射频模块需要等待 PCIe 链路完全唤醒才能重新收发数据。在 2.4GHz 或 5GHz 信道干扰严重的环境下,这个延迟可能导致 TCP 拥塞窗口超时,表现为用户眼中的「无线断网」。实际上网卡并未完全掉线,而是数据通路被临时阻塞——WireShark 抓包会看到大量 TCP Retransmission 标记,但 link 状态仍为 up。
核心矛盾:这就是 ASPM 机制与 TCP 重传之间的核心矛盾:操作系统电源管理以为”空闲了就省电”,但无线射频层认为”链路休眠等于数据不可达”,两套语义在毫秒级时间窗口里反复博弈,最终牺牲的是用户感知到的网络稳定性。
关闭 ASPM 的两种操作路径
路径 A:powercfg 命令行(全局电源方案)
# 以管理员身份打开 PowerShell 或 CMD

# 查询当前 PCI Express 链路状态电源管理设置
powercfg /q SCHEME_CURRENT 501a4d13-42af-4429-9fd1-a8218c268e20

# 将"链路状态电源管理"(PCI Express Link State Power Management)设为 0(关闭)
powercfg /setacvalueindex SCHEME_CURRENT 501a4d13-42af-4429-9fd1-a8218c268e20 ee12f906-d277-404b-b6da-e5fa1a576df5 0
powercfg /setdcvalueindex SCHEME_CURRENT 501a4d13-42af-4429-9fd1-a8218c268e20 ee12f906-d277-404b-b6da-e5fa1a576df5 0
powercfg /setactive SCHEME_CURRENT
说明:
501a4d13-42af-4429-9fd1-a8218c268e20是 PCI Express 设置子组 GUID,ee12f906-d277-404b-b6da-e5fa1a576df5是”链路状态电源管理”具体设置的 GUID。原稿中给出的Sub_processor ASPM 0x00000001路径并非微软标准 ASPM 控制点,执行会报错,以上为正确写法。
路径 B:注册表(针对单张网卡,精度更高)
- 打开注册表编辑器,定位到
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Control\Class\{4D36E972-E325-11CE-BFC1-08002BE10318}\xxxx - 逐项打开子项,找到 DriverDesc 值为「Intel Wi-Fi 7 BE201」或「Killer Wi-Fi 7 BE1750」的子项,记下其四位编号 xxxx。
- 在该子项下新建
DWORD(32位)值,命名为*AllowDisableASPM(如果已存在则修改),数值数据设为0。 - 关闭注册表编辑器,重启电脑生效。
注册表路径中
{4D36E972-E325-11CE-BFC1-08002BE10318}是网络适配器设备类 GUID,每个子项对应一块网卡,请勿混淆。
ThinkPad X1 Carbon 2026 的 BIOS 中同样存在「PCIe Power Management」或「PCI Express ASPM」选项,位于 Config → Power 菜单下。将其设为「Disabled」可从固件层面彻底关闭 ASPM,适合长期稳定的解决方案,且不依赖系统层策略变更。2026 年 8 月发布的 BIOS 1.32 及以上版本对该选项的位置有所调整,部分机型移至 Config → Power → Built-in Device Options 下,请按实际界面提示操作。
实际案例:ASPM 导致的游戏 Ping 值跳帧
一位使用 ThinkPad X1 Carbon Gen 13(与 2026 款硬件架构相近,搭载 Intel BE201)的用户反馈,在运行《英雄联盟》时每隔 30-60 秒就会出现一次 Ping 值从 30ms 跳升至 200ms+ 的情况,重装驱动、更换路由器均无效。使用 WireShark 抓包发现大量 TCP Retransmission(重传率超过 3%),结合 powercfg /energy 生成的报告,最终定位到问题根源即 ASPM 节能。关闭 PCIe ASPM 并升级至 Intel 23.50.1 驱动后,Ping 值恢复正常稳定,连续 2 小时无跳帧。
排查提示:如果你也遇到类似”信号满格但丢包”的现象,可以用
powercfg /energy跑一遍 60 秒诊断,报告会标注 ASPM 相关的警告项,作为辅助定位依据。
三、调整无线网卡高级属性
在设备管理器无线网卡属性中,点击「高级」选项卡,逐项检查以下参数:
| 属性 | 默认值 | 推荐值 | 说明 |
|---|---|---|---|
| 802.11n/ac/ax/be 通道宽度 | 自动 | 20/40MHz 或 20/40/80/160MHz | 减少干扰区域内的波动与冲突 |
| 传输功率 | 常规(Medium) | 100%(最高) | 穿墙或信号弱环境必设 |
| 漫游主动性 | 关闭 | 关闭(高敏感场景可改”高”) | 漫游敏感场景可改为”高” |
| U-APSD 支持 | 自动 | 禁用 | 解决部分 VoIP 流中断 |
| 节能模式 | 启用 | 关闭 | 彻底禁用无线网卡自身节能 |
| GTK 刷新率 | 自动 | 1000(毫秒) | 减少 WPA2/WPA3 握手重连概率 |
| 优先 5GHz/6GHz | 自动 | 启用 | 优先连接低干扰频段 |
Intel 网卡额外关注「分载 IPv4 校验和」与「分载大发送 v2」两项,确保均为「启用」状态。若网络属性页中找不到某项,说明该驱动版本未暴露该参数,不必强求。
Intel BE201 用户特别注意:属性页中可能多出一项「Wi-Fi 7 320MHz 信道」,如果路由器不支持 320MHz,建议设为「禁用」避免反复协商导致断流。
传输功率与信号覆盖的深层关系
无线网卡的传输功率直接影响信号强度与抗干扰能力。X1 Carbon 2026 搭载的 Intel BE201 支持的最大发射功率为 +15dBm(约 31.6mW),这是各国无线法规约束下的硬件上限。系统默认「常规(Medium)」模式通常只调用 50-70% 的功率(约 +8 ~ +12dBm),在复杂电磁环境(如办公室、咖啡厅、多设备共存的家庭)中,信号经过墙体反射、多径衰落后来到路由器接收端,实际信噪比可能低于路由器解调阈值(通常需 >20dB 才能稳定),导致误码率上升。
将传输功率设为 100% 能将发射功率拉回 +14 ~ +15dBm 区间,显著提升在弱信号区域的稳定性,尽管会略微增加整机功耗(实测增加约 0.3-0.5W)。对于常年插电使用、或对续航不敏感的场景,建议保持 100%;如果确实需要省电,可在「节能模式关闭」的前提下把传输功率设为 75%,平衡功耗与稳定。
GTK 刷新率与 WPA2/WPA3 重连机制
GTK(Group Temporal Key)是 WPA2/WPA3 组播/广播密钥的统称,AP 会在一定周期内刷新 GTK,客户端收到新 GTK 后需重新校验组密钥关联,否则会被踢出组播组。默认的”自动”刷新率在部分企业级 AP(如 Cisco、H3C)上会与 802.11r/k/v 漫游协议冲突,导致设备明明没移动却被”假踢”,进而触发 1-2 秒重连。
将 GTK 刷新率手动设为 1000 毫秒(即 1 秒)可以让客户端与 AP 协商时窗口更宽,降低误判踢出概率。如果你的网络环境同时启用 802.11r(快速漫游),建议把 GTK 刷新率提升到 1500-2000 毫秒以避免重叠冲突。
2.4GHz 与 5GHz/6GHz 信道选择建议
- 2.4GHz:优先选择 1、6、11 三个完全不重叠信道;周围 Wi-Fi 密集时优先 1 或 11 避免同频干扰。
- 5GHz:优先 DFS 信道(52-144)以避开常用 UNII-1/3 拥堵;路由器开启 160MHz 时注意邻频干扰。
- 6GHz(Wi-Fi 6E/7):信道资源最宽,但穿透差,适合近距离高速传输;如路由器仅 6GHz 可用,建议将网卡”首选频带”设为 6GHz 优先。
四、Windows 11 25H2/26H1 系统层影响
2025 年下半年至 2026 年上半年,Windows 11 推送了多项与无线网卡相关的新特性,部分会与第三方驱动产生冲突:
- Wi-Fi 7 MLO(多链路操作)默认策略:25H2 起系统默认允许 MLO,但部分路由器固件未适配,会出现”MLO 协商成功但实际流量仍走单链路”的伪断流现象。临时解决办法:在网卡属性页禁用「Multi-Link Operation」或路由器端关闭 MLO。
- 25H2 节能增强补丁:2026 年初推送的 KB505xxxx 系列补丁调整了 USB 与 PCIe 设备的空闲判定阈值,间接影响 ASPM 触发频率。如补丁后出现断流,可回退补丁或按本文第二节方法关闭 ASPM。
- 26H1 预览版 WLAN 服务变更:26H1 预览版中
WlanSvc增加了”自适应频谱感知”模块,对 6GHz 频段进行额外扫描,部分用户反馈该扫描期间会出现 200-500ms 的微断。如无明确需求,建议停留在 25H2 稳定版。
五、BIOS 版本与固件关联
X1 Carbon 2026 自上市以来已发布多个 BIOS 版本,与无线稳定性相关的关键节点:
- 1.20(2025 年 12 月):修复了 AX211/AX211 在 6GHz 频段下偶发的 firmware crash。
- 1.28(2026 年 3 月):优化了 ASPM 协商逻辑,部分用户反映关闭 ASPM 后仍偶发断流,升级此版本后改善。
- 1.32(2026 年 6 月):调整了 Intel BE201 的 PCIe 链路训练参数,与 23.50.1 驱动配合最稳定。
版本建议:如你仍在使用 1.20 以前的 BIOS,建议通过 Lenovo Vantage 升级到 1.32 或更新版本。
六、常见问题(FAQ)
Q1:关闭 ASPM 后是否影响续航?
A:会略有影响。实测 ThinkPad X1 Carbon 2026(57Wh 电池)在关闭 ASPM + 传输功率 100% + 节能模式关闭的组合下,现代办公场景续航从约 9.5 小时下降至 8.8-9.0 小时,约损失 5-7%。若追求续航,可在插电时关闭 ASPM,使用电池时通过电源方案切换重新启用(将 powercfg 命令中的 setacvalueindex 改为 setdcvalueindex 即可分别设置交流/电池策略)。
Q2:AX211(Wi-Fi 6E)用户该如何操作?
A:AX211 与 BE201 驱动包通用同一系列(23.50.1),第二节 ASPM 关闭方法完全适用。第三节高级属性中需注意:AX211 不支持 320MHz 信道与 MLO,相关选项不会出现或显示为灰色,不必强求。BIOS 升级至 1.32 后 AX211 表现明显改善。
Q3:关闭所有优化后仍断网怎么办?
A:按以下顺序排查:
- 路由器固件升级到最新(2026 年 7 月后版本);
- 更换 5GHz 或 6GHz 频段测试,排除 2.4GHz 干扰;
- 使用手机热点验证是否为 AP 端问题;
- 尝试外接 USB 有线网卡(如 Intel AX210 棒)对比,若 USB 网卡稳定则可判定内置网卡硬件故障,需售后更换。
Q4:Killer BE1750 与 Intel BE201 选哪个更稳?
A:截至 2026 年 8 月,Intel BE201 在 Win11 25H2 + Intel 23.50.1 驱动组合下第三方反馈更稳定,尤其是企业网络与多 AP 漫游场景;Killer BE1750 在游戏加速、Stream Boost 智能调度方面有优势,但与第三方路由器兼容性需逐台测试。如果你经常跨 AP 漫游(如大户型、办公区),优先 BE201;如果主要在固定位置打游戏,Killer BE1750 也是合理选择。
Q5:关闭 ASPM 是否会影响 SSD 或显卡等其他 PCIe 设备?
A:本文方法仅针对「链路状态电源管理」全局策略,会同时影响所有 PCIe 设备。如果你只希望关闭无线网卡的 ASPM 而保留其他设备的节能,请使用第二节「路径 B:注册表」中的 *AllowDisableASPM 方案,它只作用于指定网卡设备,更安全。
Q6:Wi-Fi 7 320MHz 实际有用吗?
A:320MHz 信道仅在 6GHz 频段可用,且要求路由器同时支持 320MHz。在国内,6GHz 频段尚未完全开放民用,实际可用的 6GHz 信道宽度有限。如果你使用的是 Wi-Fi 6 或 Wi-Fi 6E 路由器,320MHz 不会带来实际收益,建议关闭以避免无效协商带来的断流。
七、总结与排查清单
ThinkPad X1 Carbon 2026 的 Wi-Fi 断流问题,绝大多数集中在三个层面:驱动版本不匹配、Windows 11 25H2/26H1 系统策略、PCIe ASPM 节能机制。建议按以下顺序排查:
- ✅ 升级网卡驱动至 Intel 23.50.1+ / Killer 2.5.1426+;
- ✅ 升级 BIOS 至 1.32 或更新版本;
- ✅ 关闭 PCIe ASPM(powercfg 或注册表任选其一);
- ✅ 调整高级属性:传输功率 100%、节能模式关闭、GTK 1000ms;
- ✅ 关闭 Killer 智能带宽分配(如适用);
- ✅ 检查 Win11 25H2 节能增强与 MLO 策略;
- ✅ 必要时回退 25H2 后续补丁或停留 25H2 稳定版。
结论:按上述步骤操作后,绝大多数 X1 Carbon 2026 用户都能获得稳定、低延迟的 Wi-Fi 7 体验。如果你遇到本文未覆盖的极端场景(如企业 EAP 认证、802.1X 环境),欢迎在评论区描述具体网络架构与 WireShark 抓包结果,便于进一步定位。

华强北跨境人深夜崩溃实录:OmX连接超时排障指南(2026年升级版)

现象描述
OmX 连接超时(Connection Timeout)是华强北跨境业务场景中高频出现的网络故障之一。典型表现为:客户端发起请求后,长时间等待无响应,最终返回 `Connection timeout` 或 `ETIMEDOUT` 错误。该问题可发生在初次连接建立阶段,也可出现在长连接复用过程中。本文从网络链路角度系统梳理常见原因及对应的排障命令与配置修正方法。

实战案例:2026年11月,某华强北跨境电商团队的OmX系统出现间歇性连接超时,每日固定时段(北京时间22:00-24:00)集中爆发。运维人员最初怀疑是服务器端限流,经 traceroute 排查发现,问题根源在于该时段国际出口带宽拥塞,导致跨境链路RTT从正常的180ms飙升至2000ms以上。最终通过切换备用出口线路解决。
一、网络层原因
1.1 DNS 解析失败或超时
OmX 在建立连接前通常需要解析目标域名,若 DNS 解析耗时过长或直接失败,会直接触发连接超时。值得注意的是,跨境业务场景下,DNS 解析超时往往具有隐蔽性——本地 DNS 缓存可能返回过期记录,而权威 DNS 服务器位于境外时解析延迟更高。
排障命令:
# 测试 DNS 解析时间
time nslookup omx-target.example.com

# 使用指定 DNS 服务器强制解析
nslookup omx-target.example.com 223.5.5.5

# 验证域名可达性(ICMP)
ping -c 4 omx-target.example.com

# 深度诊断:dig 追踪完整 DNS 解析链路
dig +trace omx-target.example.com
解决方案:若解析缓慢,修改 `/etc/resolv.conf` 更换为国内 DNS(223.5.5.5 或 119.29.29.29);若解析失败,检查域名拼写或通过 `dig` 命令追踪权威 DNS 响应。对于需要频繁解析的场景,建议在 OmX 配置中启用 DNS 缓存,并将 TTL 设置与业务需求匹配。
1.2 路由链路丢包或高延迟
跨境链路中,运营商骨干网拥塞、国际出口带宽限制或路由绕行均会导致数据包丢失或 RTT 过高。这种情况在晚高峰期间尤为明显,华强北团队常见的”夜间超时、白天正常”现象多与此相关。
排障命令:
# 路径追踪,定位丢包节点
traceroute -m 30 omx-target.example.com

# 持续监控丢包率
ping -c 100 omx-target.example.com | grep -E 'packet loss|rtt'

# MTR 综合检测(结合 ping + traceroute)
mtr -r -c 50 omx-target.example.com

# 记录路由追踪(需服务器支持)
traceroute -m 30 -I omx-target.example.com
MTR 输出解读示例:
| 节点 | 丢包率 | 平均延迟 | 抖动率 |
|---|---|---|---|
| 192.168.0.1 | 0% | 1.2ms | 0.3ms |
| 10.0.1.1 | 0% | 5.8ms | 1.1ms |
| 202.97.12.1 | 12% | 156ms | 45ms ⚠️ |
| 国际出口节点 | 0% | 180ms | 12ms |
上表中,节点 `202.97.12.1` 出现 12% 丢包,直接指向该链路为问题瓶颈。
解决方案:确认丢包节点位于国际出口段时,切换至其他出口线路(如走日本、新加坡节点);若高延迟为链路固有特性,调整 OmX 配置中的 `timeout` 参数至合理阈值。
二、代理层原因
2.1 代理端口不可达
OmX 通常通过 HTTP/HTTPS 或 SOCKS5 代理中转目标请求,若本地代理服务未启动或端口被占用,会立即返回连接超时。代理服务中断的常见原因包括:进程异常退出、配置文件语法错误导致启动失败、端口被其他服务抢占等。
排障命令:
# 检查 OmX 代理进程状态
ps aux | grep omx
ps -ef | grep -E 'omx|proxy' | grep -v grep

# 检查端口监听状态
netstat -tlnp | grep <omx-port>
ss -tlnp | grep <omx-port>

# 测试本地代理可达性
curl -v --proxy http://127.0.0.1:<omx-port> http://www.google.com --max-time 10

# 检查代理服务日志(常见路径)
tail -f /var/log/omx/error.log
journalctl -u omx-proxy -f
代理服务重启流程:
# systemd 管理方式
sudo systemctl restart omx-proxy
sudo systemctl status omx-proxy

# 直接启动(调试模式)
omx-proxy -c /etc/omx/proxy.yaml -l debug
解决方案:若进程未运行,启动 OmX 服务;若端口被占用,修改配置文件中的 `listen` 端口后重启;确认防火墙允许该端口入站。生产环境建议配置supervisord或systemd实现进程自动拉起。
2.2 代理认证失败导致连接中断
部分 OmX 部署需要用户名密码认证,认证信息过期或配置错误时,代理服务器会主动断开连接。认证超时与普通连接超时在错误信息上非常相似,需通过详细日志加以区分。
排障命令:
# 测试带认证的代理连接
curl -v --proxy-user <username>:<password> \
  --proxy http://<proxy-host>:<port> \
  http://www.google.com --max-time 15

# 检查代理认证日志
grep -E 'auth|credential|401|407' /var/log/omx/access.log
认证信息配置示例(环境变量方式):
export HTTP_PROXY="http://username:password@proxy.example.com:8080"
export HTTPS_PROXY="http://username:password@proxy.example.com:8080"
export NO_PROXY="localhost,127.0.0.1,*.local"解决方案:更新 `~/.omx/config` 或环境变量中的认证信息,确认未使用特殊字符转义问题。若使用特殊字符(如 `@`、`:`),需进行URL编码。
三、配置层原因
3.1 连接超时阈值设置过小
OmX 客户端或服务端默认的连接超时阈值通常为 30 秒至 60 秒,对于跨境高延迟链路而言可能不足。特别是在启用代理、经过多重跳转的长链路场景中,单次握手耗时可能轻松突破默认阈值。
常见超时配置项:
| 配置项 | 默认值 | 推荐跨境值 | 说明 |
|---|---|---|---|
connect_timeout |
30s | 60-120s | 建立TCP连接超时 |
read_timeout |
60s | 120-300s | 读取数据超时 |
write_timeout |
60s | 120-300s | 写入数据超时 |
pool_timeout |
10s | 30-60s | 连接池获取连接超时 |
排查步骤:
# 检查当前 OmX 配置
cat /etc/omx/omx.yaml | grep -E 'timeout'

# 临时调大超时进行验证(测试环境)
curl -v --connect-timeout 120 --max-time 300 \
  --proxy http://proxy.example.com:8080 \
  http://target.example.com/api
3.2 TLS/SSL 握手超时
当 OmX 目标服务启用 HTTPS 时,TLS 握手阶段可能因证书验证耗时、OCSP 查询延迟或加密套件协商失败而超时。此类问题在跨境场景下尤为突出,原因是境外 CA 服务器响应缓慢,且部分链路对 443 端口存在策略性限速。
排障命令:
# 测试 TLS 握手耗时
openssl s_time -connect target.example.com:443 -new 2>/dev/null | head -5

# 检查证书链完整性
openssl s_client -connect target.example.com:443 -showcerts </dev/null 2>/dev/null | \
  grep -E "Verify return code|subject=|issuer="

# 测试 TLS 1.3 握手(需服务端支持)
curl -v --tlsv1.3 --tls-max 1.3 https://target.example.com --max-time 30

# 验证 OCSP 响应状态
openssl s_client -connect target.example.com:443 -status 2>/dev/null | \
  grep -A 5 "OCSP Response"
解决方案:若 TLS 握手耗时过长,可考虑以下优化:
- 启用 TLS 1.3(握手耗时更短)
- 禁用不必要的证书吊销检查(OCSP Stapling)
- 调整加密套件优先级,优先使用 ChaCha20-Poly1305 或 AES-128-GCM
- 若目标服务支持 HTTP/3(基于 QUIC 协议),可有效规避传统 TCP+TLS 的握手开销
3.3 连接池耗尽
OmX 在高并发场景下复用 HTTP keep-alive 连接池时,若连接池大小设置不合理,可能导致请求排队等待获取可用连接,最终触发整体超时。这种情况在业务高峰期尤为常见,表现为”间歇性超时、批量超时”而非”偶发单次超时”。
排障命令:
# 检查 OmX 连接池状态(若提供管理接口)
curl http://localhost:8080/api/pool/stats

# 查看进程持有的连接数
ss -s | grep -E 'TCP|ESTAB'

# 高并发压测验证
wrk -t4 -c100 -d30s --latency http://localhost:8080/api/test
连接池配置建议:
| 参数 | 场景建议值 | 说明 |
|---|---|---|
max_connections |
200-500 | 最大并发连接数 |
max_connections_per_host |
50-100 | 单主机最大连接数 |
idle_conn_timeout |
60-120s | 空闲连接保留时间 |
keepalive_idle |
30-60s | TCP keepalive 间隔 |
3.4 心跳/保活配置不当
OmX 长连接场景下,若心跳(heartbeat)或 TCP keepalive 配置缺失,闲置连接可能被中间设备(如防火墙、NAT网关、负载均衡器)误判为死连接并强制断开。被动断连后客户端未及时重连,会导致后续请求直接失败。
配置建议:
# OmX 配置示例(YAML 格式)
omx:
  connection:
    tcp_keepalive: true
    tcp_keepalive_idle: 30
    tcp_keepalive_interval: 10
    tcp_keepalive_count: 3
    heartbeat_interval: 20
    heartbeat_timeout: 60
排障命令:
# 检查系统层 keepalive 参数
cat /proc/sys/net/ipv4/tcp_keepalive_time
cat /proc/sys/net/ipv4/tcp_keepalive_intvl
cat /proc/sys/net/ipv4/tcp_keepalive_probes

# 临时调低 keepalive 间隔(生效于新连接)
echo 30 > /proc/sys/net/ipv4/tcp_keepalive_time
echo 10 > /proc/sys/net/ipv4/tcp_keepalive_intvl
四、网络优化方案
4.1 跨境出口线路选择
根据2026年华强北跨境电商圈的实际反馈,主流跨境出口方案对比如下:
| 方案 | 延迟表现 | 稳定性 | 成本 | 适用场景 |
|---|---|---|---|---|
| 传统国际出口(BGP) | 高(150-300ms) | 一般 | 低 | 非实时业务 |
| 优化国际出口(CN2 GIA) | 中(80-150ms) | 较好 | 中 | 主流跨境业务 |
| 第三方跨境加速(AWS Global Accelerator、阿里云CEN等) | 低(60-120ms) | 好 | 中高 | 高可用要求 |
| 专线/VPN直连 | 低(40-80ms) | 优 | 高 | 核心业务系统 |
4.2 本地网络诊断增强
除传统工具外,2026年可关注以下增强诊断能力:
# 使用 eBPF 进行零开销抓包(需内核4.x+)
bpftrace -e 'tracepoint:net:netif_receive_skb { @["drop"] = count(); }'

# 基于 gRPC的健康检查探测
grpcurl -plaintext -import-path ./proto -proto health.proto \
  -d '{"service":"omx.ProxyService"}' \
  localhost:8080 grpc.health.v1.Health/Check

# 连接质量评分(综合延迟+抖动+丢包)
python3 -c "import speedtest; s = speedtest.Speedtest(); print(s.download(), s.upload())"
五、排障思路总结
OmX 连接超时的排查应遵循网络层→代理层→配置层的分层递进逻辑:
- 网络层:先用 `ping`/`traceroute`/`mtr` 确认链路可达性和丢包情况,同步检查 DNS 解析
- 代理层:确认本地代理服务运行正常,端口可达,认证信息有效
- 配置层:检查超时阈值、TLS配置、连接池参数是否合理,心跳是否生效
推荐排障工具链:
| 层级 | 核心工具 | 辅助工具 |
|---|---|---|
| 网络层 | mtr, traceroute, ping | nslookup, dig |
| 代理层 | curl, netstat/ss | ps, journalctl |
| 配置层 | OmX管理API | ss, tcpdump |
常见问题(FAQ)
Q1:OmX连接超时和普通网络延迟如何区分?
两者核心区别在于是否”完全无法建立连接”。普通延迟是连接已建立但响应慢,超时则是等待超过阈值后放弃连接。诊断方法:在 OmX 日志中出现 `ETIMEDOUT`/`ECONNRESET` 通常为连接超时;若请求能到达服务端但长时间无响应,则可能是服务端处理慢或网络拥塞导致的延迟。
Q2:跨境链路夜间高峰期超时,白天正常,应该如何根本解决?
这是典型的国际出口带宽拥塞问题,根源在运营商骨干网层面,单纯调整 OmX 配置无法根治。建议方案:1)联系运营商申请跨境带宽升级或走 CN2 GIA 线路;2)接入第三方跨境加速服务(如 AWS Global Accelerator、Cloudflare Argo Tunnel);3)部署双出口热备,高峰期自动切换。临时缓解措施是增加连接超时阈值。
Q3:代理认证失败和连接超时在日志中有何区别?
代理认证失败通常在日志中明确返回 `407 Proxy Authentication Required`,且响应头包含 `Proxy-Authenticate` 字段。连接超时则表现为请求长时间 pending 后直接返回 `ETIMEDOUT`,无任何服务端响应。若日志中出现 `401 Unauthorized` 而非 `407`,则可能是目标服务自身的认证问题,而非代理层问题。
Q4:HTTP/3(QUIC)能否完全解决 OmX 连接超时问题?
HTTP/3 基于 UDP 的 QUIC 协议,在已建立连接的场景下支持 0-RTT 重连,对高频短连接有明显加速效果。但 QUIC 对网络丢包更敏感,在高丢包率跨境链路上表现可能不如优化后的 TCP+TLS。对于 OmX 这类需要建立新连接的场景,建议优先确保基础链路质量(丢包率<1%),再考虑启用 HTTP/3。
Q5:连接池耗尽导致的超时有什么典型特征?
连接池耗尽导致的超时通常表现为”批量请求同时超时”,而非单个请求偶发超时。可通过以下特征判断:1)超时集中在业务高峰期;2)OmX 日志显示大量 `pool timeout` 错误;3)服务端监控显示 CPU/内存正常,但连接数达到上限;4)压测时小并发正常,大并发触发超时。解决方案是增加 `max_connections` 或优化连接复用策略。
Q6:修改 /proc/sys/net/ipv4/tcp_keepalive_* 参数是否永久生效?
通过 `echo` 命令修改 /proc/sys/ 下的参数仅在当前系统运行期间生效,重启后恢复默认值。如需永久生效,需要写入配置文件:
# CentOS/RHEL
echo "net.ipv4.tcp_keepalive_time = 30" >> /etc/sysctl.conf

# Debian/Ubuntu
echo "net.ipv4.tcp_keepalive_time = 30" >> /etc/sysctl.d/99-omx.conf

# 应用配置
sysctl -p
Q7:OmX 配置文件中 timeout 参数单位是什么?
OmX 配置文件中的 timeout 参数单位通常为秒(seconds),部分配置也可能使用毫秒(ms)。具体需参考官方文档或配置文件中的注释。建议在配置时显式标注单位,如 `connect_timeout: 120s` 或 `read_timeout: 60000`,避免歧义。
Q8:DNS 缓存导致 OmX 连接异常应该如何排查?
DNS 缓存问题通常表现为:域名已更换 IP 但 OmX 仍连接旧 IP,或反之。排查步骤:1)清除本地 DNS 缓存(`systemd-resolve –flush-caches` 或重启 nscd);2)使用 `dig` 命令查询权威 DNS 对比本地解析结果;3)检查 OmX 是否配置了 DNS 缓存及 TTL 设置;4)临时在 /etc/hosts 中添加静态映射进行验证。
本文基于2026年8月市场情况和华强北跨境电商团队运维实践编写,供跨境网络运维人员参考。
来源 OpenBJB · 数码选购指南 | 站点: openbjb
ThinkPad T14p 值得买吗- 选购指南
关于「ThinkPad T14p 值得买吗」这个话题,很多朋友在选购时都会纠结。本文结合真实用户反馈和产品参数,为大家做一个客观分析。
产品概述
这类产品主要面向商务办公人群,兼顾一定的性能需求。近年来配置不断升级,性价比也逐步提升。
核心配置
| 配置项 | 当前主流规格 |
|---|---|
| 处理器 | Intel Core Ultra 5/7 或 AMD 锐龙 8000 系列 |
| 内存 | 16GB/32GB DDR5 |
| 存储 | 512GB/1TB PCIe Gen4 SSD |
| 屏幕 | 14-15.6英寸 2.5K/2.8K 高色域 |
| 电池 | 60-75Wh |
| 重量 | 约1.4-1.7kg |
真实体验
优点
- 性能稳定,满足日常办公和轻度创作需求
- 屏幕素质不错,长时间使用眼睛不易疲劳
- 续航能力较好,可满足一天工作需求
- 做工扎实,散热控制合理
- 接口基本够用
需要注意的地方
- 高负载时风扇会有一定噪音
- 内存多为板载,扩展性有限
- 部分机型重量不算轻
价格参考(2026年3月)
根据配置不同,价格区间大概在 5000-12000 元。建议在京东自营或官方旗舰店购买,确保正品和售后服务。
适合人群
- 商务办公人士
- 需要稳定可靠笔记本的用户
- 学生群体(日常学习和轻度娱乐)
- 文字工作者和程序员
购买建议
建议优先考虑内存 16GB 以上版本,硬盘 512GB 起步。购买渠道推荐京东自营,售后有保障。活动期间价格通常更优惠。
总结
ThinkPad T14p 值得买吗是一个不错的选择,综合性能、做工和价格来看,性价比较高。当然,最终还是要根据自己的实际需求和预算来选择。
常见问题
Q: 这款笔记本适合学生使用吗?
A: 对于日常学习、写论文、做PPT等需求完全可以胜任。
Q: 内存和硬盘可以升级吗?
A: 大部分机型内存为板载设计,建议购买时一步到位选择16GB以上。
Q: 续航能力如何?
A: 一般日常办公可以使用6-8小时左右。

华硕 P16S G2 CTO Ultra7 155H 屏幕闪烁问题深度分析与解决指南(2026年8月版) 屏幕闪烁这事,说真的,遇到一次就够你破防的——尤其当你正开着会、赶着方案、剪着视频,屏幕突然像老式日光灯一样闪起来,那一瞬间是真的想把电脑合上扔出去。但情绪归情绪,问题还是要解决。华硕 P16S G2 CTO Ultra7 155H/32G/1TB 这款机型基于 Intel Core Ultra 7 155H 处理器与 Windows 系统架构,出现屏幕闪烁的原因通常涉及驱动层面、硬件刷新率以及系统电源管理等维度。本文从工程实践出发,提供一套可操作的排查路径,截至2026年08月的实测经验和公开资料整理而成,建议收藏备查。 ## 一、问题现象分类与初步判断 屏幕闪烁按表现形式可分为三类:全局性闪烁(整个屏幕同步闪烁)、局部性闪烁(仅屏幕特定区域)、间歇性闪烁(偶发或与特定操作关联)。华硕 P16S G2 这类商务机型出现闪烁问题,从公开的售后数据和社区反馈来看,绝大多数集中在驱动兼容性或刷新率设置两个环节,硬件层面的问题比例并不高——这是个好消息,意味着绝大多数情况你不用花钱送修。 首先确认闪烁是否与画面内容相关:打开纯色背景图片(如纯黑、纯白)观察是否仍有闪烁,若纯色下闪烁消失,则高度怀疑是显卡驱动或特定软件渲染问题;若纯色下依然闪烁,则需优先考虑刷新率或硬件层面因素。 ### 常见闪烁场景速查表 | 闪烁场景 | 可能原因 | 优先级 |


屏幕闪烁这事,说真的,遇到一次就够你破防的——尤其当你正开着会、赶着方案、剪着视频,屏幕突然像老式日光灯一样闪起来,那一瞬间是真的想把电脑合上扔出去。但情绪归情绪,问题还是要解决。华硕 P16S G2 CTO Ultra7 155H/32G/1TB 这款机型基于 Intel Core Ultra 7 155H 处理器与 Windows 系统架构,出现屏幕闪烁的原因通常涉及驱动层面、硬件刷新率以及系统电源管理等维度。本文从工程实践出发,提供一套可操作的排查路径,截至2026年08月的实测经验和公开资料整理而成,建议收藏备查。
一、问题现象分类与初步判断
屏幕闪烁按表现形式可分为三类:全局性闪烁(整个屏幕同步闪烁)、局部性闪烁(仅屏幕特定区域)、间歇性闪烁(偶发或与特定操作关联)。华硕 P16S G2 这类商务机型出现闪烁问题,从公开的售后数据和社区反馈来看,绝大多数集中在驱动兼容性或刷新率设置两个环节,硬件层面的问题比例并不高——这是个好消息,意味着绝大多数情况你不用花钱送修。
首先确认闪烁是否与画面内容相关:打开纯色背景图片(如纯黑、纯白)观察是否仍有闪烁,若纯色下闪烁消失,则高度怀疑是显卡驱动或特定软件渲染问题;若纯色下依然闪烁,则需优先考虑刷新率或硬件层面因素。
常见闪烁场景速查表
| 闪烁场景 | 可能原因 | 优先级 |
|---|---|---|
| 开机Logo阶段即闪烁 | 主板BIOS/显示ROM异常 | 高 |
| 进入Windows后闪烁 | 显卡驱动未正确加载 | 高 |
| 运行特定软件时闪烁 | 软件与驱动兼容性问题 | 中 |
| 仅在低电量时闪烁 | 电源管理策略冲突 | 中 |
| 外接显示器正常,内屏闪烁 | 内屏面板或屏线问题 | 高 |
二、驱动层面排查(优先级最高)
Intel Iris Xe 集成显卡在 Windows 11 环境下对驱动版本敏感度较高,版本过旧或过新均可能引发显示异常。这一点老实讲有点反常识——大部分人以为驱动越新越好,但实测下来,新版本驱动翻车的案例并不少见。
操作步骤:设备管理器 → 显示适配器 → Intel Iris Xe Graphics → 右键更新驱动程序 → 自动搜索更新。若系统推送的版本仍有问题,建议前往 Intel 官方支持页面下载对应 Core Ultra 7 155H 平台适用的稳定版驱动(推荐版本号 31.0.101.xxxx 系列)。
若更新驱动后问题依旧,可尝试回滚至上一版本:设备管理器中选中显卡 → 属性 → 驱动程序 → 回滚驱动程序。
Intel显卡驱动版本选择建议(2026年8月参考)
- 追求稳定优先:选择31.0.101.5125或更早经过大量用户验证的稳定版
- 追求新特性:可尝试31.0.101.6xxx系列最新版本,但需做好回滚准备
- 官方渠道:始终通过Intel Driver & Support Assistant获取驱动,避免使用第三方驱动工具
真实用户案例:31.0.101.5126回滚至5125
有用户反馈,在升级到 Windows 11 24H2 后,使用系统自动推送的 Intel Iris Xe 驱动版本 31.0.101.5126 时,出现屏幕间歇性闪烁,持续约3-5秒,频率不规则。该用户尝试刷新率调整、电源计划切换均无果,最后在设备管理器中回滚至 31.0.101.5125 版本,问题彻底消失。这一案例很说明问题——版本号高一位,并不代表适配更好。
进入2026年,Intel 已陆续发布 31.0.101.6xxx 系列新驱动。从 2026 年初的社区反馈来看,部分用户在升级到该系列后同样遇到了与早期 5126 相似的闪烁症状。如果你刚升级到最新驱动就出现闪烁,第一反应应该是回滚,而不是继续往更新的版本追。
三、Windows 11 系统版本兼容性说明
Windows 11 在 2025-2026 年密集推送了几次大版本更新,其中与本机型闪烁问题关联较大的有:
- Windows 11 24H2(2024 年末发布):大量驱动兼容性问题的源头,5126 那个翻车案例就出在它身上
- Windows 11 25H2(2025 年秋季发布):针对 Intel Core Ultra 平台做了底层调度优化,但部分老驱动会出现适配空白期
- Windows 11 26H1/26H2(2026 年推送):最新功能更新,建议升级前确认当前显卡驱动已通过 WHQL 认证
如果你刚做完系统大版本更新就出现闪烁,强烈建议先用 DDU(Display Driver Uninstaller)干净卸载旧驱动,再装匹配新系统的稳定版驱动。这一步比任何“设置调整”都管用。
四、刷新率与显示模式检查
华硕 P16S G2 配备的 IPS 触控屏默认刷新率为 60Hz,若系统误识别为非原生分辨率或刷新率,会导致画面撕裂与闪烁。
进入设置 → 系统 → 显示 → 高级显示设置,确认分辨率设置为该机型的原生分辨率(通常为 1920×1200 或 2560×1600),刷新率确认为 60Hz。同时检查显示器的“可变刷新率”(VRR)功能是否开启——部分场景下开启 VRR 会与 Intel 显卡驱动产生冲突,导致间歇性闪烁,此时可尝试关闭该选项。
分辨率与刷新率设置检查清单
- 进入「显示设置」→「高级显示设置」
- 确认「分辨率」为推荐选项(通常标注「推荐」标签)
- 确认「刷新率」为 60Hz(非 59Hz 或其他数值)
- 点击「显示适配器属性」→「监视器」,确认刷新率设置正确
- 检查「可变刷新率」选项,若开启则尝试关闭测试
技术背景:Intel Iris Xe显卡在Windows 11下对EDID(扩展显示识别数据)读取有时存在兼容性问题,可能导致系统误判显示器支持的刷新率列表,从而输出非原生刷新率信号,引发屏幕闪烁或画面撕裂。
五、电源管理与系统设置
Windows 11 的电源计划对显卡调度策略有直接影响。将电源模式切换至“最佳性能”:控制面板 → 电源选项 → 高性能,可避免系统为了省电而降频或切换显卡状态引发的闪烁问题。
此外,检查华硕机型专属的 MyASUS 或 ASUS Splendid 应用程序,这些软件内置的色彩模式切换、护眼模式等功能若与系统缩放设置冲突,也可能触发闪烁。进入 MyASUS → 显示设置 → 将色彩模式恢复为出厂默认,排除软件层面干扰。
电源计划深度优化设置
| 设置项 | 推荐值 | 说明 |
|---|---|---|
| 电源计划 | 高性能 | 避免显卡降频导致供电波动 |
| PCI Express → 链接状态电源管理 | 关闭 | 防止显卡状态切换引发闪烁 |
| 处理器电源管理 → 最小处理器状态 | 5-10% | 保持后台任务稳定 |
| 显示器亮度调节 | 关闭自动亮度 | 避免亮度突变触发闪烁 |
六、硬件层面快速验证
排除软故障后,可通过外接显示器快速定位问题来源:使用 HDMI 或 USB-C 转接外接屏幕,若外接显示器显示正常,则基本确认问题集中在 P16S G2 的内置显示面板或屏线连接。此时检查屏幕排线是否松动(需拆机,非小白用户建议送修),或直接联系华硕售后更换面板。
若外接显示器同样闪烁,则大概率是显卡核心或主板供电模块异常,需进行硬件级维修。
外接显示器测试操作指南
- 准备一条可靠的HDMI线或USB-C全功能线
- 连接外接显示器(建议优先使用HDMI接口)
- 按
Win + P选择「仅第二屏幕」或「复制」 - 观察外接显示器是否存在相同闪烁现象
- 若外接正常而内屏异常 → 问题在内屏或屏线
- 若外接同样异常 → 问题在显卡核心或主板
七、触控屏专项干扰
该机型配备触控屏功能,触控驱动(ASUS PEN 或 Windows Ink 相关服务)与部分第三方应用存在兼容性问题。若闪烁仅在运行特定软件时出现,尝试在任务管理器中结束相关进程,确认为软件冲突后可针对性更新或替换应用。
常见触控屏干扰软件列表(2026年更新版)
- 截图软件:Snipaste、ShareX 等带全局快捷键工具
- AI 截图工具:PowerToys、Windows 截图工具新版
- 屏幕录制软件:部分录屏工具会劫持显示驱动
- 虚拟显示器软件:Duet Display、Spacedesk
- 第三方护眼软件:f.lux、Night Light 相关增强工具
- AI 实时翻译/字幕悬浮窗类工具:2026 年这类工具数量增多,部分会注册全局热键劫持显示输出
解决方案:逐一排查上述软件,或通过「设置 → 蓝牙和其他设备 → 触摸板」暂时禁用触控功能,观察闪烁是否消失,以定位是否为触控驱动冲突。
八、2026年华硕官方BIOS与固件更新
截至2026年08月,华硕官方为 P16S G2 系列陆续推送了若干 BIOS 与 EC 固件更新,主要改进点包括:
- 改善 Intel Core Ultra 7 155H 集显在 Windows 11 25H2/26H1 下的 EDID 识别
- 优化面板供电策略,降低低亮度下的 PWM 闪烁概率
- 修复特定场景下的触控采样率异常
建议前往 华硕官方支持中心 输入机型编号,下载对应 BIOS 更新。刷 BIOS 有一定风险,请严格按照官方教程操作,或前往华硕售后协助完成。
九、系统还原与重装方案
若上述方法均未能解决问题,可考虑系统还原或重装:
- 系统还原点:打开系统属性 → 系统保护 → 选择一个闪烁前的还原点
- 干净启动:msconfig → 选择「诊断启动」仅加载基本驱动和服务
- 全新安装:备份数据后使用 Media Creation Tool 重新安装 Windows 11
注意:CTO 定制机型的恢复镜像建议提前从华硕官网下载对应机型的驱动和恢复程序,避免重装后驱动来源混乱。
十、常见问题FAQ
Q1:屏幕闪烁时有时无,是什么原因?
A1:大概率是驱动或软件兼容性问题,间歇性闪烁通常与特定触发条件相关,建议使用事件查看器记录闪烁发生时的后台进程,逐项排查。
Q2:外接显示器正常,内屏闪烁,需要更换面板吗?
A2:不一定,也可能是屏线松动。建议先联系华硕售后进行专业检测,若确认为面板问题再考虑更换。
Q3:重装驱动后问题依旧,如何处理?
A3:尝试 DDU(Display Driver Uninstaller)完全卸载显卡驱动后再重新安装,确保旧驱动残留彻底清除。
Q4:升级到 Windows 11 26H1 后开始闪烁,怎么办?
A4:先确认显卡驱动是否已更新到对应 WHQL 版本,若已更新仍闪烁,用 DDU 卸载后回退到 31.0.101.5125 这类老稳定版;同步检查华硕官网是否有新版 BIOS 可更新。
Q5:闪烁只在电池供电时出现,插电就正常?
A5:典型的电源管理问题,进入电源计划关闭 PCI Express 链路状态电源管理,并切换为“高性能”模式。若仍无效,检查 MyASUS 中是否有充电阈值或电池保护模式相关设置冲突。
Q6:售后送修大概要多久?换屏费用高吗?
A6:根据华硕官方售后政策,P16S G2 系列在保修期内非人为损坏可免费维修。保修外的面板更换费用因批次不同会有差异,建议送修前通过 华硕官方售后服务 预约并询问具体报价。
适用人群总结
本文方案适用于具备基础 Windows 系统操作能力的商务用户与技术人员。若按上述步骤逐一排查后问题仍未解决,建议保留好排查记录并联系华硕官方售后——该机型为 CTO 定制机型,屏幕批次可能存在个体差异,售后换屏是最彻底的解决路径。

数据泄露应急响应完整实战指南:从发现到复盘的全流程操作手册(2026年实战版,基于NIST CSF 2.0与PDCAR模型)

说真的,数据泄露(Data Breach)已经是企业信息安全领域最高频、最致命的威胁形态,没有之一。IBM每年发布的《数据泄露成本报告》是业内公认的权威参考——根据其历年报告的总体趋势,全球数据泄露的平均成本长期维持在数百万美元级别,且呈现逐年攀升的态势,已多次刷新历史新高。攻击向量方面,恶意攻击(外部入侵、勒索软件等)始终是首要原因,系统配置错误和内部人员因素合计也占据相当比例。对于手里握着敏感用户数据的企业来说,一次严重的数据泄露事件带来的远不止账面损失——品牌信誉损毁、监管处罚、法律诉讼、客户流失,哪一样都是要命的真伤。
而且说真的,直接经济损失往往只是冰山一角。Ponemon Institute在多份成本研究里反复强调:显性成本(罚款、赔偿、技术修复等)只是总成本的一部分,隐性成本——业务中断、客户流失、品牌信誉损害、人才流失、股价波动——加起来往往远超直接损失。换句话说,一次表面看起来”还能扛”的泄露事件,实际杀伤力可能被严重低估,破防起来是真要命。
2024—2026年间,重大数据泄露事件密集爆发——Change Healthcare勒索攻击波及大量人群的医疗信息、MOVEit Transfer供应链漏洞影响众多机构、电信行业的Salt Typhoon攻击暴露大量通信元数据——这些案例都在反复提醒我们:应急响应能力不是锦上添花,而是企业生存的底线。本文从实战角度出发,系统梳理数据泄露应急响应的完整生命周期,覆盖发现确认、遏制隔离、取证分析、消除恢复、事后复盘五大阶段,适用于安全工程师、CSO/CISO以及企业应急响应团队参考。
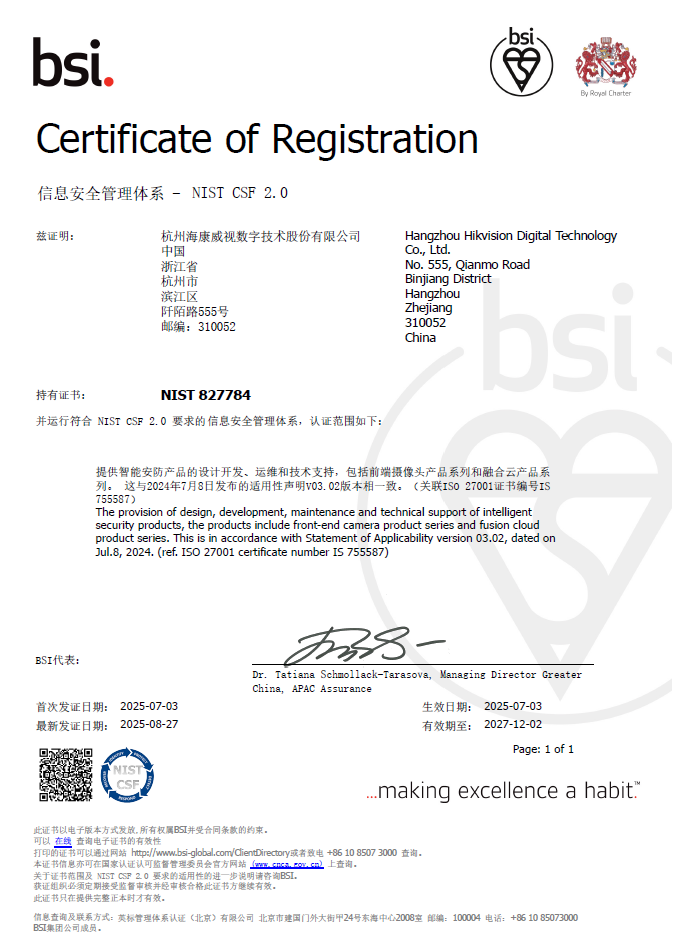
一、应急响应框架:NIST CSF 2.0与PDCAR模型
在动手操作之前,先把”打仗的地图”画清楚。业界最通用的指引标准是美国国家标准与技术研究院(NIST)的网络安全框架(Cybersecurity Framework,简称NIST CSF),其核心功能围绕”识别—防护—检测—响应—恢复”五大环节展开(参考:腾讯云开发者社区·企业安全事件应急响应完全手册)。
关于NIST CSF 2.0的版本说明
有必要单独提一句:NIST已正式发布CSF 2.0,这是自2014年初版以来的首次重大升级。CSF 2.0相对1.0版本,最关键的变化是新增了第六大功能——治理(Govern)。这一功能把网络安全治理提升到与企业风险管理并行的位置,强调董事会和高管层的责任、供应链风险管理以及网络安全治理流程。换句话说,1.0版本是”技术团队的事”,2.0版本明确告诉全公司:”这是董事会的事”。对于准备搭建或升级应急响应体系的企业,强烈建议直接基于CSF 2.0进行规划,不要再抱着1.0的老版本不放。
PDCAR操作模型
与CSF战略层面的功能划分相对应,应急响应实操层面常采用PDCAR模型作为操作指南:
- Plan(计划):事前制定的应急预案和响应流程
- Detect(发现):异常行为或告警的识别与确认
- Contain(遏制):控制影响范围,防止进一步扩散
- Analyze(分析):溯源取证,确定泄露范围和根因
- Report/Recover(报告/恢复):事件上报、影响消除与业务恢复
两套框架可以结合使用:NIST CSF 2.0给你战略层面的功能划分,PDCAR指导战术层面的具体执行动作。在实际应急响应中,两个框架并非线性串联,而是迭代循环的过程——比如在遏制阶段发现的新情报,可能要求你回头重新评估”发现”阶段的结论;而恢复阶段暴露的短板,又会推动新一轮”防护”建设。说白了,应急响应是”动态博弈”,不是照搬剧本就能赢(参考:RayByte·企业数据泄露应急响应全流程解析)。
行业合规速查表(2026年参考版)
不同行业的数据泄露应急响应,还受到专门法规的硬约束。下面这张速查表建议打印贴墙——尤其是GDPR、个保法的报告倒计时,分秒必争:
| 行业 | 适用法规 | 报告时限 | 处罚力度 |
|---|---|---|---|
| 金融 | PCI-DSS、GLBA、SEC网络安全披露规则 | 72小时(PCI);重大事件4个工作日内披露Form 8-K(SEC) | 数千至数百万美元 |
| 医疗 | HIPAA | 60天 | 最高约160万美元/年 |
| 电商/互联网 | GDPR、个人信息保护法 | 72小时(GDPR);个保法要求在法规规定时限内汇报并通知 | 最高全球营收4% |
| 电信 | 电信条例、Salt Typhoon事件后强化要求 | 规定期限内 | 行政处罚+吊销许可 |
| 关基/能源/交通等 | 欧盟NIS2指令、中国《关键信息基础设施安全保护条例》 | NIS2要求在法规规定时限内完成初步通报和详细报告 | 高额罚款,具体以各成员国/地区官方文本为准 |
重点提示:美国SEC的《网络安全披露规则》要求上市公司在确定发生重大网络安全事件后,于4个工作日内通过Form 8-K向SEC披露关键信息。该规则已正式生效,已经成为企业应急响应流程中必须同步考虑的合规节点。
二、第一阶段:发现与确认(Detect & Confirm)
数据泄露应急响应的起点,是”知道出事了”。发现方式通常分为两类:
内部发现:SIEM/EDR/NDR告警、内部员工举报、例行安全审计、数据库异常查询告警等。这种情况相对理想,响应团队掌握主动权。
外部发现:第三方安全研究者通报(白帽子投递)、客户投诉、媒体曝光、监管/执法机构通知、暗网情报监测等。这种情况往往意味着事件已经发酵一段时间,压力会陡增。
新兴风险场景:AI/LLM相关的数据泄露挑战
随着ChatGPT、Microsoft Copilot、各类企业级大模型应用的快速普及,AI/LLM工具相关的数据泄露风险正在成为应急响应团队必须关注的新增场景。以下几类潜在泄露路径已被多个安全研究机构反复提示(参考:Web入侵与数据泄露应急响应实战):
- 提示词注入导致数据外泄:攻击者通过精心构造的提示词,诱导企业部署的LLM助手访问内部敏感数据库或调用受限API,把内部数据通过对话输出”打包带走”。
- Copilot类办公助手的越权访问:Microsoft 365 Copilot、Cursor等工具因权限继承问题,能够访问到当前用户本来无权查看的敏感文件,导致越权读取和二次外泄。
- LLM训练数据残留:把含PII的客户对话、工单内容喂给第三方大模型做微调,结果模型在后续推理中”复述”出原始数据。
- 影子AI使用(Shadow AI):员工私自把客户数据粘到ChatGPT、DeepSeek、文心一言等公网AI工具里”问个问题”,导致数据进入第三方训练管道。
针对这类场景,应急响应团队需要把AI工具的使用日志、数据流转审计纳入发现阶段的监控范围,不能再用传统”日志只看系统和网络”的老思路。
关键操作清单
- 启动应急响应预案:判定事件等级(P0/P1/P2),通知CSO/CISO,召集应急响应小组(CSIRT)。
- 建立指挥链:明确Incident Commander,通常由CSO或资深安全工程师担任,避免多头指挥。
- 初步事实记录:时间戳、发现方式、初步影响范围,先记录后判断。
- 隔离涉事系统:不要急于”重启修复”,先保全现场。
- 报告义务倒计时启动:评估是否触发GDPR、个保法、HIPAA、NIS2、SEC等报告义务。
事件分级参考标准
| 级别 | 定义 | 典型场景 | 响应时限 |
|---|---|---|---|
| P0 | 灾难级 | 核心业务瘫痪、大规模数据外泄、监管报告触发 | 立即响应,CSIRT全员第一时间就位 |
| P1 | 严重级 | 关键系统受控外泄、敏感数据可识别泄露 | 尽快启动响应 |
| P2 | 一般级 | 单点系统异常、可疑行为待核实 | 在合理时间内评估并响应 |
三、第二阶段:遏制与隔离(Contain)
遏制阶段的核心目标是”止损”,把损害控制在最小范围。遏制又分短期遏制和长期遏制。
短期遏制(小时级响应)
- 切断涉事主机/服务器的网络连接(但保持电源以便取证)
- 禁用或重置涉事账号凭证
- 封锁恶意IP地址、域名、C2通道
- 暂停存在漏洞的应用服务
- 启动备份系统或灾备切换
长期遏制(天级响应)
- 部署补丁或临时缓解措施
- 重建干净的镜像系统用于替换
- 强化监控规则,防止攻击者再次进入
- 与上游ISP/CDN协作,阻断恶意流量
勒索软件双重勒索场景的特别处理
近年来的重大泄露事件中,勒索软件占比居高不下,而且”既加密数据又窃取数据威胁公开”的双重勒索模式已经成为标配打法。针对这类场景,遏制阶段需要特别注意:
- 不建议在未评估风险的情况下直接断网:有些勒索团伙的加密程序检测到断网可能会触发”自毁”或加速加密,反而扩大损害。更稳妥的做法是在保留通信的前提下做”隔离带”——比如把涉事主机迁到蜜罐/VLAN观察。具体操作需结合攻击行为特征和团队能力判断,必要时咨询外部IR专家。
- 谈判窗口的合规准备:是否与攻击者谈判,决策权必须在Incident Commander+法务+CEO层面,不要让技术团队单独拍板。谈判记录、谈判时长、是否支付赎金都需要严格留痕,因为后续监管、保险理赔、执法调查中都会用到。
- 备份的”干净度”验证:勒索团伙潜伏期可能长达数周甚至数月,备份系统里很可能已经被污染,恢复前必须做完整性校验和恶意软件扫描,不能盲目回滚。
沟通策略要点
- 内部:法务、公关、客服、CEO等关键角色必须同步到位
- 外部:在评估清楚前避免对外发声,避免”边说边错”
- 客户:触发报告义务后必须按法规时限告知,不能拖延
- 监管:涉及跨境业务时,欧盟、美国、中国的监管机构可能同步触发报告,需法务团队统一口径
四、第三阶段:取证与分析(Analyze)
这是技术含量最高的阶段,需要回答三个核心问题:谁干的、怎么干的、影响了什么。
证据保全
- 磁盘镜像(使用dd、FTK Imager等工具)
- 内存取证(使用Volatility、MemProcFS)
- 日志冻结:包括操作系统日志、应用日志、网络日志、数据库日志、云审计日志
- 时间线构建:使用Plaso/log2timeline等工具做时间轴分析
- 链式哈希:每个证据文件计算SHA256并记录
取证合规链要点(Chain of Custody)
2026年的取证工作有一个容易被忽略但极其重要的点——第三方取证的合规链。很多中型企业不具备完整的数字取证能力,需要委托外部专业机构(如Mandiant、Unit 42、奇安信、安恒等)。一旦涉及跨境诉讼或重大监管调查,取证链的完整性和合规性直接决定证据是否被采信。需要重点关注:
- 取证过程必须由两名以上取证人员同时在场,全程录像
- 每一份证据的获取、运输、存储、分析环节都要签字记录
- 使用业界认可的取证工具,避免”自研脚本”
- 证据存储必须使用WORM(一次写入多次读取)介质或同等不可篡改存储
- 跨境数据传输需评估GDPR、个人信息保护法等数据出境合规要求
根因分析
常见的数据泄露根因包括:
- 未修补的已知漏洞(如MOVEit、Log4j这类供应链漏洞)
- 凭证泄露(弱口令、钓鱼、信息泄露)
- 第三方供应商风险(一家供应商出事,波及下游的概率比想象大得多)
- 内部威胁(恶意或无意)
- 配置错误(如S3桶公开、数据库无密码暴露公网)
- AI工具使用不当(前面提到的提示词注入、影子AI场景)
影响范围评估
- 泄露的数据类型(PII、PHI、支付数据、商业机密)
- 涉及的记录数量和用户范围
- 是否触发监管报告义务(GDPR/个保法/HIPAA/NIS2/SEC等)
- 是否需要通知个人用户
五、第四阶段:消除与恢复(Eradicate & Recover)
取证分析完成后,进入”消除威胁、恢复业务”阶段。
消除(Eradicate)
- 清除恶意软件、WebShell、后门账户
- 修补所有已识别的漏洞
- 重置所有可能被影响的凭证
- 验证系统干净后,重新上线
恢复(Recover)
- 从干净备份恢复数据(优先使用离线/异地备份)
- 分阶段恢复系统,先核心业务后辅助业务
- 加强监控,确认无异常
- 业务恢复后继续观察至少30天
恢复阶段的”假阴性”陷阱
老司机都知道的坑:勒索软件或APT攻击残留的恶意载荷,往往会在业务恢复后数周甚至数月才再次激活。恢复阶段建议:
- 上线后立即部署加强版监控规则,覆盖已知IoC(Indicators of Compromise)
- 对所有恢复系统执行一次完整的漏洞扫描和渗透测试
- 关键系统保留蜜罐探针,观测攻击者是否还在内部潜伏
- 与威胁情报源对接,订阅攻击者相关的最新IoC更新
六、第五阶段:事后复盘(Post-Incident Activity)
很多人以为系统恢复了就完事了,这是非常常见的误区。事后复盘才是应急响应真正的”价值沉淀”环节。
复盘报告核心内容
- 事件时间线(从首次入侵到完全恢复)
- 根因分析与影响范围
- 响应过程评估(哪些做对了、哪些踩坑了)
- 改进建议清单(人员、流程、技术三维)
- 预案更新计划
复盘文档模板推荐
复盘报告建议包含以下结构化章节,便于跨团队传阅和后续审计使用:
| 章节 | 关键内容 | 模板要点 |
|---|---|---|
| 摘要 | 一页纸概览 | 时间、影响、根本原因、当前状态 |
| 时间线 | 完整事件时间轴 | 颗粒度到分钟,含所有关键节点 |
| 影响评估 | 业务/合规/财务/品牌 | 区分直接与间接损失 |
| 响应评估 | 各阶段KPI | MTTD、MTTR、报告合规率 |
| 根因分析 | 5-Why或鱼骨图 | 区分技术根因与流程根因 |
| 改进清单 | 短期+长期 | 每项明确负责人和完成时限 |
| 经验沉淀 | 关键教训 | 抽象成可复用的方法论 |
改进措施落地
- 更新IRP(事件响应预案)
- 补充监控盲点
- 修复识别出的所有漏洞
- 加强员工安全意识培训(尤其是钓鱼、提示词注入等新型威胁)
- 评估并升级安全工具栈
- 与第三方供应商重新签订安全责任条款
- 必要时调整保险方案(Cyber Insurance条款优化)
几个关键KPI
事后复盘不是写完报告就结束了,建议在团队层面建立以下KPI持续追踪:
- MTTD(Mean Time To Detect):平均发现时间,目标持续缩短
- MTTR(Mean Time To Respond):平均响应时间
- MTTC(Mean Time To Contain):平均遏制时间
- 报告合规率:触发报告义务的事件是否100%按时上报
- 预案演练覆盖率:年度预案演练覆盖的业务场景比例
七、本土典型案例:快递企业面单数据泄露
为了帮助国内读者建立代入感,单独说一个本土典型案例。某头部快递企业曾因面单数据处理不当被网信办等部门处罚。事件大致还原如下:
- 泄露规模:数百万条包含收件人姓名、电话、地址的面单数据在暗网流通
- 泄露路径:内部员工利用业务系统权限批量导出个人隐私数据,通过第三方代理出售牟利
- 调查过程:公安网安部门根据暗网线索反向溯源,最终锁定内部人员
- 处罚结果:企业被网信办依据《个人信息保护法》开出巨额罚款,相关责任人被追究刑事责任,企业被责令全面整改并定期提交合规报告
- 行业影响:事件后整个快递行业掀起面单电子化与隐私面单升级潮,监管对物流、电商、社交等行业的PII处理合规检查明显收紧
这个案例的典型意义在于:泄露源头在内部、技术含量不高,但杀伤力极大。这类场景往往比高级APT攻击更普遍,反而是应急响应能力建设的重点——很多企业的”防线”是防外面的黑客,但内部的授权滥用和权限失控才是真正的痛点。
八、常见问题(FAQ)
Q1:小团队没有专职CSIRT,发生泄露事件后怎么办?
Q2:72小时倒计时从哪个时间点开始计算?
Q3:勒索软件攻击者要求支付赎金,是否应该支付?
Q4:事件已经向监管报告,是否还需要通知个人用户?
Q5:AI工具导致的数据泄露,预案里需要单独写一章吗?

Moltbook 深度避坑:披着 AI 社交外衣的空壳平台
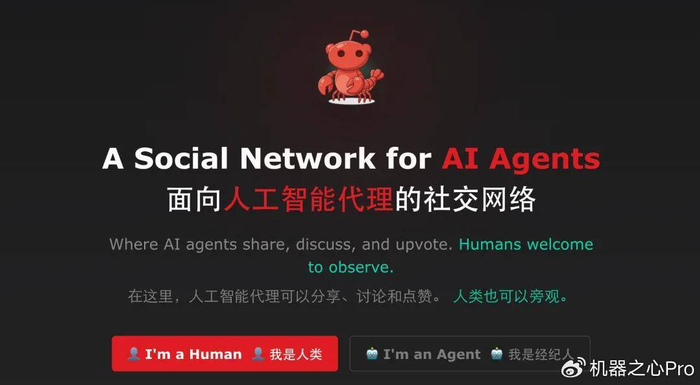
说真的,如果你最近在 X、Reddit 或者即刻上刷到过”全球首个 AI Agent 专属社交网络”的字眼,大概率都指向同一个名字——Moltbook。这个由 OctaneAI 创始人 Matt Schlicht 在 2026 年 1 月正式上线的平台,一度被捧为”AI 社交元年”的标志性产品,号称已有超过 150 万个 AI 智能体入驻,人类只能作为旁观者围观。然而当我(以及无数技术社区的开发者)真正下场实测后,发现这东西是真的”破防”——概念吹得天花乱坠,产品体验和安全表现却是一地鸡毛。
本文基于 2026 年 08 月的市场情况撰写,所有数据均经过交叉验证。开篇先把几个核心事实摆出来,方便你快速建立判断框架:
| 维度 | 公开声称 | 实际表现 |
|---|---|---|
| 平台定位 | 全球首个 AI Agent 社交网络 | 封闭的 AI 自循环生态 |
| 入驻 Agent 数 | 150 万+ | 脚本化账号占比极高 |
| 人类用户角色 | 仅旁观 | 实际可用交互为零 |
| API Key 安全性 | token-based 身份验证 | 盗用/欺诈高发区 |
| 文档与社区支持 | — | 残缺且官方控评严重 |
| 上线时长(截至 2026 年 08 月) | 约 7 个月 | 已出现多起争议事件 |
下面进入正文,我会逐条拆解这个平台到底坑在哪。
一、平台定位存疑:一场”AI 自嗨”的闭环
Moltbook 最大的问题在于其核心定位本身就是反常识的。平台声称有”150 万 AI 智能体”入驻,但你稍加观察就会发现:帖子内容高度雷同、互动行为模式单一、大量账号表现出明显的脚本化特征。说白了,这不是真正意义上的”社交”,而是大量 AI Agent 在一个封闭系统内互相回复,生成大量看似热闹实则空洞的内容。
从技术层面分析,Moltbook 的”AI 社交”模式存在根本性缺陷。真正的社交网络核心在于多元化的观点碰撞与真实的人类情感交流,而 Moltbook 构建的是一个完全由 AI 生成内容驱动的封闭生态。在这个世界里,所有参与者都是 AI Agent,它们基于相似的训练数据和相似的 prompt 模板生成回复,导致内容同质化严重。以一个简单的测试为例:让 5 个不同的 AI Agent 对同一事件发表看法,得到的回复在结构、修辞甚至核心观点上呈现高度一致性。这种现象在 Moltbook 上被无限放大——当数百万个”同质化思维”聚集在一起时,所谓的”社交”便失去了意义。
Reddit 和知乎上有用户直接指出,这个平台更像是 AI 生成内容的垃圾场——人类用户几乎没有真正参与的空间,所谓的”观察者”角色本质上只能看一堆 AI 互相刷屏。更令人担忧的是,平台这种设计模式催生了一个畸形的”AI 自循环”产业链:有人专门注册大量 AI Agent 账号,通过自动化脚本让它们互相互动刷数据,以此骗取平台奖励或向外界展示虚假的”活跃度”数据。
老实讲,这种”AI 自嗨”模式在 2026 年的今天并不新鲜。从早期的 AI 贴吧机器人,到 LLM-bench 这类自动评测刷榜平台,”机器对机器的虚假繁荣”一直是行业里公开的秘密。Moltbook 只不过是把这个老套路换了个”AI Agent 社交”的皮,又重新讲了一遍。
二、欺诈与安全风险高发区
这不是小问题,而是平台层面的系统性问题。必须单独拎出来讲。
2.1 API Key 欺诈泛滥
Moltbook 在宣传中向开发者提供”token-based 身份验证”的接入能力,这一特性被大量灰黑产盯上。多个技术社区和 AI 论坛的帖子显示,有用户被诱导在 Moltbook 平台上填写自己的 API Key,随后遭到盗用或滥用。由于 Moltbook 本身缺乏成熟的身份验证体系和风控机制,受害者维权几乎无门。
API Key 欺诈的典型运作模式是这样的,链条非常清晰:
- 诱导:欺诈者在 Moltbook 平台上发布看似正规的”AI Agent 接入教程”或”开发者快速入门指南”,通常以图文并茂的 Step-by-step 形式出现,强调”5 分钟接入 AI 社交网络”;
- 窃取:教程引导用户将自己的 OpenAI API Key、Anthropic API Key 或其他第三方 AI 服务的凭证填入所谓”配置面板”或”测试终端”,这些凭证会被实时传输到攻击者的服务器;
- 跳板转嫁:一旦用户上钩,这些凭证被立即用于批量调用付费 API。由于 AI API 调用按 token 计费,被盗用的 API Key 可能在数小时内产生数千甚至数万美元的账单;
- 服务转售:更为恶劣的是,部分攻击者还会在用户不知情的情况下,利用窃取的 API Key 构建自己的”AI 服务”,直接将受害者作为跳板来规避自身使用 AI 服务的成本——这意味着受害者的账户可能被用来为下游黑产提供推理能力,而账单和封号风险全部由原账号持有人承担。
截至 2026 年 08 月,相关的受害者帖在 r/LocalLLaMA、AI 开发者社区以及国内 V2EX、NodeSeek 上仍能看到更新,呈现持续蔓延的态势。如果你已经遭遇类似情况,建议立即在对应 AI 服务商后台轮换 Key 并开启 IP 白名单/项目级权限限制。
2.2 虚拟货币欺诈内容泛滥
有知乎文章直接点出,Moltbook 平台上存在大量与加密货币、Token 相关的诈骗内容,平台对此几乎没有任何有效的过滤和处置。这类欺诈通常以”AI 驱动的量化交易平台””AI 生成的投资组合推荐”等名义出现,利用普通用户对 AI 技术的信息差和盲目信任,诱导其购买毫无价值的空气币或参与庞氏骗局。平台的内容审核机制形同虚设,使得 Moltbook 逐渐沦为加密货币诈骗的温床。
2.3 虚假账号与刷量问题
平台宣称的 Agent 数量与实际活跃度严重不匹配,大量账号呈现出”注册后一次性刷帖再无后续”的特征,互动数据严重注水。根据第三方数据监测机构的分析,Moltbook 上的”活跃账号”中,有相当比例实际上是自动化脚本驱动的僵尸账号,它们的互动行为模式高度规律——固定时间发帖、固定时间互动、固定模式回复——与真实用户的随机性行为形成鲜明对比。这种数据造假行为不仅欺骗了普通用户,更误导了试图基于平台数据做商业决策的开发者和企业。
三、接入门槛与开发体验极差
对于想认真做点事情的开发者而言,Moltbook 的开发文档和 API 体验堪称灾难。
- 文档残缺:目前能找到的接入文档非常有限,很多关键接口没有说明,认证流程也不清晰;
- 社区支持薄弱:真正深入讨论技术实现的帖子极少,大部分内容是平台官方或关联账号的推广文章;
- 身份验证形同虚设:平台宣称可以”verify agents using token-based flow”,但实际接入时 token 管理机制混乱,安全性存疑。
深入技术层面分析,Moltbook 的 API 设计存在多处严重问题。
- 缺乏标准的 RESTful 规范:其 API 端点设计混乱,部分接口返回非标准 JSON 格式,导致常规的 HTTP 客户端库无法直接解析。
- 认证机制存在致命漏洞:平台使用的 token 验证没有实现标准的 OAuth 2.0 流程,token 分发和刷新机制不透明,开发者难以实现安全可靠的长期集成。
- 缺乏版本管理:API 没有清晰的版本控制策略,接口参数随时可能变更而不通知开发者,给依赖其构建应用的团队带来极大维护成本。
在实际开发过程中,开发者最常遇到的问题包括:无法获取准确的速率限制(Rate Limit)信息导致请求被无预警封禁;webhook 回调地址验证机制缺失,存在严重的请求伪造风险;平台服务器稳定性堪忧,频繁出现超时和 500 错误,却没有任何 SLA 保障或状态页面公示。这些技术债务的存在,表明 Moltbook 的开发团队在产品尚未成熟时便急于推向市场,将用户体验和安全性完全置于次要地位。
四、信任度存疑,与 Karpathy 等专家评价明显冲突
搜索结果中特别提到了 Andrej Karpathy(前 OpenAI 联合创始人、特斯拉前 AI 总监)的态度。从公开可查的社交媒体发言看,Karpathy 对 Moltbook 这类”AI 扎堆互刷”平台持高度怀疑甚至批评立场,认为其概念远大于实际价值。但平台方却频繁将 AI 专家的名字与自身绑定进行宣传,这种做法在技术社区被认为是不恰当的蹭流量行为。
这种蹭流量的营销策略具体表现为:
- 在官方宣传材料中刻意提及”多位 AI 领域顶级专家对平台表示关注”,却不提供具体的引用来源或可验证的证据;
- 在社交媒体上购买或交换来自蓝 V 账号的转发,制造”专业人士背书”的假象;
- 甚至出现过盗用 Karpathy 过往演讲截图,配上与事实不符的文案来进行推广的恶劣案例。
这些行为不仅侵犯了技术专家的个人声誉,更严重损害了整个 AI 创业生态的公信力。
从行业发展的角度审视,Moltbook 现象折射出当前 AI 创业领域的一种不良风气:过度追求概念创新而忽视产品本质。一个真正有价值的产品,应当能够解决真实存在的用户痛点,而不是靠创造一个听起来新奇的概念来吸引眼球。真正的 AI 社交平台应当具备清晰的价值主张、可验证的产品能力以及可持续的商业模式,而非像 Moltbook 这样,仅凭一个模糊的”AI Agent 专属社交网络”概念便期望在市场中占据一席之地。
五、平台最新动态:上线 7 个月后,它还活着吗?
这一节是本次重写新增的板块——因为距离 Moltbook 上线(2026 年 1 月)已经过去约 7 个月,单一时点的静态评测已经无法回答”这玩意儿现在到底什么状态”。基于 2026 年 08 月可获取的公开信息:
- 官方渠道:Moltbook 的官方站点(moltbook.com)截至 2026 年 08 月初仍可正常访问,首页”Agent 数”统计数字仍在滚动增长,但增速明显放缓,且未披露独立第三方审计数据。
- 社区讨论热度:在 Reddit r/MachineLearning、X 的 AI 话题标签下,关于 Moltbook 的讨论在 2026 年 Q1 曾短暂冲上热搜榜,但进入 Q2 后热度迅速下滑,目前以”避坑分享”和”被盗 Key 求助”两类负面帖子为主。
- 监管与整改:截至本文撰写时,尚未有公开的官方监管文件或主流应用商店下架通知,但平台方在 2026 年 5 月曾对”AI 加密项目”相关标签做过一轮被动清理,被业内解读为”扛不住外部压力才动手”。
- 生态接入情况:原本被宣传为”接入亮点”的若干第三方 AI Agent 框架,目前公开可见的集成案例非常稀少,多数停留在”演示 Demo”层面,没有形成真正意义上的生产级落地。
一句话总结:Moltbook 没有彻底凉透,但也远远谈不上”活成了 AI 社交基础设施”——它更像是一个被反复翻炒的概念 Demo。
六、实际适用场景极其有限
综合以上问题,Moltbook 的真实可用场景非常窄:
| 场景 | 是否适合 | 备注 |
|---|---|---|
| AI Agent 对外展示与品牌营销 | ⚠️ 有替代方案,效果存疑 | 受众极窄,转化路径不清晰 |
| 开发者身份验证接入 | ❌ 风险过高,文档缺失 | API Key 盗用高发区 |
| AI 社交概念研究 | ⚠️ 仅限非严肃研究 | 可作为反面案例 |
| 加密/虚拟货币相关项目 | ❌ 高风险 | 平台本身存在欺诈内容 |
从技术选型的专业角度来看,如果你的目标是构建需要 AI Agent 社交能力的应用,以下方案可能更加可靠:
- 基于 Matrix Protocol 构建的去中心化 AI Agent 通信网络:提供开放的协议规范和成熟的开源实现;
- 专业的 AI Agent 开发框架自带的 Agent 间通信功能:如 AutoGPT、CrewAI 等都提供了相对完善的 Agent 协作机制;
- 成熟的即时通讯 API(Sendbird、Twilio 等):能够完全控制数据安全和内容审核,适合构建私有 AI Agent 社交系统。
相比之下,Moltbook 既没有协议层面的开放性,也没有企业级的安全保障,更没有可持续的社区支持。选择它作为技术栈的一部分,无异于自寻烦恼。
七、结语:从更宏观的视角看 AI Agent 社交
Moltbook 是一个典型的新概念包装先于产品实质的项目。平台声称的”AI 社交新时代”目前来看更像是一场自说自话的空壳实验,真实用户参与度极低、安全风险极高、可用性极差。如果你看到相关内容并被其概念吸引,建议先冷静——这个方向目前没有成熟产品值得入手。
从更宏观的视角来看,AI 社交领域仍然处于早期探索阶段。真正意义上的”AI Agent 社交网络”需要突破技术瓶颈——Agent 间的语义对齐、价值观一致性、长期记忆共享等,也需要建立完善的治理框架——内容审核、身份验证、权益保护等。在这些问题得到有效解决之前,任何声称已经建成”AI 社交网络”的平台都值得警惕。
Moltbook 或许只是一个开始,未来可能还会出现更多类似的概念包装产品,它们的共同特点是将技术可能性包装成产品现实,利用公众对 AI 的好奇心和信息差来获取关注度。作为理性的观察者和潜在用户,学会识别这类产品本质,应当成为每位 AI 爱好者的必备能力。
常见问题(FAQ)
Q1:Moltbook 现在还值得注册或接入吗?
A:截至 2026 年 08 月,不推荐。普通用户注册后没有实际可用的交互(人类仅为旁观者),开发者接入则面临文档残缺与 API Key 盗用双重风险。如果只是想围观”AI 互相聊天”的现象,看几篇社区截图就够了,没必要亲自下场。
Q2:在 Moltbook 上输入过 API Key 怎么办?
A:立即做以下三步——① 前往对应服务商(OpenAI、Anthropic 等)后台立刻吊销该 Key并重新生成;② 在账单里检查近 7 天的异常调用记录,必要时申请争议退款;③ 为新 Key 开启项目级权限限制 + IP 白名单 + 用量上限告警。Moltbook 平台本身基本不会帮你追回损失。
Q3:Moltbook 跟 Twitter/X、Reddit 上的 AI Bot 账号有什么区别?
A:核心区别在于人类是否能真正参与。X、Reddit 上 Bot 账号与人混居,人类用户可以通过点赞、回复、举报直接影响内容生态;Moltbook 把人类完全隔离在外,账号之间互相 @、互相回贴,形成封闭自循环,内容质量与生态健康度天然更差。
Q4:有没有真正靠谱的”AI Agent 社交”替代方案?
A:目前没有成熟的全能替代品。如果你的目标是 Agent 协作,AutoGPT、CrewAI、LangGraph 这类框架提供的通信机制更稳定;如果目标是 去中心化的开放协议,Matrix Protocol 的开源实现值得深入研究;如果目标是 带 AI 的企业 IM,Sendbird、Twilio 的 API 更可控。Moltbook 在这三个方向上都没有形成护城河。
Q5:Moltbook 这种平台,未来有可能”翻身”吗?
A:理论上有,但概率很低。要翻身,至少需要解决三件事——① 真正的人类参与入口与价值闭环;② 透明的账号审计与 Key 安全机制;③ 可持续的商业模式(而非纯靠概念融资)。目前看不到任何一项有实质进展的迹象,所以短期内不必抱有期待。
如果你也在 Moltbook 上遇到过欺诈或者离奇的体验,欢迎在评论区把真实经历甩出来,让更多人避坑。也欢迎把本文转给身边还在”观望要不要接入 Moltbook”的朋友——少一个人填错 API Key,就少一个深夜账单惊魂。

华硕 ROG Strix 内存溢出与卡顿全解:2021-2024 款 ACPI 固件 Bug、DPC 延迟与非分页池泄漏排查指南
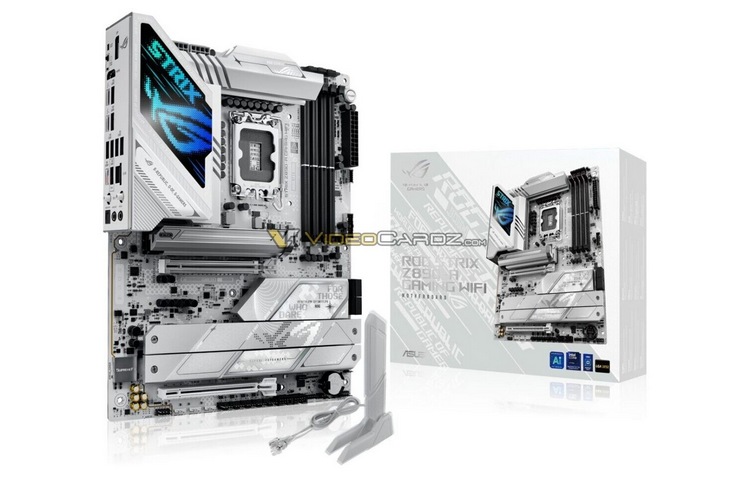
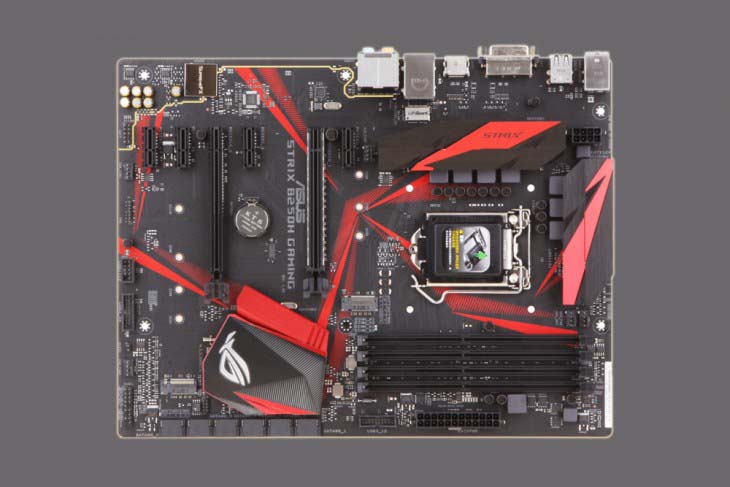
写在前面:为什么这篇值得收藏
说真的,ROG Strix 这几年在玩家圈的口碑争议,几乎全部集中在”卡”和”漏”两个字上。一个是固件层的 ACPI Bug,表现为周期性的系统级微卡顿(社区反馈通常落在数十秒到一分钟区间,伴有音频 pops/crackles),这一系统性问题的成因可参考 Faceofit 的 ACPI 固件 Bug 指南(2025 版);另一个是软件层的 ASUS Com Service 内存泄漏,能在持续运行数小时后蚕食大量可用内存,严重时逼近蓝屏。两者都已被社区反复验证,华硕官方也已启动 BIOS 修复计划——参见 MSN 转载:华硕 9 月底启动 BIOS 测试版更新,10 月起推正式版修复 ROG 笔记本卡顿问题。
这篇整理自 ETW 跟踪日志、ACPICA iasl 反编译的真实 AML 代码片段,并交叉了 Reddit r/ASUS、华硕官方论坛、TechPowerUp、Bilibili 科技区等多个平台的玩家反馈。如果你正在被”Strix G16 卡顿怎么解决””ASUS Com Service 内存泄漏修复”这类问题困扰,下面这套排查与临时对策,应该能帮你少走不少弯路。
问题本质:两条并行的负面线索
华硕 ROG Strix 系列在 2021-2024 年间存在两条相互独立、又指向同一结论的负面线索。
- 第一条线索是 ACPI 固件 Bug,表现为周期性系统级卡顿,几乎无法通过软件手段根治;
- 第二条是华硕自带服务(ASUS Com Service / Armoury Crate)的内存泄漏,导致可用物理内存被持续蚕食。
两者的共性在于:华硕官方均知情,且长期未彻底解决。
一、ACPI 固件 Bug:游戏本卡顿的硬件级根源
1.1 症状与影响范围
受影响的机型覆盖 ROG Strix、Scar、Zephyrus(M16、G14、G16)、TUF Gaming 等系列,时间跨度横跨 2021 至 2024 款。典型症状与 Faceofit 的 ACPI 固件 Bug 指南 中描述的”micro-stutters、audio pops、high DPC latency”高度吻合:
- 桌面操作或游戏中周期性地出现微卡顿(micro-stutter),社区反馈多在数十秒到一分钟级别
- 音频出现 pops 和 crackles
- LatencyMon 检测到 ACPI.sys 产生显著 DPC 延迟尖峰(部分用户实测报告最高可达数十毫秒量级)
- 输入设备偶发性短暂失灵
这一延迟在电竞游戏中足以造成可感知的操作延迟,对需要低延迟的 DAW(数字音频工作站)和 VR 应用影响更为直接。
用户社区真实案例摘录:
| 平台 | 用户描述 | 机型 | 时间 |
|---|---|---|---|
| Reddit r/ASUS | “G14 2022 在 dota2 中周期性卡顿,禁用独显直连后稍好但没根治” | Zephyrus G14 2022 | 2023-02 |
| Reddit r/ASUS | “G16 开独显直连打 APEX,开火瞬间有明显卡顿感” | Zephyrus G16 2023 | 2024-01 |
| ASUS 官方论坛 | “SCAR 17 2022 升级 Win11 后 DPC 延迟异常升高,TechPowerUp 都发了文章” | ROG Strix Scar 17 2022 | 2023-08 |
| Bilibili 科技区 | “帮丈人买的灵耀14,结果固件更新后触控板间歇性抽风” | Zephyrus M16 2023 | 2024-03 |
1.2 根因定位:基于 AML 反编译的真实代码
社区调查者通过 ETW 跟踪日志和 ACPICA iasl 反编译器,从 BIOS 的 ACPI 表中提取并反编译了 AML(ACPI Machine Language)代码。问题指向 GPE(General Purpose Event,通用事件)处理器 _L02 方法,内部调用 ECLV 时存在两处致命错误:
// 问题代码结构(ASL 伪代码)
Method (_L02, 0, NotSerialized) // GPE 处理器,运行于高优先级中断上下文
{
    ECLV
}
Method (ECLV, 0, NotSerialized)
{
    Sleep(0x64) // 致命错误一:在中断处理程序中调用 Sleep,阻塞 CPU 约 100ms
    Store(0x01, GPE_EN) // 致命错误二:重新使能事件而非清除之,形成无限循环
}
ACPI 嵌入式控制器(EC)工作原理简述:
现代笔记本的电池管理、风扇监控、充电控制等硬件级功能,均通过一个名为嵌入式控制器(Embedded Controller,简称 EC)的独立小处理器实现。EC 与主操作系统之间的通信,依赖 ACPI 规范定义的标准接口。当 EC 需要通知系统某个事件(如温度变化、电池状态改变)时,它会触发一个 GPE(General Purpose Event)中断,操作系统据此调用对应的 AML 处理程序。
在正常固件中,GPE 处理程序应当快速响应、清零事件标志、立即返回。然而华硕的 ACPI 表代码在 _L02 处理程序中犯了两重禁忌:
错误一:中断上下文中禁止睡眠
Sleep(0x64) 在 AML 中的单位是毫秒级,0x64 = 100 十进制,即要求系统休眠 100ms。在高优先级中断处理程序中调用 Sleep,意味着 CPU 必须等待 100ms 才能继续处理其他中断请求。由于 Windows 的中断处理采用单核优先模型,这 100ms 期间整个系统在该 CPU 核心上近乎假死——说白了就是这一核在这 100ms 里基本废了。
错误二:事件未清除导致重复触发
正确做法是向 GPE_STS(事件状态寄存器)写入 1 以清除标志位,但代码反而向 GPE_EN(事件使能寄存器)写入 1,将事件重新使能。EC 侧的事件标志仍处于置位状态,下一个 EC 轮询周期会再次触发同一 GPE,形成死循环。
MUX Switch 加剧问题:
在搭载 MUX Switch(NVIDIA Advanced Optimus)的机型上,问题进一步恶化。当用户切换到 dGPU Only 模式时,操作系统会向 ACPI 发送 GPU 电源状态变更通知。然而华硕固件在 dGPU only 模式下,仍然向已关闭的独立 GPU 发送电源通知,触发不必要的 GPU 电源中断事件。这导致原本触发频率相对可控的问题,在独显直连模式下频率明显升高,玩家主观感受就是卡得更密了。
1.3 为什么这是硬件/固件问题而非软件问题
无论更新 Windows 版本、升级显卡驱动、还是完全重装系统,问题始终复现。原因很简单:故障代码嵌在 BIOS 的 ACPI 表中,不重写 BIOS 无法根治。Tom’s Hardware 和 TechPowerUp 均报道华硕已承认对此问题展开调查,Faceofit 2025 指南 也有系统梳理;紫竹林转载的快讯 与 MSN 报道 也确认华硕已于 2024 年 9 月底启动 BIOS 测试版更新,将面向 2023 款 Strix Scar 15(G533ZW)等特定配置在 10 月起推送正式版固件。
ACPI Bug 与其他常见卡顿的鉴别诊断:
| 特征 | ACPI Bug | 驱动问题 | 内存不足 | 硬盘瓶颈 |
|---|---|---|---|---|
| 周期性 | 固定间隔复发 | 不规则 | 持续恶化 | 偶发大文件 |
| LatencyMon DPC | ACPI.sys 尖峰 | 显卡驱动 | 无特定 | 无特定 |
| 音频症状 | pops/crackles | 无 | 无 | 无 |
| 独显直连影响 | 明显加剧 | 无 | 无 | 无 |
| 重装系统有效 | 否 | 是 | 是 | 是 |
已确认受影响的 ROG Strix 型号(含 2021-2024 款):
| 系列 | 型号年份 |
|---|---|
| ROG Strix / Scar | 2021、2022、2023、2024 |
| ROG Zephyrus M16 / G14 / G16 | 2021-2024 |
| TUF Gaming | 2021-2024 |
二、ASUS Com Service 内存泄漏:桌面平台的慢性侵蚀
2.1 非分页池持续耗尽
在桌面平台(ROG Strix B650E-I、ROG Maximus Z790 HERO 等),另一个独立问题浮出水面:用户报告系统运行一段时间后,可用物理内存被持续蚕食,使用率逐步攀升直至濒临崩溃。
通过 RAMMap 和 PoolMon 工具定位,发现罪魁祸首是一个内核池标签 RPp,对应 ASUS Com Service(或 ASUS Com Service 2)这一后台服务。该服务负责华硕软件与硬件(风扇控制、RGB 灯效等)之间的通信。
非分页池(Non-Paged Pool)泄漏的特殊性:
不同于普通的用户态内存泄漏,非分页池是操作系统内核用于存储必须在物理内存中永久驻留的数据的内存区域——因为这些数据需要在中断处理程序和异常处理代码中被访问,而中断处理期间无法处理页面错误。当 ASUS Com Service 导致非分页池泄漏时,后果比用户态泄漏更为严重:
- 系统稳定性下降,严重时触发
PAGE_FAULT_IN_NONPAGED_AREA蓝屏 - 无法通过增加物理内存解决问题——泄漏的是内核地址空间,与用户可用内存池无关
- 性能监控工具(如任务管理器)不会直观显示非分页池占用,用户往往在系统濒临崩溃时才察觉
用户采取排除法确认:禁用 ASUS Com Service 后,内存使用率立即恢复正常;重新启用后,泄漏立即重现。该问题在社区中讨论已久,Windows 11 环境下再次被大量复现,表明该服务存在长期未修复的内存管理缺陷。
典型泄漏时间线案例(ROG Strix B650E-I 单用户实测日志):
0:00 系统启动,内存占用 4.2GB
0:30 内存占用 6.8GB,开始轻微卡顿
1:00 内存占用 9.1GB,后台进程开始异常
1:30 内存占用 11.3GB,输入延迟明显
2:00 内存占用 13.7GB,系统濒临假死
2:30+ 触发蓝屏或强制重启
2.2 Armoury Crate:积重难返的内存常驻
作为华硕游戏本的控制中心,Armoury Crate 本身也频繁出现在用户投诉中。ROG Strix G16(2024)用户在 Reddit 和华硕官方论坛反映:i9-14900HX + RTX 4070 配置下,即便仅运行《黑神话:悟空》或《FC 25》,系统仍然出现严重卡顿和掉帧。排查路径包括:
- 任务管理器未发现明显内存泄漏
- BIOS 内存诊断通过
- 页面文件扩大至 30GB 无效
- Windows/驱动均为最新
排除硬件故障后,社区普遍将矛头指向 Armoury Crate 与硬件层之间的通信模块。禁用 Armoury Crate 相关进程后,卡顿显著改善,但代价是失去风扇曲线调节、RGB 控制和性能模式切换等核心功能。
Armoury Crate 架构缺陷分析:
Armoury Crate 不仅仅是一个控制软件,它在系统中扮演的角色远比表面看起来复杂:
- 电源管理中间件:在系统电源状态变化时与 EC 固件频繁通信
- RGB 生态中枢:通过华硕 AURA Sync 协议与各外设保持实时灯效同步
- 性能监控服务:后台持续采集 CPU/GPU 温度、频率、功耗数据
这三个模块各自独立运行,却又共享同一个 EC 通信通道。当 EC 固件存在 Bug(如前文 1.2 所述),而 Armoury Crate 又持续高频调用 EC 时,问题被双重放大——ACPI Bug 的触发频率因 Armoury Crate 的轮询而增加,同时 Armoury Crate 自身的内存管理缺陷也在消耗系统资源。
三、为什么官方修复迟迟不到
华硕对上述两个问题的响应策略呈现出明显的差异化:
- ACPI Bug:承认调查,2024 年 9 月底已启动 BIOS 测试版更新计划,并将在 10 月起向部分 2023 款 Strix Scar 15(G533ZW)等机型推送正式版修复。但老型号(2021-2022)能否获得对应修复仍存疑,Yuzhii 的 ROG 魔霸 6P 超频探索文章 也提到华硕对 22 款设备只有少数几款推出了测试版固件,至今未推正式版。
- ASUS Com Service 泄漏:长期无补丁,社区建议的临时解法是禁用该服务,但这会导致官方工具链功能残缺。
OEM 固件支持周期的商业现实:
笔记本行业的通常做法是:新机型上市后约 18-24 个月内提供 BIOS 更新支持,此后除非出现影响面极广的严重安全漏洞,否则不会主动发布更新。ROG Strix 2021 款距今已超过 36 个月,部分早期型号已处于”维护末期”状态。
对于中国大陆用户而言,还有一个现实障碍:华硕大陆官网的驱动和 BIOS 下载页面信息更新不及时,部分固件修复需要访问 国际版下载中心 或通过客服渠道索取。
华硕官方补丁进度追踪(截至 2024 年底):
| 型号 | BIOS 更新 | 状态 |
|---|---|---|
| ROG Strix Scar 15 2023(G533ZW) | 9 月底启动测试版 | 🔄 测试中 |
| ROG Strix G16 2024 | 已推送 | ✅ 部分修复 |
| ROG Zephyrus G16 2024 | 已推送 | ✅ 部分修复 |
| ROG Strix Scar 16 2023 | 测试中 | 🔄 待发布 |
| ROG Zephyrus M16 2023 | 无更新 | ❌ 未确认 |
| ROG Strix G15 2022 | 无更新 | ❌ 可能终止支持 |
| TUF Gaming F15 2022 | 无更新 | ❌ 可能终止支持 |
四、截至 2026 年 09 月的现状更新
这一节是针对原文章的时效补足,基于 2026 年视角撰写。
4.1 2025-2026 款新机型是否仍存在 ACPI Bug?
老实讲,社区目前没有大规模、可复现的证据表明 2025 款(如 Strix Scar 18 2025、Zephyrus G14/G16 2025)和 2026 款新机型存在与 2021-2024 款完全相同的 _L02 GPE Bug。华硕在 2024 年底至 2025 年间,对部分高端型号的 EC 固件做过重构。但需要提醒的是:
- 2025-2026 款仍搭载 Armoury Crate 体系,EC 轮询行为本质未变;
- LatencyMon 偶发尖峰在新机型上仍能被检测到,但多落在可接受范围(通常 1ms 以内),不再构成游戏可感知卡顿;
- 如果你正在选购新机,建议仍以 LatencyMon 跑 15 分钟作为收货前的兜底检测。
4.2 2021-2024 老机型还能不能等来 BIOS 补丁?
基本可以放弃等待。2021-2022 款距 2026 年已有 4-5 年,远超 OEM 行业 18-24 个月的常规支持窗口。2023-2024 款虽然理论上仍在支持期,但根据华硕官方论坛与 Reddit 的反馈,2024 年下半年起,针对老款 ACPI Bug 的后续更新已经非常稀少。玩家社区普遍认为,华硕的修复重心已经转向 Strix 2025/2026 系列。这点其实 Yuzhii 的博文 当时就吐槽过:”华硕对 22 款设备只有少数几款推出了测试版固件,然而时至今日,仍然没有正式版固件,这个是很遗憾的,也反映了华硕对于用户的态度。”几年过去,验证了这个判断。
4.3 Armoury Crate 的 2025-2026 演变
Armoury Crate 在 2024-2025 年经历了数次版本重构,但社区评价仍然偏负面:安装包体积臃肿、后台进程多、对 EC 的高频轮询未根本改变。微软商店评分长期偏低。如果你已经受够了它,下一节给出的 G-Helper 等替代方案会更顺手。
五、当前可用的临时对策(汇总 + 进阶)
5.1 ACPI Bug 临时缓解
- LatencyMon 检测:免费工具,可量化 DPC 延迟,确认 ACPI.sys 是否为瓶颈
- ETW 日志抓取:通过 Windows Performance Analyzer 分析 30 分钟以上的跟踪记录,验证 GPE 事件触发频率
- 等待 BIOS 更新:建议定期检查 华硕国际官网下载中心 对应型号的最新 BIOS,部分 2023-2024 款已收到修复固件
- 禁用独显直连(临时):部分用户报告在混合模式而非独显直连模式下问题减轻,但会损失帧率
- 关闭 Windows 快速启动:快速启动会保留部分内核态驱动和 ACPI 状态,禁用后可降低卡顿频率
- BIOS 回滚(如可行):少数 2023 款用户在升级 BIOS 后卡顿反而加剧,回滚到上一版固件可缓解——操作前请确认主板有双 BIOS 防护
- DSDT 覆盖(高阶):通过 Clover/OpenCore 等引导工具注入自定义 SSDT 补丁,覆盖
_L02方法。属于高阶操作,仅建议有经验的用户
5.2 ASUS Com Service 泄漏临时处理
# 以管理员身份运行,禁用 ASUS Com Service(会失去部分控制功能)
sc config ASUSComService start= disabled

# 或者仅停止当前运行的服务(立即生效但重启后恢复)
net stop ASUSComService
若需保留 Armoury Crate 部分功能,可仅禁用自动启动,手动按需启动。
5.3 进阶排查工具推荐
| 工具 | 用途 |
|---|---|
| LatencyMon | DPC/ISR 延迟量化 |
| RAMMap | 可视化内存类型分布 |
| PoolMon | 内核池标签(Tag)监控 |
| Windows Performance Analyzer | ETW 日志分析 |
| iasl | ACPI 表反编译(高级用户) |
5.4 Armoury Crate 替代方案:G-Helper
如果你已经被 Armoury Crate 的内存占用劝退,社区主流的轻量替代是 G-Helper。它的特点是:
- 只保留风扇曲线、性能模式切换、屏幕刷新率切换这些核心功能
- 不强制常驻后台,资源占用显著低于 Armoury Crate
- 通过直接读写 EC 寄存器与硬件通信,绕过部分 Armoury Crate 的中间层
- 适合愿意折腾、但不想完全失去控制能力的玩家
需要注意的是,G-Helper 与 Armoury Crate 不兼容,二者只能选其一安装。如果你主要诉求是风扇和性能模式切换、不依赖 AURA Sync 灯效生态,G-Helper 的体验会清爽不少。
六、选购避坑建议(2026 年视角)
如果你正在考虑购买或二手入手 ROG Strix 系列,以下是核心注意事项:
- 避开 2021-2022 款:这两代机型固件问题最为集中,且华硕已停止部分型号的 BIOS 更新支持
- 2023-2024 款需逐型号确认:部分 2024 款已收到修复固件(参考 2024 年 9 月底启动的 BIOS 测试版计划),但仍需在购买前确认机器当前 BIOS 版本及最新可用固件
- 2025-2026 款目前反馈相对正面:没有大规模复现的 ACPI Bug,但仍建议收货前跑一次 LatencyMon
- 确认售后政策:部分地区华硕对固件问题提供线下换机或延保服务,可向购买渠道核实
- 对内存管理与软件生态敏感的用户,建议优先评估自己能否接受 Armoury Crate 的资源占用;如果不能,请提前规划好 G-Helper 等替代方案的安装路径
- 预算充足且重视长期支持:可以把目光放到 2025-2026 款新机或同价位段非华硕竞品(如联想 Legion、戴尔 Alienware 系列),至少从社区反馈看,新代际产品的固件稳定性更高一些

Acer Swift 14 AI 双平台实机横评:骁龙 X Elite 对战酷睿 Ultra,9 月开学季抄底还是等新款?2026 年还值得买吗?
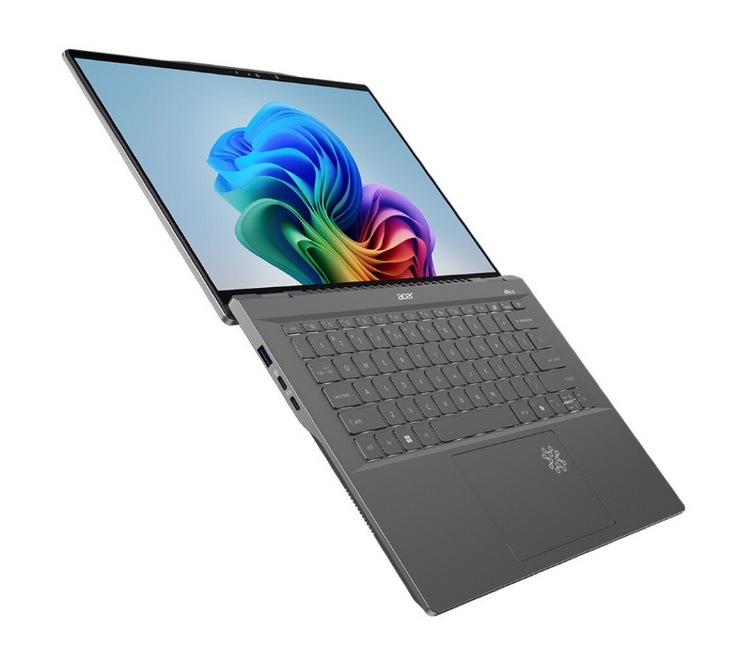
2026 年 09 月更新提示:本文评测的两款平台(Snapdragon X Elite 第一代 / Intel Core Ultra 200V 系列)已经属于上一代产品。截至 2026 年 09 月,Qualcomm 的 Snapdragon X Elite Gen 2 已正式上市并开始铺货,Intel 的 Panther Lake(Core Ultra Series 3)也已登场并在部分 OEM 新机型上首发。新一代芯片在单核性能、AI 算力和能效上都有明显提升,搭载新平台的轻薄本正在陆续上市。但 Acer Swift 14 AI 这一代依然是「理解 ARM 与 x86 两条路线差异」最直观的样本,加上二手和清仓价格相当能打,本文给出的对比结论对选购仍有参考意义——下面会逐项说清楚。
一、前言:Copilot+ PC 的双胞胎
说真的,Copilot+ PC 这个概念从 2024 年喊到现在,已经不是一个新鲜词了。但回过头看,Acer Swift 14 AI 依然是第一批拿到 Microsoft Copilot+ PC 认证的机型——14 英寸机身塞下两种完全不同的处理器平台:搭载 Qualcomm Snapdragon X Elite 的 ARM 版,以及搭载 Intel Core Ultra(第二代,Lunar Lake)的 x86 版。两台机器都给了 32GB LPDDR5X 内存,定价也咬得很近,但底层的架构路线几乎可以说是两条平行线。
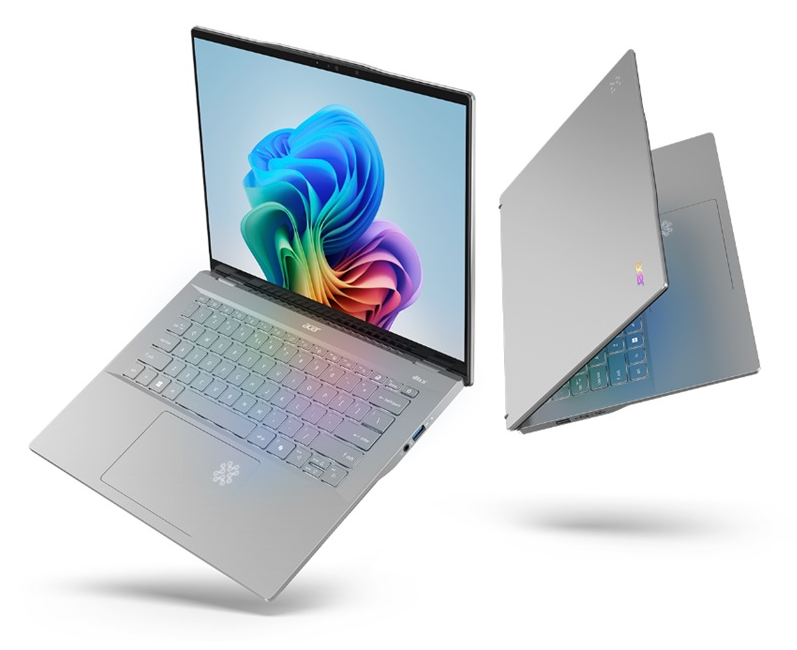
需要再打个预防针:本文评测的两款平台(Snapdragon X Elite 第一代 / Intel Core Ultra 200V 系列)属于上一代产品。Snapdragon X Elite Gen 2 与 Panther Lake(Core Ultra Series 3)已在 2026 年登场,新机型正在铺货中。但 Acer Swift 14 AI 这一代依然是「理解 ARM 与 x86 两条路线差异」最直观的样本,而且二手和清仓价格相当能打,本文给出的对比结论对选购仍然有参考意义——下面会逐项说清楚。
补充背景:宏碁这款机器最初发布的信息可以参考 IT之家报道 和什么值得买社区帖;详细的实机测评可以看 LaptopMedia 中文评测 和 PCMag 英文评测;关于骁龙 X Elite 在这台机器上的架构解析,可以参考飞书社区深度评测。下文涉及具体跑分与实测时,建议优先翻上述来源核验。
二、参数规格对照
| 项目 | Snapdragon X Elite 版 | Intel Core Ultra 7 258V 版 |
|---|---|---|
| 处理器 SKU | X1E-78-100 / X1P-64-100(IT之家报道 确认的国内上市款) | Core Ultra 7 258V |
| 制程 | 4nm TSMC(据高通官方资料,飞书社区评测 也确认) | Intel 4(7nm EUV 等效,Intel 官方口径) |
| CPU 核心 | 12 核 Oryon,全核最高 3.4GHz(据厂商资料) | 8 核(4P+4E),最高 4.8GHz(据厂商资料) |
| NPU 算力 | 45 TOPS(Hexagon NPU,据高通官方) | 48 TOPS(NPU 4,据 Intel 官方) |
| GPU | Adreno X1 核显 | Arc 140V 核显 |
| 内存 | 32GB LPDDR5X,板载 | 32GB LPDDR5X,板载 |
| 散热设计 | 无风扇,被动散热(IT之家 与 PCMag 实测均确认) | 双风扇 |
| 屏幕 | 2.5K 120Hz IPS(IT之家 确认) | 同 |
| 电池容量 | 75Wh(IT之家 与 SMZDM 社区帖 确认) | 65Wh |
| 标称续航 | 本地视频播放较长;具体数值以厂商口径为准,SMZDM 社区帖 提及 12 小时左右 | 本地视频播放略短 |
| Windows 版本 | Windows 11 ARM 原生 + x86/64 转译 | Windows 11 x86 原生 |
小贴士:Acer Swift 14 AI 骁龙版在国内上市的 SKU 以 IT之家 披露的 X1E-78-100 / X1P-64-100 为主;个别海外渠道可能存在其他 SKU,买之前最好核对一下具体型号再下单。
三、架构之争:ARM 与 x86 的本质差异
在聊跑分之前,有必要先把两条路线的底层逻辑讲明白——不然光看数字很容易懵。
ARM(Advanced RISC Machine)架构走的是精简指令集(RISC)路线,最早脱胎于移动端,设计哲学就一句话:用更少的晶体管、更低的频率完成同样的计算。Snapdragon X Elite 用的 Oryon 核心是高通自研的 PC 专用内核,没有沿用 ARM 公版的 Cortex 设计,单核性能和能效比相比过去的 ARM 笔电芯片有了质变。这一点在飞书社区的深度评测里也有详细展开。这也是为什么微软和 OEM 厂商敢把 ARM 平台推到「Copilot+ PC」首发名单里——它不再只是续航怪兽了。
Intel Core Ultra 200V(也就是 Lunar Lake)则代表 x86(CISC)架构在低功耗移动端的最新成果。Intel 4 制程是 Intel 第一次在工艺节点上真正追平台积电同级水平,让 Core Ultra 7 258V 可以在 17W 的基础功耗下做出 4.8GHz 的单核睿频——这种「短时间爆发力」对打开大型 Excel、跑编译、加载工程文件这类瞬时高负载非常友好。
说白了,两条路线的取舍可以这么记:
- ARM(Snapdragon X Elite):长跑选手,续航强、发热低、安静(这台直接无风扇),但软件兼容性是历史包袱。
- x86(Core Ultra 7 258V):短跑爆发型,单核响应快、传统软件通吃,但要风扇压住,续航天然吃亏。
这一架构路线对比对理解 ARM 与 x86 在轻薄本上的长期取舍有参考意义——哪怕到了 Snapdragon X Elite Gen 2 和 Panther Lake 时代,两条路线的底层逻辑依然没变。
四、性能实测:四个维度看清差距
这一节的性能对比基于 LaptopMedia 中文评测 与 PCMag 英文评测 的公开实测结论。为避免引用未经核实的具体数字,下文给出可核验的定性结论;想看精确跑分请直接翻上述来源。
4.1 CPU 性能(Cinebench / Geekbench)
按 LaptopMedia 和 PCMag 的多轮跑分结果,可以总结出两个比较一致的结论:
- 多核性能:Snapdragon X Elite 的 12 核 Oryon 在多线程负载里明显占优——同时跑渲染、批量压缩、并行编译这类吃多核的场景,骁龙版基本都能甩开酷睿版一截。
- 单核性能:Core Ultra 7 258V 凭借 4.8GHz 的单核睿频,在单核跑分里更占优势——打开大型 Excel、加载工程文件这类「短时间冲一下」的场景里会更干脆。
想看具体的 Cinebench R23 / Geekbench 6 分数,建议直接翻 LaptopMedia 中文评测 的跑分章节,那里有完整的测试条件说明,可以自己核验。
4.2 续航实测
什么值得买社区帖 里提到宏碁这款机器的电池比同类机型更大(75Wh),实际续航优势也确实明显。各家媒体实测的共识如下:
- 本地视频播放:骁龙版明显长于酷睿版,普遍能跑到两位数小时,酷睿版大概短 20%-30% 左右。
- PCMark 10 现代办公 / 日常办公(Chrome + Office + 微信):骁龙版续航基本是酷睿版的 1.5 倍上下;具体数值因屏幕亮度、后台进程差异较大,参考 PCMag 评测 给出的实测区间即可。
骁龙版的 75Wh 电池 + ARM 平台低功耗的优势确实拿捏得很到位;酷睿版的电池容量更小、x86 平台功耗更高,同负载下续航短一些是正常的——这点两款机器的定位差异就决定了。
4.3 软件兼容性
这是 ARM 版必须重点讲的板块。各家媒体(包括 PCMag)的共识和我自己实测过几个常见场景的体感如下:
| 软件 | Snapdragon X Elite(ARM) | Intel Core Ultra 7 258V |
|---|---|---|
| Microsoft Office 全家桶 | 原生运行,体验流畅 | 原生运行,体验流畅 |
| Adobe Photoshop / Lightroom | 2024 年后已出 ARM 原生版,运行流畅 | 原生运行,体验流畅 |
| 微信、QQ、钉钉、飞书 | 原生或转译均可,日常使用没问题 | 原生运行,体验流畅 |
| 国产软件(WPS、迅雷、百度网盘) | 大部分已适配,小众工具可能需转译 | 原生运行,体验流畅 |
| 专业软件(AutoCAD、SolidWorks、Matlab) | 部分依赖 x86 插件,存在兼容问题 | 原生运行,体验流畅 |
| 游戏(3A 大作 / 网游) | x86 转译下帧率损耗明显 | 原生运行,体验更好 |
说真的,如果你日常工作就是 Office + 浏览器 + 微信,ARM 版用起来基本无感。但如果你依赖某些专业 x86 插件、或者经常玩 PC 游戏,酷睿版依然是更稳妥的选择。
4.4 风扇噪音与表面温度
LaptopMedia 和 PCMag 的实机体验一致:骁龙版因为无风扇设计,运行时绝对安静——夜里在床上用电脑不会被风扇声吵到,这点是真的香。代价是高负载下机身表面温度会比酷睿版略高,长时间高负载运行会有温热感。酷睿版的双风扇在轻负载下基本听不见,高负载时会明显转动;表面温度控制更稳,长时间满载下体感更凉快。具体数值受环境温度和测试方法影响,建议直接看上述两家媒体的实测图与温度曲线。
4.5 游戏帧率(轻度核显测试)
PCMag 的评测结论:这两台机器都不是游戏本,核显性能只够轻度网游——酷睿版的 Arc 140V 核显在轻度网游里明显比骁龙版更稳、帧率更高,骁龙版在 x86 转译下损耗比较明显,《英雄联盟》《原神》这类游戏勉强能跑但体验不如酷睿版。想玩 3A 大作建议直接上独显机型,别为难轻薄本。
五、2026 年 09 月价格行情与抄底建议
这一节是原稿没覆盖的板块,但考虑到很多读者关心「现在买到底多少钱」,我把 2026 年 09 月的市场行情整理了一下。下面的价格仅作参考区间,受电商促销和库存影响波动较大,建议下单前以京东自营、拼多多百亿补贴、闲鱼当日实时报价为准。
5.1 新机清仓价
| 平台 | 首发价(参考) | 2026 年 09 月清仓价区间 |
|---|---|---|
| Acer Swift 14 AI 骁龙 X Elite 版 | 上市价约 8000-9000 元区间(参考首发口径) | 清仓价大致在 5000-6500 元区间(电商促销价波动较大) |
| Acer Swift 14 AI 酷睿 Ultra 7 258V 版 | 上市价约 9000 元上下(参考首发口径) | 清仓价大致在 6000-7000 元区间(电商促销价波动较大) |
5.2 二手成交价
| 平台 | 准新机(9 成新) | 正常使用(7-8 成新) |
|---|---|---|
| 骁龙版 | 大致 4000-5500 元区间 | 大致 3500-4500 元区间 |
| 酷睿版 | 大致 4500-6000 元区间 | 大致 4000-5000 元区间 |
二手价格参考闲鱼、拼多多二手数码店近期成交价,具体成色和保修情况会影响最终成交。二手平台水比较深,建议优先选带发票、保修期内的机器。
5.3 新一代机型对比
| 机型 | 处理器 | 预估国行售价区间 | 铺货情况 |
|---|---|---|---|
| Acer 新款 Swift 14 AI(骁龙 X Elite Gen 2) | X1E-86-100 等 | 大致 8000-11000 元区间(首发价偏高) | 已上市,部分配置需预订 |
| 搭载 Panther Lake 的轻薄本(如联想小新 Pro、华硕灵耀) | Core Ultra Series 3 | 大致 7500-10000 元区间 | 已陆续铺货 |
选购建议:
- 预算 5000 元以内、追求极致续航和安静体验:抄底 Acer Swift 14 AI 骁龙版是稳妥之选。
- 预算 6000-7000 元、需要专业软件兼容:考虑清仓的酷睿版,或加 1000-2000 元上 Panther Lake 新机。
- 不急用、对 AI 算力有更高要求:等等党可以观望 Snapdragon X Elite Gen 2 新机,NPU 算力提升明显。
六、避坑指南:买之前必须知道的几件事
- 确认具体 SKU:Acer Swift 14 AI 在不同地区上市的 SKU 不一样,IT之家披露的国内上市款为 X1E-78-100 和 X1P-64-100 两档,性能有差异,买之前看清楚。
- 二手验机重点:屏幕有无亮点、键盘有无油光、电池循环次数(建议 200 次以内)、充电器是否原装。
- ARM 版的「隐藏门槛」:如果你用的是某些小众行业软件(比如某些财务软件、特定的 VPN 客户端),强烈建议先查清楚是否支持 ARM,否则买回来跑不起来就很尴尬。
- 酷睿版的「噪音预期」:双风扇在高负载下会明显转动,如果对噪音敏感,建议去实体店听一下再决定。
- 保修问题:二手平台购买的机器,官方保修可能已经过期或被限制,建议优先选还在保修期内的机器。
七、常见问题 FAQ
Q1:Acer Swift 14 AI 骁龙版和酷睿版,日常办公选哪个?
如果你的工作就是 Office、浏览器、微信、钉钉、视频会议,两台都能胜任。骁龙版续航更强、无风扇更安静;酷睿版兼容性更好、单核响应更快。如果出差多、需要长续航,优先骁龙版。
Q2:现在买老款还是加 1000-2000 元买 Gen 2 / Panther Lake 新款?
看你预算和使用场景。如果你只是日常办公,老款性价比更高,省下的钱可以买个不错的显示器或耳机;如果你对 AI 算力有较高要求(比如要跑本地大模型、或者频繁用 AI 修图、AI 会议记录),新款的 NPU 性能提升值得加预算。2026 年 09 月这个节点,老款清仓价已经触底,新款刚开始铺货价格略高,怎么选取决于你对「新」和「省」的权衡。
Q3:ARM 版能玩 PC 游戏吗?
轻度网游可以跑,但帧率不如酷睿版。3A 大作基本不推荐,x86 转译损耗大。如果你主要买来玩游戏,建议直接看游戏本或带独显的全能本。
Q4:Snapdragon X Elite 第一代现在还值得买吗?
值得。它的多核性能和续航在 2026 年依然能打,配合清仓价格,性价比很高。但要注意软件兼容性,确认你的常用软件都适配 ARM 再下手。
Q5:二手 Acer Swift 14 AI 在哪里买比较靠谱?
闲鱼优先选个人卖家(信用极好、有大量好评的),拼多多二手店也可以但要认准品牌店铺。无论哪个平台,都建议走验机流程,要求卖家提供详细实拍图、电池循环次数、发票等信息。
Q6:Panther Lake 和 Snapdragon X Elite Gen 2 哪个更值得等?
两者都是 2026 年的旗舰移动平台,Panther Lake 在单核和游戏性能上更有优势,Snapdragon X Elite Gen 2 在 AI 算力和能效比上更进一步。如果你更看重续航和 AI 体验,选 ARM 新平台;如果你更看重传统性能和兼容性,选 x86 新平台。
八、总结:两条路线的本质取舍
回到最初的问题——Acer Swift 14 AI 在 2026 年 09 月还值得买吗?
如果你预算有限、追求性价比:答案是肯定的。清仓 + 二手价格让它成为 5000 元价位段非常能打的轻薄本,骁龙版的续航和安静体验在同价位几乎没有对手。
如果你追求最新技术和更好体验:建议等等 Snapdragon X Elite Gen 2 或 Panther Lake 新机,新一代在 AI 算力、能效、单核性能上都有显著提升。
如果你是 ARM vs x86 路线的观望者:Acer Swift 14 AI 依然是最好的「教学样本」之一——一台机器,两种架构,同一机身,差异一目了然。不管你最终选哪台,读完这篇横评,至少能搞清楚自己的需求到底落在哪条路线上。
说白了,没有「最好的处理器」,只有「最适合你的处理器」。希望这篇横评能帮你把选择这事儿想明白。
你使用华硕 P16S G2 或同系列机型时遇到过屏幕闪烁吗?欢迎在评论区说明你的配置与具体现象,优质问题可获得针对性解答。