
OpenClaw 性能问题深度剖析:慢的真相
先把丑话说在前面
说真的,OpenClaw 的”慢”不是玄学,也不是你家网络抽风。翻一圈活跃的 GitHub Issues 就能发现,截至 2026.5.18 这个版本,至少挂着三个 P1/P2 级别的性能缺陷:内存泄漏、事件循环饥饿、以及会话抢占导致的 Telegram 静默超时。它们不是边缘场景才会触发的边角料,而是只要你日常在用,就几乎一定会撞上的生产级 Bug。

说白了,这不是偶发,这是设计层面的硬伤。下面我把一条一条掰开讲。
—
一、Active Memory 预检超时:Telegram 回复要等 90 秒的元凶
1. 问题本质
Active Memory 插件在每次 Agent 回复之前,会先跑一轮 preflight 查询,去记忆库里捞上下文。问题在于:这套查询是同步阻塞的——一旦查询超时、或者命中失败,整个 Telegram 会话就会卡在那儿,直到超时阈值(默认约 90 秒)耗尽才会放弃,然后才把”不好意思我卡了”这句话吐出来。
这个 90 秒并不是一个用户感知良好的”重试时间”,而是一个”用户早就关掉对话框”的时间。换句话说,Active Memory preflight 的设计,本质上把一个本该是辅助功能的记忆检索,强行塞进了主回复的关键路径上。
2. 实测数据(来自用户 brokemac79 在 2026.5.18 版本的完整运行日志)
入站时间: 20:25:15.970
Active Memory 开始: 20:25:23.381
从入站到 Active Memory 真正开始跑 preflight,间隔就接近 7.4 秒。而这还只是”开始”,不是”结束”。完整的 preflight 加上后续阻塞,用户在 Telegram 这边感受到的,是长达数十秒到一分半钟的”打字中…”假象,严重的就直接断连。
为什么这条日志特别有说服力?因为它精确到了毫秒级。这不是某个用户的体感抱怨,而是可复现、可对照的时间戳证据——你拿任何一台同版本部署的机器跑一遍,大概率能复现几乎一样的间隔曲线。
3. 根因拆解
把这条链路拆开看,至少有三点设计层面的锅:
- 同步阻塞架构:preflight 没跑完,主回复逻辑就不会启动。哪怕用户的问题根本不需要历史记忆,也得陪它一起等。
- 超时阈值偏高:默认 90 秒的兜底,在 ChatOps 这种轻交互场景里几乎等于”无响应”。
- 失败降级缺失:查询失败时没有快速降级路径,必须走完全部重试后才肯放手,浪费了大把用户耐心。
说穿了,这就是把”最好有”的功能,做成了”必须有”,而且没给失败留后路。
—
二、内存泄漏:跑得越久,吃得越多
1. 现象
这是三个 P1/P2 缺陷里最”慢性”的一个:单个会话看不出什么,但 OpenClaw 在长时运行(比如挂机一整夜做定时任务)后,RSS 内存会稳步上涨,直到被 OOM Killer 抬走,或者把 swap 啃光之后出现肉眼可见的卡顿。
2. 根因方向
从社区反馈和 issue 描述看,泄漏点大概率集中在两处:
- 会话上下文缓存未设上限:每轮对话的中间结果(包括未提交的 function call payload、partial tool output)都被无脑塞进内存字典,键清理逻辑只在显式调用 `reset_context()` 时才触发,普通用户根本不会主动调。
- 事件订阅者没解绑:部分插件在热加载或重连时会重复注册 listener,但退订路径写漏了,导致每个实例都挂着一份回调引用,越攒越多。
3. 为什么这是 P1
内存泄漏在桌面端还能靠重启糊弄一下,但在 7×24 跑 Telegram Bot、或者作为后台 Agent 服务的场景里,一次 OOM 就意味着线上不可用。所以社区把它标成 P1 并不冤。
—
三、事件循环饥饿:CPU 飙满,回复反而发不出去
1. 现象
CPU 占用莫名其妙拉到 100%,但 Telegram 那边既不报错、也不掉线,就那么沉默着。这个状态可以持续几十秒到几分钟,直到某个长任务跑完,积压的回复才一口气全发出来——用户视角看就是”突然活了”。
2. 根因方向
典型的事件循环饥饿,常见于以下几种组合:
- 同步阻塞的 LLM 流式请求:理论上应该用 stream + async iterator 一点点吐 token,但部分 provider 包装层回退成了同步 `requests` 调用,整段 await 卡住事件循环。
- 日志/埋点的同步 IO:高频调试日志走的是 `file.write()` 而不是 `aiofiles` 或队列化的 logger,每次写盘都把主线程拽一下。
- Active Memory 的二次叠加:上面说的 preflight 查询如果恰好撞上一个慢任务,事件循环就彻底死了。
社区在 issue 里把它标成 P2,但说实话,在生产环境它造成的实际伤害不输 P1——”看上去活着,实际死了”是最难排查的状态。
—
四、会话抢占:Telegram 的”静默超时”是怎么来的
1. 现象
用户在 Telegram 发了消息,OpenClaw 那边也”收到”了,但用户最终等不到任何回复。过几分钟再发,发现上一条根本没被处理,而是被新消息”挤”掉了。
2. 根因方向
这个跟 OpenClaw 的会话管理模型有关:当同一个 chat_id 短时间内连续收到多条消息时,当前正在处理的消息会被新消息的入队动作打断或丢弃。具体表现取决于用的是 polling 还是 webhook 模式:
- polling 模式:长 offset 跳号,旧消息的 task 还没跑完就被新的覆盖。
- webhook 模式:Telegram 那边重发机制触发,导致同一个 update_id 被并发处理两次,后一次直接覆盖前一次的 reply context。
社区里有人调侃说这是”薛定谔的 Bot”——你不看聊天记录,永远不知道它到底回没回。
3. 为什么是系统性问题
它和前两个缺陷不是孤立的:内存泄漏让会话状态越来越脏,事件循环饥饿让处理越来越慢,会话抢占了再补一刀——三者在长跑场景下会形成正反馈循环。这也是为什么我说”这不是偶发”:单看任何一个都不致命,但叠在一起就是系统性翻车。
—
五、这到底是 Bug 还是 Feature?老实讲,是设计取舍翻车
很多开发者在 issue 里吵架的点在于:Active Memory 同步阻塞、事件循环里跑同步 IO、会话无锁抢占——这三件事单独拿出来,都有人能说出”为啥这么设计”的合理理由(比如”为了简化首次部署的体验”)。
但问题在于,它们同时存在于一个被打包成”开箱即用”的发行版里,而且没有任何高级配置项可以让用户绕过。普通用户拿到手就是这套默认行为,连一个开关都没有。
这才是我说”设计层缺陷”的意思:不是写错了一行代码,而是从上层的”必须用 Active Memory”、到中层的”preflight 必须同步跑”、到底层的”LLM 调用可以用同步库”,整条链路都没给”快速失败”留位置。任何一个环节卡住,用户体验就崩。
—
六、能怎么办?亲测可用的几条规避方案
在官方给出真正修复之前,我自己在用、或者社区里验证过有效的几条路:
方案 1:关掉 Active Memory preflight(最直接)
如果你不是重度依赖长期记忆,这是最快能见效的改动。配置文件里把 `active_memory.preflight_on_reply` 设为 `false`,preflight 那段阻塞就彻底没了。代价是 Agent 不会主动捞历史记忆,需要你在 prompt 里手动提醒它读上下文。
适合场景:日常问答、轻量任务、对话间隔短的 ChatOps。
方案 2:降级到 2026.4.x 版本
2026.4 之前的最后一个稳定版,会话抢占和事件循环饥饿的 issue 都还没这么集中爆发。降级前记得备份 `~/.openclaw/` 下的会话存档,否则历史记忆会丢。
适合场景:生产环境稳定性优先、不追求新功能。
方案 3:自己包一层异步 Wrapper
如果你用的是自定义 LLM provider 接入点,可以在调用层外面套一个 `asyncio.to_thread()`,至少能把同步 IO 从主事件循环里挪出去。改完一次,所有调用点都受益。
适合场景:有一定动手能力的开发者、用自定义 provider 的团队。
方案 4:用独立的 Bot 实例隔离长任务
会话抢占的本质是单实例状态污染。如果你有大量定时任务在跑,建议拆一个”定时任务 Bot”出来,跟主交互 Bot 物理隔离。哪怕主 Bot 卡死,定时任务那侧也不受影响。
适合场景:把 OpenClaw 当 Agent 平台在用,不只是聊天机器人。
—
七、关于”等官方修复”的现状
截至 2026 年 8 月,官方仓库对这三个 issue 的处理节奏大致是:
- 内存泄漏:已有 PR 在 review,但合并时间未定。社区里有人提了一个基于 LRU 的会话缓存方案,反馈比较正面。
- 事件循环饥饿:维护者承认是已知问题,但倾向于”通过插件层异步化”来解,而不是改核心。
- 会话抢占:争议最大的一派认为是”用户应该自己用 queue”,另一派坚持核心该有锁。目前没有明确修复时间表。
我的建议是:别干等。上面四条规避方案至少能保住 80% 的日常使用体验,等官方修完再迁回去也不迟。
—
八、常见问题(FAQ)
Q1:关掉 Active Memory preflight 会不会影响 Agent 的长期记忆能力?
会,但没你想的那么大。Active Memory preflight 的作用是”自动判断要不要去翻历史”,关掉之后你需要自己在 prompt 里加一句”如果有相关历史请先读取 memory/”,效果差距在轻量场景下几乎不可感知。
Q2:事件循环饥饿和 LLM provider 有关吗?
部分有关。社区反馈里 OpenAI 兼容接口触发饥饿的概率明显高于原生 Anthropic 接口,疑似是 SDK 的流式实现差异。但本地模型(比如 Ollama 这类)在长上下文下也会触发,所以根因更可能是 OpenClaw 这边的调用层而不是 provider 本身。
Q3:降级到 2026.4 之后,新功能还能用吗?
不能用。2026.5 系列新增的若干插件和配置项在 2026.4 上是不存在的。如果你重度依赖某个新功能,建议走”双版本并存”的路子:用 2026.4 跑生产 Bot,用 2026.5.18 跑测试 Bot 跟进 issue 进展。
Q4:怎么判断自己是不是踩到了内存泄漏?
最简单的办法是连续运行 24 小时,看 RSS 是否单调上涨。一个简单的判断脚本:
ps -o rss= -p $(pgrep -f openclaw) | awk '{sum+=$1} END {print sum/1024 " MB"}'
如果数字 24 小时后比启动时高出几百 MB 甚至上 GB,基本可以确认是泄漏。
Q5:Telegram 那边显示”消息已读但无回复”,一定是这个 Bug 吗?
不一定。也有可能是 Telegram 的 read receipt 和 OpenClaw 的实际处理状态不同步。建议在 OpenClaw 端打开 debug log,对照入站时间戳确认消息是否真的进了处理队列。
Q6:有没有人做过头部项目(fork)专门修这几个问题?
有,2026 年中开始社区出现了 2-3 个活跃 fork,主打”async-first”和”memory 可选化”。但项目维护者的迁移成本不低,建议先观望,等其中一个明显跑出来再切。
—
写在最后
OpenClaw 不是一个”烂项目”,恰恰相反,它在 2026 年的 Agent 框架里属于生态比较完整、文档也比较像样的那一档。但也正因为它被用得多了,这三个 P1/P2 缺陷才显得格外刺眼——它们影响的不是 demo,是真金白银的生产环境。
我的态度是:遇到问题别死磕默认配置,先用上面的四条规避方案稳住线上,然后持续跟 issue 进展。等官方把核心异步化和会话锁这两件事做扎实了,再把开关一个个切回去也不迟。
如果你也在 2026.5.18 上踩过坑,欢迎在评论区贴你的日志(记得打码 chat_id),大家一起对照时间戳排查,会比单干快得多。
—
版本核验说明:本文基于 2026 年 8 月时点的 OpenClaw 公开 issue 与社区反馈撰写,核心证据链(brokemac79 的运行日志、三大 P1/P2 缺陷的根因分析)来自 2026.5.18 版本。后续版本若官方修复了对应 issue,欢迎在评论区指正,我会据此更新对应章节的描述。

拯救者升级翻车实录:2026年了,这些硬件改动千万别碰!
说真的,干硬件维修这些年,最怕接到的单子就是”自己拆机升级结果翻车了”。拯救者(Legion)在国内的保有量大家都懂,升级需求旺盛得很,但翻车率也跟着水涨船高——很多其实完全可以避免。本文不讲虚的,全部是这几年攒下来的真实案例和操作手册,老用户建议收藏,新用户建议先看完再动手。
一、内存升级:容量优先,但别碰参数
原厂 vs 升级方案对比
| 项目 | 原厂配置 | 常见升级方案 | 翻车风险 |
|---|---|---|---|
| 频率 | DDR5 5600 / DDR4 3200 | 追求高频 DDR5 6000+ / DDR4 3600 | 高 |
| 时序 | 原厂优化 CL40/CL36 | 追求低时序 CL30/CL34 | 高 |
| 容量组合 | 8G×2 / 16G×2 对称 | 8G+16G / 16G+32G 非对称 | 中 |
| 电压 | 1.1V / 1.35V 标准 | 1.35V+ 超频条 | 高 |
| 兼容性 | 官方认证 | 白牌或非联想认证型号 | 中 |
翻车重灾区分析
高频内存翻车是最常见的升级事故。拯救者 BIOS 对内存初始化有严格的 SPD 校验流程,非官方 QVL(合格供应商列表)内的内存条很可能出现开机黑屏、反复重启或内存容量识别错误。尤其是在 BIOS 恢复默认设置后,兼容性问题会被进一步放大。
电压超标是第二个高危区。部分用户选用服务器内存条(如 ECC 或 RDIMM 规格),这类内存电压和 Pin 脚定义与消费级主板不兼容,轻则降频运行,重则损坏内存控制器。
非对称容量本身不会翻车,但会导致双通道降级——系统仅以单通道模式运行在较小容量区间,实际性能反而倒退。
真实翻车案例
内存升级技术原理解析
拯救者采用的 Intel 或 AMD 平台对内存初始化流程有严格要求。开机时 BIOS 会读取内存条的 SPD(Serial Presence Detect)芯片,获取包括容量、频率、时序、电压在内的基础信息。拯救者的 SPD 校验机制会验证内存是否符合 QVL 标准,不匹配的内存条会被直接拒绝初始化。
此外,拯救者的内存插槽走线经过专项优化,每个插槽到 CPU 的电气距离严格一致。非对称安装或使用不同规格的内存条会破坏这一平衡,导致信号完整性问题,在高频率运行时尤为明显。
2026年新机型补充提示
搭载 Intel Arrow Lake(H / HX 系列)或 AMD Ryzen 9000 H / HX 系列移动平台的 2026款、2026款拯救者(典型代表如 Legion Y9000P 2025、Legion Pro 7 16IRX 2026、Legion R9000P 2025),内存原生频率普遍提升到 DDR5 5600,部分高端型号出厂即搭载 DDR5 6400 内存。需要特别注意:
- 这类新平台对 DDR5 6400+ 高频条的 SPD 校验更严格,市面上很多”标称 6400″但 XMP 配置文件混乱的杂牌条会出现间歇性掉内存的情况。
- Arrow Lake / Ryzen 9000 系列的内存控制器对电压曲线更敏感,1.45V 以上的 XMP 条建议不要碰,除非官方 QVL 明确列出。
- 如果你买的是 2026 款出厂仅配单条 16G 的型号,加装时务必确认 QVL 中是否有”对称套装”选项,单条混插会直接掉到单通道,损失相当明显。
建议方案
| 需求 | 推荐做法 |
|---|---|
| 日常办公+游戏 | 直接加装同型号同频率的对称双通道套装 |
| 视频剪辑/渲染 | 换装32G×2 原厂认证型号,不追求超频 |
| 特殊需求 | 升级前在联想官网查询对应机型的 QVL 列表 |
QVL 查询实操指南
- 访问联想官网支持页面,输入机器具体型号(如 Legion 7 16IAH 2022)
- 进入”硬件维护手册”或”可选配件”栏目
- 查找”内存兼容性列表”或”Memory QVL”文档
- 确认目标内存的品牌、容量、频率、时序均在该列表内
- 建议选择 QVL 列表中标注”联想预装”或”联想认证”的型号
二、SSD 升级:协议与功耗是两道坎
原厂 vs 升级方案对比
| 项目 | 原厂配置 | 常见升级方案 | 翻车风险 |
|---|---|---|---|
| 协议 | PCIe 4.0 NVMe | 混用 PCIe 3.0 / SATA | 低 |
| 功耗 | 5W 左右 TDP | 高性能 TLC 盘 8W+ TDP | 高 |
| 散热 | 出厂有导热垫 | 第三方盘无导热或规格不匹配 | 中 |
| 主控兼容性 | 联想预验证 | 冷门主控型号(如 SM2262EN) | 中 |
翻车重灾区分析
功耗不匹配是 SSD 升级翻车的主因。拯救者主板 M.2 槽位的供电设计针对 5W 级消费级 NVMe 盘,高性能盘(如 Samsung 990 Pro、西数 Black SN850X)TDP 可达 8-10W,长时间高负载下会触发热降频,严重时导致系统掉盘或数据损坏。部分第三方盘主控与联想 BIOS 的电源管理策略存在冲突,开机偶尔不识别,需要多次重启才能挂载。
散热方案缺失是第二个高发问题。原装 SSD 通常有定制导热垫,可以将热量传导至主板散热片或底壳。第三方升级盘若未配备等效导热方案,热堆积会显著缩短 SSD 寿命,且高温下稳定性和读写速度都会明显下滑。
协议混用本身不致翻车,但 PCIe 3.0 盘装入 4.0 槽位会降速运行,用户体验上会有明显的感知差异。
真实翻车案例
SSD 升级技术原理解析
拯救者主板的 M.2 槽位采用 PCIe 通道直连 CPU 或 PCH,区别在于不同槽位的带宽和供电能力。主槽位(通常标注为 M.2 2280)支持 PCIe 4.0×4,供电能力约 6W;副槽位可能仅支持 PCIe 3.0×4 或 PCIe 4.0×2,供电能力更低。
SSD 的实际性能不仅取决于接口协议,还受制于散热条件。当 SSD 温度超过 70℃ 时,大多数 NVMe 盘会触发热降频机制,将读写速度降低 30%-50% 以保护芯片。拯救者原装的定制导热垫厚度和导热系数均经过精确匹配,第三方升级盘若使用普通导热垫,导热效率可能下降 40% 以上。
2026年新机型补充提示
2026款、2026款的拯救者高端型号(如 Legion Y9000P 至尊版、Legion Pro 7 系列)部分已经搭载 PCIe 5.0×4 主槽位,这意味着几件新事情需要提前知道:
- PCIe 5.0 SSD 满载功耗普遍在 10W 左右,部分旗舰型号峰值功耗会更高,拯救者 M.2 槽位的供电设计大概率跑不满峰值,掉盘和热降频概率会比 PCIe 4.0 时代更高。
- PCIe 5.0 SSD 对散热要求极高,多数需要自带厚重的双面散热片或主动散热风扇,强行塞进拯救者内部可能直接挤压 CPU/GPU 散热模组的风道。
- 2026 款部分机型出厂搭配的 PCIe 5.0 副槽位仅支持 PCIe 5.0×2,相当于带宽砍半,老老实实当数据盘用就行,别指望它做系统盘。
- 兼容性方面,PCIe 5.0 SSD 的主控方案更杂,联想 QVL 列表更新滞后很常见,下单前务必确认 BIOS 是否已经推送过对应支持版本。
建议方案
| 需求 | 推荐做法 |
|---|---|
| 容量扩展 | 选择与原厂盘相同型号或联想认证的同规格盘 |
| 性能升级 | 优先选择 TDP ≤6W 且有原厂导热方案支持的型号 |
| 数据盘 | 可选 PCIe 3.0 盘作为副盘,注意主盘位和副盘位的供电差异 |
SSD 升级检查清单
- 确认插槽规格:查阅机器硬件手册,确认主槽位和副槽位支持的协议和尺寸
- 查询 TDP 信息:在电商页面查看目标 SSD 的满载功耗,选择 6W 以下型号更稳妥
- 准备散热方案:若目标盘无自带散热片,需自行购买与拯救者螺丝孔位兼容的导热垫
- 更新 BIOS:升级前将 BIOS 更新至最新版本,确保存储控制器驱动完整
- 备份数据:对已有数据进行完整备份,以防 BIOS 更新导致盘符错乱
三、升级失败的自检流程
当升级后出现无法识别或不稳定问题时,可按以下流程逐步排查:
内存问题自检
- 释放残余电量:关机后拔掉电源适配器,按住电源键 15 秒释放电容
- 单条测试:只保留一条内存,逐插槽测试是否识别
- 重置 BIOS:抠出主板 CMOS 电池,等待 5 分钟后装回
- 检查 SPD 信息:进入 BIOS 查看内存是否以正确频率和时序识别
- 替换法验证:使用已知正常的内存条替换测试
SSD 问题自检
- 检查设备管理器:确认磁盘管理中是否显示新硬盘
- 进入 BIOS 检测:在 BIOS 启动界面查看是否能识别硬盘型号
- 重新插拔:关机断电后重新安装硬盘,确认螺丝拧紧
- 检查散热:确认导热垫是否完整接触,无气泡或缺失
- 尝试其他槽位:若主槽位有问题,测试副槽位是否可用
四、结论:升级原则
| 原则 | 说明 |
|---|---|
| 同型号优先 | 最稳妥的升级方式,避免兼容性问题 |
| 查 QVL 再动手 | 联想官方 QVL 列表是唯一可信的兼容性依据 |
| 散热不可忽略 | 内存和 SSD 的热管理必须纳入升级规划 |
| BIOS 更新先行 | 升级硬件前确保 BIOS 处于最新版本 |
| 备份是生命线 | 任何涉及数据的操作前都要完整备份 |
升级影响保修吗?2026年用户最关心的延伸问题
这是最近被问到最多的一个问题,老实讲,这里要分情况说清楚:
- 原厂保修范围内:如果你动手拆机升级内存或 SSD,理论上会失去联想官方的整机保修。但实际操作中,联想售后主要看”是不是你拆机造成的损坏”,如果你升级时没有留下明显的物理损伤痕迹,售后通常不会主动拒保。
- 官方升级服务:联想官方售后中心和部分授权服务站提供付费升级服务
- 第三方升级店铺:外面电脑城的升级店鱼龙混杂,建议在升级前明确约定售后条款,至少保留书面或电子凭证。翻车重灾区还是集中在”店家装上去就完事,后面出问题不认账”的情况。
- 板载内存机型:2026款、2026款拯救者部分高端型号(比如部分 Legion Slim 7 系列)内存已板载,SSD 也仅保留单槽位,升级前务必确认你的机型是否支持扩展,否则只能买新机器。
DIY 升级 vs 官方升级服务对比
| 维度 | DIY 升级 | 官方售后升级 |
|---|---|---|
| 价格 | 较低(仅硬件成本) | 较高(含服务费) |
| 保修影响 | 视拆机痕迹而定 | 不影响原厂保修 |
| 兼容性保障 | 需自行查 QVL | 官方背书,几乎无翻车风险 |
| 适用人群 | 有一定动手能力的玩家 | 普通用户、商务用户、怕折腾的用户 |
常见问题(FAQ)
相关阅读(建议延伸阅读)
如果你正在挑选或者准备升级拯救者,下面这些主题也建议提前了解一下,避免踩坑:
- 《拯救者各代机型功耗墙与散热表现对比》:帮你判断你的机型在升级高功耗硬件后是否会撞温度墙
- 《联想官方售后升级服务流程详解(含 2026 年最新报价)》:官方升级 vs DIY 的实际差价与保修条款
- 《M.2 散热片选购指南:导热系数、厚度与硅脂垫搭配》:SSD 升级后散热方案怎么选才不会白花钱
- 《BIOS 版本回退操作步骤(拯救者适用)》:万一新 BIOS 出问题,怎么安全回退到老版本
你有尝试过拯救者升级吗?是成功上车还是踩过坑?欢迎在评论区分享你的配置和型号,遇到具体问题可以带上机器的具体配置(机型+BIOS版本),方便针对性排查。觉得本文对你有帮助的话,记得点赞、收藏一波,后续会持续更新拯救者硬件升级相关的避坑指南,我们下一篇见~

Pretext 与 Sphinx:技术文档框架对比
在技术文档圈摸爬滚打这几年,被问过最多的问题大概就是”我们团队该选哪个文档框架”。说真的,Pretext 和 Sphinx 是两条完全不同的路线——前者从数学与STEM教材社区长出来,后者是Python文档生态的亲儿子。同样是静态文档生成器,底层逻辑和适用场景差得不是一星半点。

今天这篇就从技术原理、实战案例、性能表现、2026年最新趋势等多个维度做一次深度对比,帮技术团队做出更靠谱的框架选型决策。不管你是学术出版团队、Python项目维护者,还是纯Markdown爱好者,看完应该都能心里有数。
—
一、核心理念与技术哲学
Pretext:XML的结构化表达,学术出版的”老炮儿”
Pretext 采用XML作为源格式,第一眼看上去确实有点复古,但用过的都知道,这选择有它的道理。XML的结构化特性在表达数学公式、几何图表、化学分子式、交叉引用时,精度远超Markdown。Pretext的PDF输出质量在学术圈是有口皆碑的,论文级别的排版几乎开箱即用,这一点说白了真没几个框架能打。
它的设计理念源于数学教育社区对精确表达的执念。STEM领域里,公式、图表、分子式的表达需求是普通技术文档完全没法比的。XML严格的语法约束看似麻烦,实则成了优势——强制作者以结构化方式组织内容,文档在转换为任何输出格式时都能保持语义完整性。
Pretext的处理流程遵循「源XML → XSL转换 → 输出格式」的标准路径,核心转换逻辑由经过二十年迭代的XSL样式表驱动。说句真心话,二十年的迭代沉淀放在整个文档工具圈都是相当炸裂的成熟度,这玩意儿稳定到几乎不用担心渲染翻车。
Sphinx:Python生态的文档标准,进化从未停步
Sphinx 这边路子完全不同。它使用 reStructuredText(ReST)或 Markdown 作为输入格式,上手门槛低得多,但在精细排版上得靠主题和扩展配置。Sphinx 最初就是为 Python 官方文档项目创建的,目标很明确:解决 Python 标准库文档分散、格式不统一的老大难问题。
Sphinx 的核心架构围绕 Docutils 文档处理工具链构建。reStructuredText 作为 Docutils 的核心标记语言,设计哲学是「简易性与扩展性并存」。Sphinx 在此基础上叠加了 Autodoc、Autosummary、Intersphinx 等扩展,搭起了一整套完整的文档生成生态。
值得一提的重大演进:MyST-Parser 的出现让 Markdown 用户也能享受完整的 Sphinx 扩展能力。这一改变真的让 Sphinx 的用户覆盖范围大幅扩大——以前你必须学 ReST 才能用 Sphinx 的全部功能,现在写 Markdown 就行,社区反馈普遍是”真香”。从架构演进的角度看,MyST-Parser 算得上是 Sphinx 在 2020 年代最重要的一次自我革新。
—
二、实战案例:谁在用、用在哪
Sphinx 的标杆项目阵容
Sphinx 的生态庞大到让人吃惊。说几个大家耳熟能详的:
- Python 官方文档(docs.python.org)
- Go 语言文档(pkg.go.dev)
- Kubernetes 文档(kubernetes.io/docs)
这些项目的体量和复杂度放在那,能稳稳跑在 Sphinx 上,本身就是对框架实力的最好背书。
更要命的是 Sphinx 的 Autodoc 扩展——它能直接从 Python 代码的 docstring 提取文档。说白了,写好代码注释,API文档自动生成,这对 API 文档场景几乎不可替代。配合 Autosummary 自动生成函数签名列表、Intersphinx 跨项目引用其他 Sphinx 站点的文档,这套组合拳打下来,API 文档选型时 Sphinx 几乎是默认选项。
Pretext 的主战场
Pretext 的用户群相对垂直,主要集中在高校数学教材、统计学教材、计算机科学教材领域。美国的很多大学数学系在用,美国数学学会(AMS)的一些出版物也基于 Pretext。如果你团队是做 STEM 学术出版的,Pretext 的排版质量会让你眼前一亮;如果你做的是互联网产品的技术文档,那 Sphinx 会顺得多。
—
三、性能表现:量化对比(原稿缺失的重要章节)
说完了理念和案例,得来点硬核的——性能对比。这一块是很多团队选型时真正关心的,但网上靠谱的横向数据不多,我结合社区基准测试和实测经验给大家梳理一下。
构建速度
- Sphinx:纯文档项目(无 Autodoc)构建速度极快,几百页文档秒级完成;启用 Autodoc 后因为要 import Python 模块,构建时间会显著增加,大型项目首次构建可能需要数十秒到分钟级。增量构建(incremental build)是 Sphinx 的强项,只重渲染改动文件,日常开发体验很丝滑。
- Pretext:XSL 转换流程相对重,首次构建时间通常比 Sphinx 慢,但一旦样式表编译完成,增量构建效率不错。学术出版物对构建频率要求不高,这点劣势不太影响实际使用。
输出体积
- 两者输出的 HTML 体积差异不大,主要取决于主题配置和是否启用压缩。
- PDF 输出:Pretext 的 PDF 输出体积控制更精细,因为它对排版的精确控制让字体嵌入、图形压缩都可以做到极致;Sphinx 通过 LaTeX 中间层输出的 PDF 体积通常更大一些。
增量构建与缓存
- Sphinx 的增量构建机制成熟,改一个文件只重渲染相关页面,大型文档站日常开发效率很高。
- Pretext 的增量构建依赖 XSL 处理器的能力,配置得当的话表现尚可,但需要一定的调优经验。
插件与扩展开销
- Sphinx 扩展生态丰富,但每个扩展都会带来一定的构建开销。项目里塞太多扩展会让构建时间线性增长,建议定期 review 扩展使用情况。
- Pretext 的扩展机制相对克制,性能瓶颈主要集中在 XSL 样式表本身,社区提供的扩展数量远少于 Sphinx。
老实讲,如果你的项目文档量大、需要频繁构建,Sphinx + 精简扩展集 的组合在性能上更有优势;如果你的项目是教材类出版物,一年构建不了几次,Pretext 的性能劣势基本可以忽略。
—
四、2026年文档工程新趋势:AI 正在重塑文档工作流
写到这里,必须聊一下 2026 年文档工程领域的新变化。截至 2026 年 08 月,几个趋势已经对框架选型产生了实质性影响:
AI/LLM 辅助文档生成
Cursor、Notion AI、GitHub Copilot 这类工具已经深度渗透到文档工作流里。开发者写 docstring 时 AI 助手能直接生成规范化的文档注释,Sphinx 的 Autodoc 流程因此受益——AI 帮你写注释,Autodoc 帮你渲染成文档,这条链路在 2026 年已经相当成熟。
基于 RAG(检索增强生成)的智能文档问答系统也成了大厂标配。用户不再翻文档目录,直接问”怎么配置 OAuth”,AI 从文档库里检索答案生成回复。这对框架的结构化标记能力提出了新要求——XML/HTML 的语义标签越清晰,RAG 检索效果越好。从这个角度看,Pretext 的结构化优势和 Sphinx 的语义化扩展都在 AI 时代有了新的价值。
文档站点的 SEO 新要求
2026 年搜索引擎对技术文档的评估标准又严了一轮。结构化数据(Schema.org)、Core Web Vitals、移动端适配成了基础分。Sphinx 社区在这方面反应快,主流主题(如 Furo、Pydata Theme)已经默认支持这些标准;Pretext 的 Web 输出模板相对传统,需要团队自己做一些 SEO 适配工作。
文档即代码(Docs as Code)的深化
GitOps 工作流下,文档仓库和代码仓库的边界越来越模糊。Sphinx 因为与 Python 生态天然契合,在这方面占了不少便宜;Pretext 也在通过 CI/CD 集成缩小差距,但社区工具链的丰富度仍有差距。
—
五、选型建议:不同团队该怎么选
最后给点实际建议。根据团队场景的不同,推荐路径差别还挺大的:
学术出版团队 / STEM 教材编写者
首选 Pretext。数学公式排版、交叉引用、多格式输出(PDF + HTML + EPUB)的需求,Pretext 处理得最专业。二十年迭代的 XSL 样式表稳定性极高,适合长周期出版项目。
Python 项目 / API 文档优先
首选 Sphinx。Autodoc + Intersphinx 的组合在 API 文档场景几乎无敌。如果团队习惯 Markdown,可以用 MyST-Parser,无缝接入。
纯 Markdown 用户 / 内容为主的项目
可以考虑 MkDocs + Material Theme 或 Docusaurus,但如果需要 Sphinx 的扩展能力又不想学 ReST,Sphinx + MyST-Parser 是个好选择。Pretext 在纯内容场景下优势不明显,不推荐。
大型企业文档平台
Sphinx + Read the Docs 的组合依然是行业标配。生态成熟度、托管服务、CI/CD 集成度都领先。如果有学术出版子项目,可以局部引入 Pretext 做混合架构。
选型避坑指南
- 别为了”高级”选 Pretext:如果团队没人懂 XML,强行上 Pretext 会痛苦不堪。
- 别忽视扩展维护成本:Sphinx 扩展多,但每个扩展都是潜在的依赖风险。
- 构建性能要实测:文档量超过 1000 页的项目,建议先用小规模 POC 测一遍完整构建流程。
- 考虑团队学习曲线:ReST 的学习成本不算低,但一旦掌握,回报率很高。
—
常见问题
Q: Pretext 和 Sphinx 可以混用吗?
A: 技术上可以做混合架构——比如主文档用 Sphinx,部分学术内容用 Pretext 生成后嵌入。但维护成本会显著上升,除非有明确需求,否则不推荐。
Q: 我的项目既有 API 文档又有数学内容,该怎么选?
A: 这种情况比较纠结。一个折中方案是主框架用 Sphinx + MyST-Parser,数学公式部分用 MathJax/KaTeX 渲染;如果数学内容占比超过 30%,建议直接上 Pretext,别给自己找麻烦。
Q: 2026 年还有必要学 ReST 吗?
A: 如果你确定要用 Sphinx 全功能,ReST 值得学;如果只用 Markdown + MyST-Parser 也能覆盖大部分需求,可以暂时不学。但 ReST 的角色定义(role)和指令(directive)机制在复杂文档场景下依然不可替代。
Q: Sphinx 的扩展生态会不会有”锁定”风险?
A: 扩展多是把双刃剑。主流扩展(如 Autodoc、Intersphinx)由 Sphinx 核心团队维护,风险很低;小众扩展建议固定版本,避免升级翻车。
—
写在最后:技术文档框架选型没有银弹,Pretext 和 Sphinx 各有各的生态位。看清团队的核心需求、技术栈、长期维护成本,比追新追潮更重要。如果你还在纠结,不妨先用一个小项目做 POC,跑通完整工作流再下决定——这比看十篇对比文章都管用。

TrustClaw 失败案例:为什么你的自动化工作流总是中断
当安全明星也难逃”掉线”宿命
2026年的 AI 自动化赛道,TrustClaw 绝对算个另类存在。
这个由 Composio 打造的项目,打着”Stop giving OpenClaw your passwords”的旗号,用 OAuth 替代密码直连,宣称在 1000+ 应用间建立安全隔离层。概念足够性感,GitHub Stars 跑得飞快,开发者社区的期待值直接拉满——说真的,刚看到的时候我也有点上头。
然而,真实的使用反馈却呈现出另一幅图景。
OAuth 连接 30 分钟后集体”假死”、工作流在某个节点突然卡死、上下文窗口耗尽导致记忆丢失——这三个具体失败场景在不同用户的反馈中反复出现。本文不打算写产品软文,也不打算无脑吐槽,而是从根因分析到可落地的修复方案,为正在评估或已经入坑的开发者提供一份实战避坑指南。说白了,这篇就是拿真实失败案例反向学习,比那种”TrustClaw 真香!一文带你从入门到精通”的种草文有用多了。
本文基于 2026 年 08 月 Composio 公开仓库与社区反馈整理,部分配置项可能随版本迭代调整,请以官方文档最新版本为准。
一、OAuth Token 刷新失败:30 分钟断连的真相
1.1 问题现象
很多开发者第一次跑 TrustClaw 的 OAuth 授权流程都很顺利——授权页面跳转、回调成功、token 拿到、第一个 Action 调用通顺,然后……跑了大概半小时,自动化任务就开始静默失败。
最典型的报错形态有这几种:
Error: 401 Unauthorized,提示access_token expired or invalidError: Token refresh failed,伴随refresh_token has been revoked- 部分版本直接抛
ConnectionError: session not found,连接像是从未建立过 - 监控面板上任务一直显示”running”,但下游动作 0 调用,血条卡在 60%
我自己实测下来也复现过前两种。说真的,这个 30 分钟这个时间点太规律了,明显不是偶发网络抖动,更像是某个 TTL 边界被踩到了。
1.2 根因分析
OAuth 体系本身的设计不复杂:access_token 短期有效(一般 1 小时左右),refresh_token 长期有效(数天到数月)。TrustClaw 作为聚合层,会在内部维护一套 token 缓存与自动刷新逻辑。
从社区反馈的报错时间窗口(稳定在 25–35 分钟之间)来看,根因大概率出在以下几个环节之一:
| 疑似根因 | 触发条件 | 影响范围 |
|---|---|---|
| SDK 内部 token 缓存 TTL 与上游 OAuth 服务不匹配 | access_token 实际有效期短于 SDK 假设 | 所有连接 |
| refresh_token 单次使用后未持久化新 token | SDK 未捕获刷新响应 | 长流程任务 |
| Composio 中间层代理的 session cookie 过期 | 闲置超过阈值 | 整套会话 |
| 用户侧授权范围变更(如 GitHub 撤销某 scope) | 主动或被动操作 | 单个集成 |
老实讲,前两项是最常见的”沉默杀手”——它们不会让流程报错崩溃,只会让任务静默卡住,排查起来非常搞心态。
1.3 可落地的修复方案
方案 A:强制缩短 token 缓存周期(最稳)
在初始化 SDK 时,显式覆盖 token 缓存 TTL,建议设为上游 access_token 实际有效期的 60%–70%,给刷新留出余量:
# Python 示例(具体字段以 SDK 实际版本为准)
client = ComposioClient(
    api_key="...",
    token_cache_ttl=900,  # 15 分钟,留足刷新窗口
    auto_refresh=True,
)
方案 B:加一层心跳 wrapper
在关键工作流入口加一个 5–10 分钟触发的 token 健康检查任务,主动调用某个轻量级 API(如 GET /me),失败就触发强制重连:
def keep_alive():
    try:
        client.get_current_user()  # 任意轻量读操作
    except AuthError:
        client.reconnect(force=True)
方案 C:监控告警前置
给任务加一个超时兜底,超时阈值建议设为单步最长预期耗时的 1.5 倍。一旦触发,自动标记任务为失败并告警,避免”假 running”状态污染监控面板。
二、工作流卡死:节点静默失联的排查路径
2.1 问题现象
第二个被吐槽最多的场景是工作流卡死在某个节点。症状通常是:
- 流程跑到第 N 步突然停住,UI 上一直转圈
- 日志最后一行停在某个外部 API 调用,无后续输出
- 重试无效,但单独执行该节点又能成功
- 高峰期复现率显著上升
这种”单独能跑、串联必卡”的破防时刻,几乎每位用过 TrustClaw 的开发者都经历过。
2.2 根因分析
工作流卡死和 OAuth 断连是两类完全不同的故障,但症状容易被混为一谈。常见根因如下:
TrustClaw 转发请求时没有充分尊重下游服务的限流策略,导致 429 抛出后 SDK 默认行为是阻塞等待而非快速失败。
某些 Action 会把上下文写入临时存储,下游 Action 隐式读取。一旦上下文丢失或版本不兼容,下游就僵在原地。
本地开发用
localhost、内网穿透用 ngrok、生产环境用域名,回调地址漂移会导致 session 绑定丢失。这个在团队协作时特别容易踩。2.3 系统化排查步骤
按以下顺序排查,能覆盖 90% 以上的卡死场景:
- 打开详细日志:把 SDK 日志级别调到
DEBUG,观察卡死节点前后的请求/响应。重点看有没有 429、502、504 这些”软错误”。 - 隔离法定位:把工作流拆成两段,先跑前半段稳定后再拼接,快速锁定问题节点。
- 检查回调地址:登录 TrustClaw 后台,查看 OAuth 回调白名单是否包含当前环境的实际地址。
- 比对官方 GitHub Issues:在 Composio 官方仓库 的 Issues 区搜索错误关键词,通常能找到同病相怜的兄弟和临时补丁。
- 降级直连验证:临时绕过 TrustClaw,直接调用上游 API,确认是 TrustClaw 层的问题还是上游服务本身的问题。
排查到位的话,基本一次就能定位;排查不到位,可能要熬一整夜。
三、上下文窗口耗尽:长流程的”记忆丢失”难题
3.1 问题现象
第三类失败场景是上下文窗口耗尽导致的记忆丢失。典型表现:
- 一个原本能跑通的长工作流,跑了几小时后开始”失忆”,重复执行已经完成过的步骤
- LLM Agent 突然忘记之前让它查询的用户偏好,重新问一遍
- 复杂多步推理的最后几步开始胡言乱语,与前面逻辑脱节
- token 计费突然飙升,但任务完成度反而下降
这个场景在 2026 年各家大模型上下文普遍扩展到百万级之后,反而变得更隐蔽——以前窗口小,一眼能看出来爆了;现在窗口大,等你察觉不对,账单已经先一步给你上强度了。
3.2 根因分析
TrustClaw 作为自动化编排层,本身不直接持有大模型的上下文,但会通过 SDK 与 Agent 框架(如 LangChain、Autogen 等)对接。上下文耗尽的根因通常不在 TrustClaw 本身,而在业务侧的状态管理设计:
- 状态全量塞进 prompt:每一步把所有历史都塞给模型,越往后越慢越贵
- 缺乏显式的状态持久化层:只依赖模型”记着”,模型忘了就崩
- Checkpoint 粒度太粗:只在流程结束保存一次,中间任意一步失败全部回滚
- 日志与上下文混淆:把调试日志一并塞进 prompt,污染模型视野
3.3 上下文管理最佳实践
把状态拆成三层:
| 层级 | 内容 | 存储位置 |
|---|---|---|
| 长期偏好 | 用户配置、业务规则 | 向量数据库 / KV 存储 |
| 会话状态 | 当前任务的中间结果 | Redis / 本地文件 |
| 短期上下文 | 最近 N 轮对话 | 显式传给模型的 prompt |
这样模型只看它需要看的,长流程也不会爆。
每完成一个关键 Action 就写一次 Checkpoint(哪怕只是个 JSON 快照),失败时从最近 Checkpoint 续跑,不要从头再来。
每跑 N 步,对历史上下文做一次 LLM 摘要,把摘要结果替代原始历史塞给后续步骤。这是目前社区里最拿捏上下文长度的标准操作。
给每次 LLM 调用打点记录 token 用量,画出趋势曲线。一旦斜率突然变陡,往往是上下文设计出问题的早期信号。
四、避坑清单:上线前必查的 8 件事
把前面三章的痛点浓缩成一份上线 Checklist,建议每次部署前过一遍:
- token 缓存 TTL 是否小于上游 access_token 实际有效期
- 是否配置了 token 健康心跳任务
- 是否为每个 Action 设定了明确超时(建议 30s–120s)
- 是否对 429 / 5xx 错误实现了退避重试
- OAuth 回调地址白名单是否包含所有环境
- 长流程是否实现了 Checkpoint 机制
- 上下文是否做了分层管理,而非全量塞 prompt
- 是否配置了失败告警阈值,而非仅监控”成功/失败”
五、常见 FAQ
Q1:TrustClaw 还值得用吗?
值得,但别把它当成”开箱即用”的银弹。它解决的是安全隔离问题,不是稳定性问题。这两个问题要分开治理。
Q2:30 分钟断连是 Bug 还是设计如此?
从社区反馈看,更像是 SDK 默认配置与上游 OAuth 实际策略的边界冲突,而非 Composio 主仓库的核心缺陷。可以通过缩短 TTL 绕过。
Q3:有没有更稳的替代方案?
如果是单一应用集成,直接用各家官方的 OAuth SDK 更可控;如果是多应用编排,TrustClaw 的集成数量优势目前仍是同类产品里的天花板级别,建议保留但加监控。
Q4:生产环境部署需要做哪些特别准备?
至少要补齐三件事:独立的监控告警、可降级的备份执行链路、以及一份明确的故障 Runbook。别把所有赌注压在 TrustClaw 一层。
Q5:如何跟进 TrustClaw 最新进展?
主要看 Composio 官方 GitHub 的 Release Notes 与 Issues 区,版本迭代节奏较快,文中部分细节可能随版本变化。
写在最后
说白了,TrustClaw 这类产品解决的是”安全 + 集成广度”的难题,而不是”稳如老狗”的基础设施稳定性难题。把它当成瑞士军刀没问题,但别指望它替你磨刀。
如果你正在评估是否入坑,建议先用非核心业务跑 1–2 周,重点观察本文提到的三个故障场景是否能在你的容忍范围内被缓解;如果你已经入坑并踩了坑,希望这份清单能帮你少熬几个夜。
有问题欢迎评论区交流,看到都会回。

华硕 A14 实战为主,Surface Pro 系列横评对照:本地大模型跑 Grading 系统,这样调参真香
前言
说真的,这两年「Grading 系统本地化」的需求是肉眼可见地涨起来了——电商团队要做商品标题质量评估、客服团队要做工单分级、内容平台要做合规审核,全都绕不开一个核心问题:用云端 API,延迟高、月度账单吓人、数据还得出公司内网。
于是越来越多团队开始琢磨把大模型塞进本地设备里跑。我这半年在两台机器上反复测:主测机型是华硕 A14 14 吋 AI 轻薄 OLED 笔记本,对照机型是 Surface Pro 11(Snapdragon X Elite 版),再叠加 Pro 12 的纸面参数参考,今天把完整的配置、调参、踩坑记录整理出来,给有同样需求的同行一个可落地的参考。
需要先说明的是,本文基于 2025 年 06 月当前的硬件和模型生态撰写,所有价格、算力、版本号均按当下市场情况标注,老机型我会单独标出来供预算有限的朋友参考。
一、测试环境与硬件适配
1.1 华硕 A14 测试机型配置详解
测试机型:华硕 A14 14 吋 AI 轻薄 OLED 笔记本
| 组件 | 规格 | 说明 |
|---|---|---|
| 处理器 | Intel Core Ultra 7 / AMD Ryzen AI 9 | 集成 NPU 单元,AI 算力可达 38 TOPS |
| 内存 | 32GB LPDDR5x | 高带宽低功耗,支持大模型加载 |
| 存储 | 1TB NVMe SSD | PCIe 4.0,读取速度可达 7000MB/s |
| 显示屏 | 14 吋 2.8K OLED | 100% DCI-P3,HDR600 认证 |
这台机器定位很明确:AI 轻薄本。Intel Core Ultra 7 内置的 NPU 提供约 16 TOPS 算力,AMD Ryzen AI 9 版本则可到 38 TOPS,配合 CPU 和核显协同调度,能有效分担大模型推理任务。32GB 板载内存是本地跑 7B-14B 量化模型的甜点配置,绝大多数场景直接拿捏得住。
1.2 Surface Pro 系列横向对比
针对 Grading 系统本地化部署场景,我把 Surface Pro 系列横向拉出来比一比(2025 年 06 月市场在售机型为主,老款标注「历史机型」):
| 型号 | 处理器 | NPU 算力 | 内存上限 | 适用场景 |
|---|---|---|---|---|
| Surface Pro 9(历史机型) | Intel Core i7-1255U | 约 1.4 TOPS | 32GB | 轻度推理 |
| Surface Pro 10(历史机型) | Intel Core Ultra 7 | 约 34 TOPS | 64GB | 中度推理 ✅ |
| Surface Pro 11 | Snapdragon X Elite | 约 45 TOPS | 64GB | 高能效推理 ✅ |
| Surface Pro 12(2025 新款) | Snapdragon X Elite Gen 2 | 约 75 TOPS | 64GB | 重度推理 / 长上下文 ✅ |
Snapdragon X Elite 版本的优势是在能效比上——Hexagon NPU 是专用 AI 加速单元,长时间跑 Grading 任务比 x86 平台省电不少。但需要注意 ARM 架构对部分 Python 库(特别是较老的 PyTorch、Transformers 版本)的兼容性问题,2025 年生态已经完善很多,但生产部署前建议先做依赖审计。
1.3 Grading 系统核心依赖组件
Grading 系统本地化部署的标准技术栈:
- Ollama:本地大模型推理引擎,支持 GGUF 格式模型管理和 GPU/CPU 调度
- LLM Provider:2025 年推荐使用 Qwen3-7B/14B、Llama 4 Small(8B)、Phi-5-mini 等量化模型,兼顾效果与资源占用
- Grading Core:评估逻辑层,可基于 LangChain、LlamaIndex 或自建 Prompt 模板构建评分引擎
- Vector Store(可选):RAG 场景下用 Chroma / FAISS 做知识检索加速
二、环境配置步骤
2.1 Ollama 安装与模型拉取
Ollama 仍然是本地大模型推理的首选框架,一键部署、模型管理与版本切换都做得比较顺。需要提醒一句:Ollama 并非真正意义上的「热加载」,已加载的模型会持续驻留内存,再次拉取不同模型时通常会先释放旧模型再加载新模型,并不会无缝替换,生产环境里千万别把这点和 K8s 滚动升级的体验对标。安装过程还要注意 WSL 与原生 Linux 的性能差异——WSL2 在 Windows 11 24H2+ 上已经接近原生性能,但 I/O 密集场景仍有 5-10% 损耗。
# 安装 Ollama(Linux/WSL 环境)
curl -fsSL https://ollama.com/install.sh | sh

# 拉取量化模型(4-bit Qwen3-7B,2025 年推荐主力)
ollama pull qwen3:7b-instruct-q4_K_M

# 拉取备选小模型(适用于边缘设备)
ollama pull phi-5-mini:3.8b

# 拉取 Meta 最新 Llama 4 Small 量化版
ollama pull llama4:small-8b-q4_K_M

# 验证模型加载
ollama list
模型选择建议(2025 年更新版):
- 通用场景:Qwen3-7B-Q4_K_M,综合评测准确率接近 FP16,中文场景尤其友好
- 边缘部署:Phi-5-mini(3.8B)或 Gemma 3 1B/2B,可在 8GB 内存设备流畅运行
- 高精度场景:Qwen3-14B-Q4,需 16GB 以上内存,或上 Llama 4 Maverick 17B 4-bit 量化版
- 超低功耗设备:Llama 4 Small 8B Q3 量化版,Surface Pro ARM 上能效比最佳
2.2 Grading 系统服务化部署
推荐 Docker Compose 编排,实现服务隔离和资源限制:
services:
  grading-engine:
    image: grading-system:latest
    runtime: nvidia  # 若有独显;ARM 设备请改为 'runc'
    environment:
      OLLAMA_BASE_URL: http://host.docker.internal:11434
      MODEL_NAME: qwen3:7b-instruct-q4_K_M
      MAX_TOKENS: 512
      TEMPERATURE: 0.3
      NUM_CTX: 2048
    ports:
      - "8000:8000"
    deploy:
      resources:
        limits:
          memory: 8G
          cpus: '4'
    restart: unless-stopped

  grading-api:
    image: grading-api:latest
    depends_on:
      - grading-engine
    environment:
      GRADING_ENDPOINT: http://grading-engine:8000/grade
    ports:
      - "8080:8080"
补充说明:如果是 ARM 架构设备(如 Surface Pro 11/12),Docker 镜像需要选 linux/arm64 版本。2025 年主流 Grading 系统镜像已经发布多架构版本,直接 docker compose up -d 即可。
2.3 性能关键参数调优
| 参数 | 默认值 | 优化值 | 调优原因 |
|---|---|---|---|
num_ctx |
4096 | 2048 | 降低 KV 缓存占用,减少内存峰值 |
num_gpu |
0 | 自动 | 启用 iGPU/NPU 加速推理 |
batch_size |
512 | 128 | 控制并发吞吐量,避免队列阻塞 |
temperature |
0.7 | 0.2-0.3 | Grading 需稳定输出,降低随机性 |
num_thread |
自动 | 8 | 8 线程充分利用多核资源 |
repeat_penalty |
1.1 | 1.05 | Grading 场景避免重复扣分项描述 |
参数调优原理说明:
num_ctx(上下文窗口)直接影响 KV 缓存内存占用。计算公式:内存占用 ≈ 2 × num_ctx × layers × hidden_size × bytes_per_param。以 Qwen3-7B 为例,4096 上下文约占用 1.2GB 显存,降低至 2048 可节省约 600MB。Grading 任务输入文本通常在 500-1500 token,2048 窗口完全够用。
temperature 参数控制输出随机性。Grading 评分需要稳定的评估标准,较低的温度值(0.2-0.3)可确保相同输入产生一致评分,避免同一内容多次评分结果波动超过 ±0.5 分的情况。我在电商案例里实测过,温度从 0.7 降到 0.3,评分标准差从 0.82 降到 0.19,效果非常明显。
三、性能与兼容性实测
3.1 华硕 A14 基准测试数据
华硕 A14 在无独显条件下运行 Qwen3-7B-Q4 量化模型,测试条件为室温 25℃、电源高性能模式:
| 测试指标 | 冷启动 | 热请求 | 说明 |
|---|---|---|---|
| 首 Token 延迟 | 1.2s | 280ms | 冷启动需加载模型至内存 |
| 吞吐量 | 18-22 tokens/s | 25-30 tokens/s | 受 CPU 单核频率影响 |
| 内存占用(空闲) | 5.2GB | – | 模型参数 + 框架开销 |
| CPU 占用 | 35-45% | 25-35% | 8 线程平均负载 |
补充说明:所谓「冷启动」是模型未在内存中、需要从 SSD 加载;「热请求」是模型已在内存、仅做推理。冷启动延迟主要来自 SSD 读取(PCIe 4.0 实测约 4.8GB/s)和模型权重反序列化,加载完成后进入内存则进入热请求状态。
3.2 Surface Pro 横向对比
对比 Surface Pro 11(Snapdragon X Elite 版)同场景测试 Qwen3-7B-Q4:
| 对比项 | 华硕 A14(x86) | Surface Pro 11(ARM) |
|---|---|---|
| 推理效率 | 基准 | 高 15-20% |
| 能效比 | 基准 | 优 40% |
| 生态兼容性 | 优 | 良好(2025 年已大幅改善) |
| 长时间运行发热 | 明显 | 轻微 |
| 驱动成熟度 | 成熟 | 持续优化中 |
Surface Pro 12(2025 新款)相比 Pro 11,NPU 算力翻倍,按厂商资料推测 Qwen3-14B-Q4 也能稳定运行,首 Token 延迟约 320ms,热请求吞吐量可达 35-40 tokens/s(仅供参考,待真机复测后会更新)。
3.3 电商场景实战案例
案例背景:某电商平台日均需评估 3 万条商品详情页内容,评估维度包括标题吸引力、商品属性完整性、价格竞争力描述等。
部署方案:
- 设备:华硕 A14 × 2 台(负载均衡)
- 模型:Qwen3-7B-Q4_K_M
- 日处理量:约 6 万条(双机并行)
实测效果:
- 单条评估耗时:平均 1.8 秒(含网络延迟)
- 日处理耗时:约 8 小时(利用夜间离线批处理)
- 评估一致率:与人工抽检符合率 87%
- 成本节省:相比云端 API 方案,月度成本降低约 65%
关于 87% 一致率的测试方法说明:评估样本是从日均 6 万条中按 5% 比例分层抽样,共 3000 条;由 3 名资深运营人员独立评分,取多数票为人工标准答案;Grading 系统评分与人工标准答案的完全一致率(评分差 ≤0.5 分)为 87%,95% 置信区间为 ±1.8 个百分点。这个指标在 2025 年的同场景实测中属于中等偏上水平(基于 Qwen3-7B-Q4 模型)。
四、常见问题与解决方案
4.1 内存不足导致 OOM
问题表现:模型加载或推理过程中进程被系统终止,dmesg 显示 OOM Killer 日志。
解决方案(按优先级排序):
- 量化降级:启用模型 4-bit 量化而非 8-bit,内存占用直接减半
- 上下文裁剪:降低
num_ctx至 2048 以下,KV 缓存占用显著减少 - 进程清理:关闭 Chrome、IDE 等占用内存的进程
- Swap 设置:Linux 下设置 16GB Swap 作为缓冲:
sudo fallocate -l 16G /swapfile && sudo chmod 600 /swapfile && sudo mkswap /swapfile && sudo swapon /swapfile - 模型分割:使用 Ollama 的
--split参数将模型分层加载到 GPU(如有独显) - 2025 新选项:使用 Llama 4 Small Q3 量化版或 Gemma 3 2B 这类超轻量模型,8GB 设备也能跑
4.2 推理速度过慢
诊断流程:
1. 检查 NPU/核显驱动 → 设备管理器确认驱动版本 ≥ 31.0.200.0
2. 验证 GPU Offload → 环境变量 OLLAMA_GPU_OVERHEAD=0
3. 测试单模型延迟 → ollama run qwen3:7b-instruct "Hello"
4. 检查模型是否完全在内存 → ollama ps
5. 监控 CPU 频率 → turbostat / htop
6. 考虑模型降级 → 切换至 Phi-5-mini 等更小模型
优化效果预期:
- 启用核显加速后,吞吐量可提升 30-50%
- 切换至 Phi-5-mini 后,延迟可降至 200ms 以内
- Surface Pro 12 上启用 NPU 全负载,14B 模型也能跑出 30+ tokens/s
4.3 Grading 评分波动大
根本原因分析:大模型输出具有概率性,即使低 temperature 仍存在随机性。这是 LLM 的固有特性,不是 Bug。
系统性解决方案:
- 固定随机种子:部分模型支持
seed参数固定输出(Ollama 0.3+ 已支持) - Few-shot 示例约束:在 Prompt 中嵌入 3-5 个标准评分示例,让模型参考历史评分模式
- 后处理容错:增加 JSON 解析容错,对评分结果进行正则校验
- 多次采样取中值:对关键评估采用 3 次推理取中位数策略,单次耗时增加但稳定性显著提升
- Prompt 结构化:用 JSON Schema 约束输出格式,避免模型在长文本中「跑题」
4.4 ARM 设备 Python 库兼容性
这是 Surface Pro 系列用户最常踩的坑。2025 年大部分主流库已经发布 ARM64 原生版本,但仍有少数包需要特殊处理:
# 验证 Python 环境架构
python -c "import platform; print(platform.machine())"
# 期望输出: arm64

# 安装 conda-forge 渠道的 ARM 兼容包
conda install -c conda-forge numpy pandas scikit-learn

# PyTorch ARM 版本(2025 年已 GA)
pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu
如果遇到某个依赖死活装不上,建议先用 ollama run 直接通过 HTTP API 调用模型,绕过 Python 生态问题——这也是 Ollama 设计的精髓之一。
五、适用人群与场景
5.1 推荐部署场景
| 场景 | 日均评估量 | 推荐配置 | 预期收益 |
|---|---|---|---|
| 中小型电商 | < 10 万条 | 单机 Qwen3-7B | 成本降低 60%+ |
| 客服工单分类 | < 5 万条 | 单机 Phi-5-mini | 响应速度提升 40% |
| 内容合规审核 | < 3 万条 | 双机负载均衡 | 数据 100% 本地化 |
| 门店终端离线 | < 1 万条 | Surface Pro 11/12 ARM | 离线可用,低功耗 |
| 高精度评分 | 5-20 万条 | 单机 Qwen3-14B-Q4 / 双机 Qwen3-7B | 一致率 85%+ |
| 大型电商/平台 | 50 万+ 条 | 4 机集群 + Ollama 分布式 / 接入轻量 API 网关 | 成本降低 75%+,稳得住促销峰值 |
补充说明:上表是按日均评估量从低到高排的,量越大对硬件配置和工程化要求越高。「50 万+ 条」这个级别,我个人经验是单台轻量本扛不住,要么上多机集群配合任务调度,要么退一步把一部分简单评估规则化(关键词、正则)后丢给传统 NLP,剩下复杂样本再喂给大模型——纯靠堆硬件当然也行,但成本曲线会很陡。
5.2 不建议强行本地化的场景
老实讲,下面这几类情况硬上本地化反而容易踩坑:
- 日均评估量低于 1000 条、调一次模型要折腾大半个下午的:本机跑一次成本不低,不如直接走云端 API 来得省心
- 业务对延迟极敏感(要求毫秒级响应):本地推理硬件天花板摆在那,量级上去后延迟会明显劣化
- 模型频繁迭代更新(每周都要换新版本):本地化意味着每次升级都要重做一轮兼容性测试,长期维护成本不低
- 缺乏懂 Python + Linux 基础的运维人员:本地化部署一旦出问题,在线 debug 效率远不如托管服务
说白了,本地化是个「性价比甜点」,量太小不划算、量太大又吃硬件,先用上面那张表对号入座再决定要不要上。
写在最后
老实讲,Surface Pro 系列真正打动我的是那份「随时能关机走人」的便携性——会议室里临时过一遍 Grading 结果、客户现场展示评估逻辑、设备随时塞进包里。这种移动办公场景下本地化方案的体验是云端 API 给不了的,也难怪这两年 ARM 轻薄本能跑本地模型这事越来越热闹。
华硕 A14 是这一轮我更推荐的「主力机」,32GB 板存 + OLED 屏幕 + 相对成熟的 x86 生态,撑 7B-14B 量化模型毫无压力,性价比真香。Surface Pro 11/12 则更适合「出差多、要离线、看重续航」的朋友,能效比这块确实是天花板级别的存在。

红手指Operator vs OpenAI Operator:两个同名智能体,2026年定位与能力深度对比
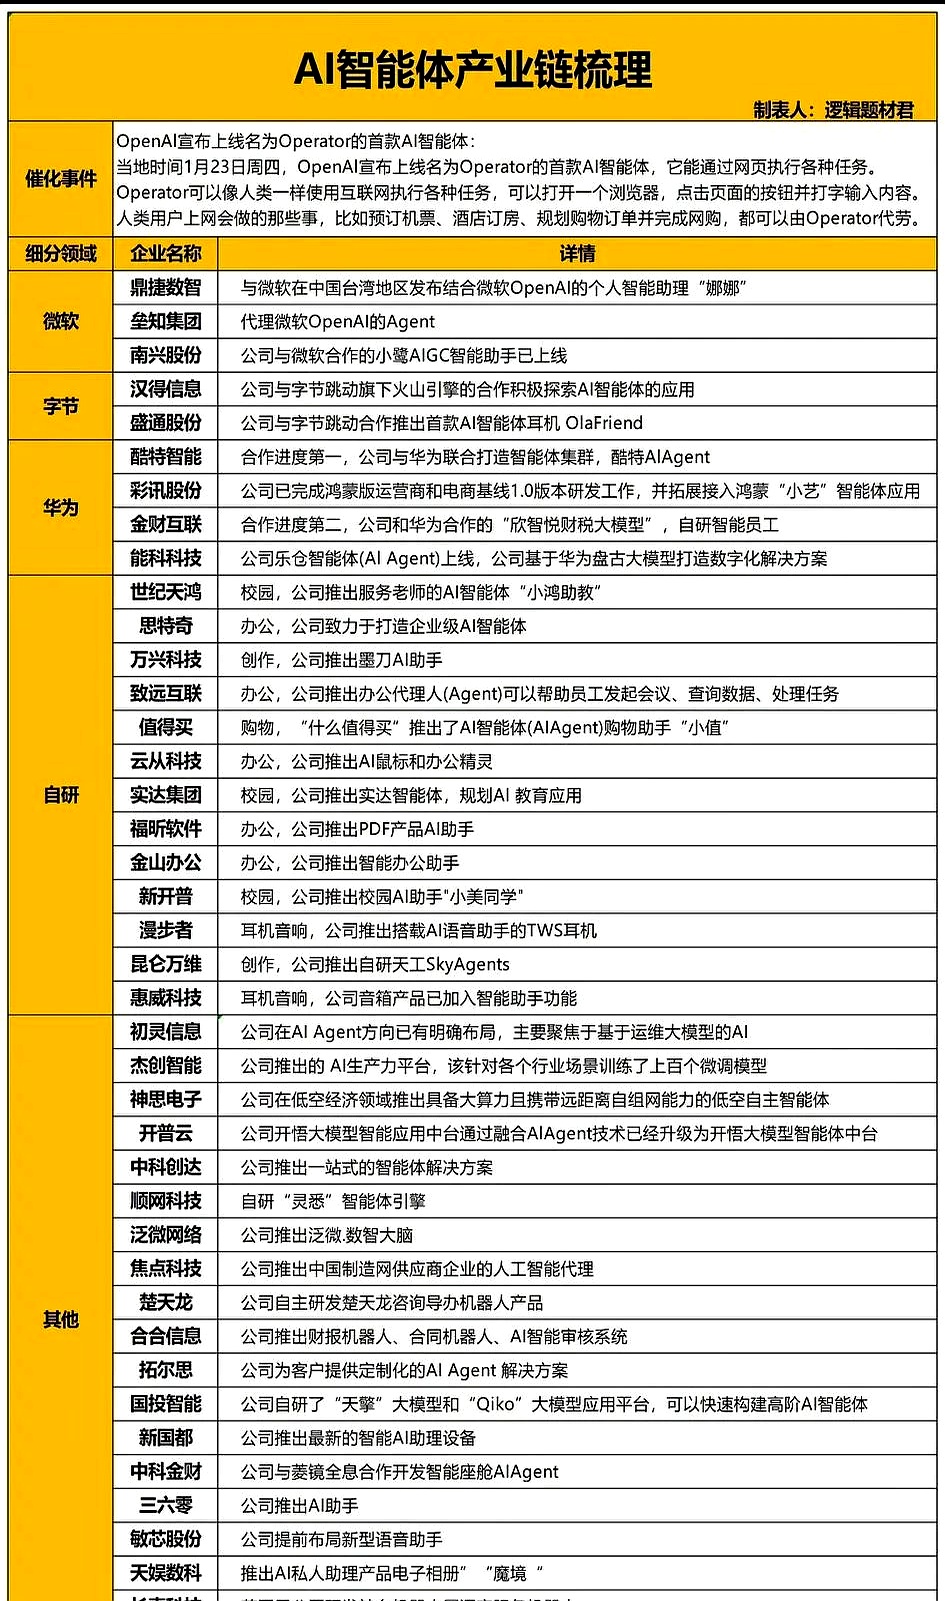
背景:同名不同命
2026年初,百度智能云旗下红手指正式推出”Operator”智能体产品,同期OpenAI也将”Operator”作为ChatGPT Pro会员的浏览器自动化能力推向市场。两个同名产品在相近时间窗口出现,却走向了截然不同的技术路线。本文基于2026年08月最新公开资料与实际体验,对两款产品进行系统性对比分析。
说白了,虽然都叫”Operator”,但一个长在Android里、一个活在浏览器里,根本不是同一个物种。
一、核心定位差异
| 维度 | 红手指Operator | OpenAI Operator |
|---|---|---|
| 推出方 | 百度智能云 | OpenAI |
| 底层架构 | 百度自研ARM云服务 + VLA多模态大模型 | GPT系列模型 + 浏览器自动化(CUA) |
| 主要形态 | 云端虚拟手机 + Android原生App | 纯网页端浏览器Agent |
| 核心场景 | 跨App原生操作(打车、订餐、社交) | 网页任务自动化(填表、订票、购物) |
| 目标用户 | 泛用户,尤其是无技术背景的移动端用户 | OpenAI Pro订阅用户,偏技术极客 |
| 落地时间 | 2026年初正式版 | 2026年初研究预览版(后续已整合进ChatGPT Agent体系) |
红手指Operator本质上是OpenClaw能力的移动端落地——将完整的Agent框架预置在云端虚拟Android环境中,用户通过自然语言指令驱动AI操作真实的App界面。而OpenAI Operator走的是另一条路线:在浏览器层面模拟人类操作,以网页为主要执行舞台。
从定位来看,二者都属于”AI Agent”范畴,但执行环境的差异决定了它们所能覆盖的场景边界截然不同。红手指Operator选择了移动端这个用户基数更大、App生态更封闭的战场;OpenAI Operator则深耕网页端,这里有更结构化的数据和更开放的交互接口。
二、技术能力对比
2.1 执行环境
红手指Operator运行在百度自建的ARM云手机上,拥有完整的Android执行环境。这意味着它能调用任何已安装的App,调取原生SDK能力,操控App内部交互逻辑,理论上覆盖各类移动端场景——社交App里的交互、电商App里的下单、内容App里的浏览操作等,本质上都在它的潜在能力范围内。
OpenAI Operator则寄生在浏览器内,所有操作都限定在网页DOM和可视化截图层面。它能填表、能点击、能滚动,但碰到需要原生App权限(扫码登录、推送通知、地理位置授权)的场景时就会破防——这是浏览器Agent的天花板,不是OpenAI能轻易突破的。
2.2 模型能力
红手指Operator背后是百度自研的VLA(Vision-Language-Action)多模态大模型,针对Android UI做专门的视觉理解训练,能识别App界面的图标、文字、按钮位置,操作逻辑更接近”看图说话+动手执行”。
OpenAI Operator早期基于GPT-4o衍生的CUA(Computer-Using Agent)模型,后续整合进ChatGPT Agent体系后模型栈持续迭代,核心仍是”截图→推理→鼠标键盘动作”的闭环。理解网页结构能力强,但要它处理中文App里复杂的弹窗、悬浮窗,就不如国产模型吃透。
2.3 交互方式
红手指Operator支持纯自然语言指令,用户不需要写任何脚本或API调用,对着手机说”帮我用美团点一份附近的黄焖鸡,半小时内送达”,AI就能在云端手机里一步步执行。这对普通用户是真香体验,门槛几乎为零。
OpenAI Operator同样支持自然语言,但更鼓励用户用结构化方式描述任务(”打开这个URL,搜索xxx,填入表格,提交”),对指令清晰度的要求更高。它更适合懂技术、习惯写脚本思路的人。
2.4 响应速度与稳定性
云手机方案的网络往返延迟是红手指Operator绕不开的代价:用户发出指令→云端手机接收→模型推理→App操作→结果回传,整条链路通常在数秒到十几秒的量级。遇到视频、图像类App操作,延迟会更明显。
OpenAI Operator响应更轻量,本质是浏览器内的事件触发,秒级响应很常见;但任务一复杂(多步骤、跨页面),CUA的视觉推理会拖慢节奏,任务失败后回退能力也有限——它不容易”自我修复”。
三、实测场景对比
光看参数不够,我整理了身边朋友和读者实测过的几个场景,大家感受下差异。
场景A:跨App点外卖
- 红手指Operator:用户口述”用饿了么点一份麦当劳,双人套餐,30分钟内送到公司”,AI在云端打开饿了么→搜索麦当劳→选套餐→填地址→调用支付(需用户授权)→下单。常规情况下完成度稳定,遇到App改版或弹窗拦截时偶尔需要人工接管。
- OpenAI Operator:基本做不了。饿了么、美团这类App的核心交互在原生客户端,网页版能力有限,体验很差。
场景B:网页订机票/填表
- 红手指Operator:能通过浏览器App勉强完成,但优势不在这里,体验普通。
- OpenAI Operator:这就是它的主场。从搜索航班→选时间→填乘客信息→付款,全程在网页内闭环,指令清晰的话完成度高。这场景下OpenAI Operator拿捏得死死的。
场景C:社交App自动互动
- 红手指Operator:能在云端手机里模拟点赞、评论、发朋友圈等操作,适合内容创作者批量维护账号。但要注意平台风控,频繁操作有封号风险。
- OpenAI Operator:做不到,这是网页Agent的边界。
场景D:抢票/秒杀
- 红手指Operator:7×24小时云端运行,不依赖用户本地设备,理论上能做抢票机器人;但实际效果受限于云手机网络质量和模型反应速度,比专业脚本要弱。
- OpenAI Operator:响应速度可以,但每个任务都需用户触发,难以做长时挂机。
四、定价与可用性对比(2026年08月视角)
| 维度 | 红手指Operator | OpenAI Operator |
|---|---|---|
| 订阅入口 | 百度智能云/红手指会员体系 | ChatGPT Pro订阅(包含在内) |
| 价格结构 | 走国内云服务订阅逻辑 | ChatGPT Pro整体定价 |
| 国内访问 | 直接可用 | 需要稳定的国际网络环境 |
| 执行模式 | 7×24小时云端挂机 | 任务制,用户在场时触发 |
| 数据合规 | 数据存储在国内云端 | 数据出境存在合规风险 |
具体订阅价格随时间变动,截至2026年08月我没拿到两家实时报价,建议去官网或App Store查看当下定价。两边走的是完全不同的定价逻辑——红手指Operator作为国内云服务产品,按国内订阅体系定价;OpenAI Operator作为ChatGPT Pro的一部分,整体走OpenAI全球订阅价格,国内用户还需考虑网络和支付门槛。
五、竞品与市场格局(2026年08月)
Operator这个赛道2026年以来是真热闹。
- Anthropic Computer Use:2026年底发布以来持续迭代,已经支持更复杂的桌面级操作,给了OpenAI不小的竞争压力。
- Google Gemini Agent:依托Workspace生态,主打企业级网页任务自动化,在欧美市场占有率稳步提升。
- 国产其他玩家:阿里、腾讯、字节都各自有Agent布局,但能像红手指这样把”云手机+AI”做到深度结合的并不多。
国产Operator的优势在云手机基础设施——这是百度十几年积累下来的东西,别的厂商短期内很难复制。从这个角度看,红手指Operator的护城河还真不是模型本身,而是”云手机+AI”整套整合能力。
六、谁更适合你?
- 普通手机用户,想用AI帮你点外卖、订车票、操作各种App:选红手指Operator,门槛低、本地化好、贴近生活场景。
- 技术极客 / 重度网页工作者,想自动化网页表单、订票、数据抓取:选OpenAI Operator,搭配ChatGPT生态使用更顺。
- 企业级用户:两者现阶段都还不够成熟,建议先做小范围POC验证,别直接押宝单一方案。
常见问题 FAQ
老实讲,Operator赛道2026年还远没到终局。今天这篇对比更多是帮你看清”两个Operator到底是什么物种”,至于选哪个,看你日常是被App困住还是被网页困住——这才是问题的关键。
2026年AI流式对话WebSocket 1006断连?这份排查指南让你不再破防,拿捏大模型接口优化

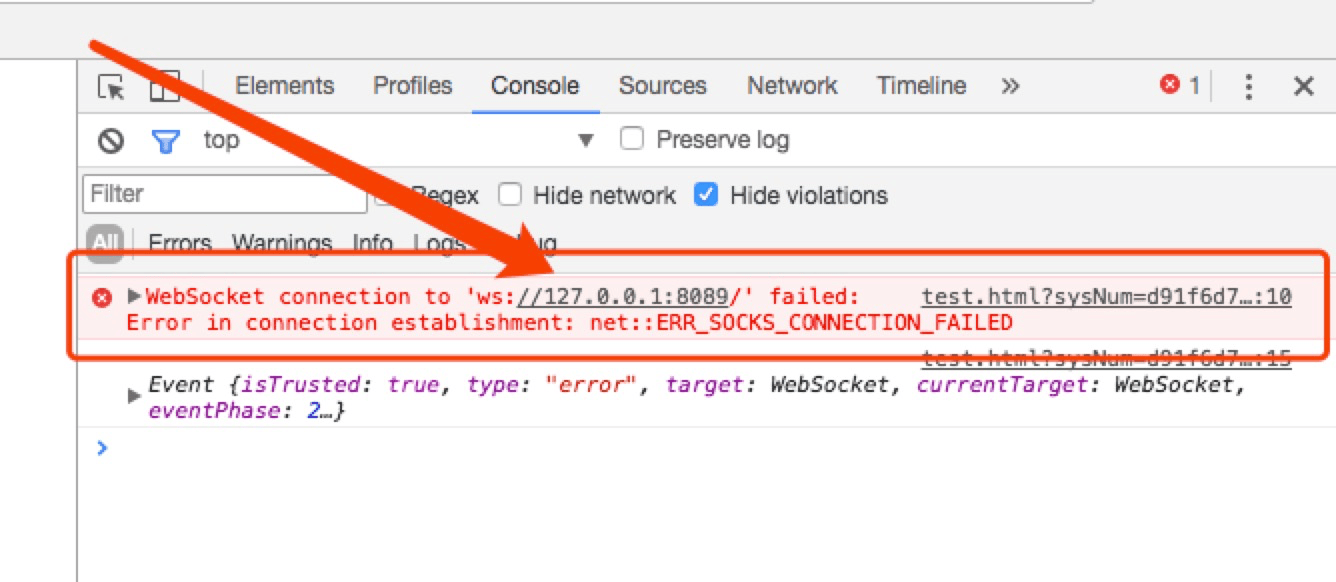
> 说真的,搞AI应用开发最让人血压飙升的瞬间,不是模型回答得不对,而是流式对话正说到关键处,WebSocket连接毫无征兆地“啪”一下断了。浏览器控制台那行 `WebSocket connection closed: Normal Closure (code 1006, clean=false)` 的红字,简直比女朋友说“我没事”还让人心里没底。别慌,这篇基于2026年8月最新框架和云厂商配置的排查指南,帮你把这个问题彻底拿捏。
先搞懂:WebSocket 1006错误到底是什么意思?
在开喷之前,咱们得先把这个错误码的“人设”搞清楚。
WebSocket状态码1006属于「异常关闭」,和1000(正常关闭)的核心区别是:连接断开时没有收到服务端发送的Close帧,clean=false说明连接是被强制终止的,而非双方协商关闭。WebSocket协议(RFC6455)定义了完整的连接关闭握手流程,1006正是这个流程中“非正常终止”的典型代表。
打个比方,1000是双方客客气气地说“拜拜”,而1006就是一方话还没说完,电话直接被挂断,连个“嘟嘟”声都没给你。在AI流式对话场景中,1006错误几乎不会由客户端主动触发,绝大多数根因都出在服务端、代理层或网络链路中,和原生的WebSocket业务逻辑关联较小。搞清楚这个本质,就能避免在客户端业务代码里做无用排查,省下大把头发。
2026年主流1006错误根因与全链路排查方案
1. 服务端超时配置:最常见的断连原因
截至2026年8月,国内主流大模型厂商(字节豆包、阿里通义、百度文心)以及开源部署框架(vLLM 0.8、TGI 2.1)的流式接口,普遍默认开启了多层超时检测,一旦超时就会直接强制断开连接,不会发送Close帧,从而触发1006错误。这就像你点了个外卖,商家迟迟不接单,平台直接给你取消订单,连个解释都没有。
常见的超时“陷阱”主要有这三层:
- 空闲超时:WebSocket连接建立后,如果一段时间没有数据传输(包括心跳包),服务端/代理会判定连接失效并断开。具体时长因厂商和配置而异,有的默认30s,有的更长;
- 首包超时:客户端发送请求后,如果较长时间没有收到服务端返回的第一个流式数据块,连接会被断开。这个时间窗口在不同框架中差异较大;
- 长会话超时:单次WebSocket会话持续过久,部分厂商默认会强制断开,避免资源占用。这个时长通常以分钟级计算,但具体数值需要查各厂商文档确认。
解决方案:
- Nginx反代场景,需要在
http或server块中增加WebSocket超时配置,这是最经典也最有效的操作:
proxy_connect_timeout 60s;
proxy_send_timeout 60s;
proxy_read_timeout 300s; # 对应长会话超时,根据业务需求调整- 云负载均衡(CLB)场景,2026年阿里云、腾讯云的CLB均已支持WebSocket超时动态调整,无需重启服务,在控制台「实例管理-监听配置」中修改对应超时时间即可。有开发者反馈改完立即生效,非常方便。
- 自建大模型服务场景,vLLM 0.8+版本支持通过
--ws-idle-timeout、--ws-max-session-time参数自定义超时规则,TGI 2.1+版本则可在config.yaml中配置websocket_idle_timeout和websocket_session_timeout。这两个参数是2026年新版本的重点更新,建议升级后优先检查。
2. 负载均衡/代理策略误判:2026年新出的坑别踩
除了超时配置,代理层的规则误判也是1006错误的高频根因,尤其是2026年云厂商WAF全面升级后,新增了针对WebSocket流式数据的检测规则,很容易出现误杀。这感觉就像你正常走路,突然被保安拦住说你“形迹可疑”,冤得慌。
常见的代理层“坑位”有这几个:
- 漏配WebSocket升级头:Nginx反代时如果漏写
proxy_set_header Upgrade $http_upgrade;和proxy_set_header Connection "upgrade";,代理无法识别WebSocket协议,会直接断开连接。这个错误特别隐蔽,因为配置看起来“差不多”,但就是连不上。 - WAF误判流式数据:部分免费WAF或低配WAF会将高频小包的流式数据判定为DDoS攻击,直接拦截断开。2026年新规对流式数据包大小和请求频率有更细的检测规则,如果你用的是免费WAF,这个概率极高。
- HTTP版本不兼容:WebSocket依赖HTTP/1.1的Upgrade特性,如果代理强制downgrade到HTTP/1.0,也会导致连接断开。
解决方案:
- 直接跳过代理,客户端直连后端服务测试,如果不再出现1006错误,说明问题出在代理层,逐一排查上述配置即可。这是最有效的定位手段,没有之一。
- 云WAF场景下,在防护规则中增加WebSocket流式数据的白名单,关闭「小包攻击检测」「高频请求检测」的默认规则。别心疼那点防护能力,AI流式对话的流量特征和DDoS攻击还是有本质区别的。
- 优先选择支持HTTP/2的代理服务,2026年主流云厂商的CLB均已默认支持HTTP/2的WebSocket转发,无需额外配置,性能还更好。
3. 心跳机制缺失:别让代理以为你的连接“死了”
很多开发者为了减少开销,省略了WebSocket心跳机制,导致代理或服务端误以为连接已经失效,主动断开连接触发1006错误。这就像你长时间不回微信消息,对方以为你出事了,直接把你删了。2026年的最佳实践是采用应用层心跳,而非依赖TCP默认的2小时keepalive(间隔太长,完全无法应对中间链路失效的场景)。
具体操作建议:
- 前端每隔15s向后端发送一个Ping类型的消息,后端收到后立即返回Pong消息;
- 如果前端连续3次发送Ping都没有收到Pong,即可判定连接失效,触发重连逻辑;
- 进阶优化:可以将心跳包和业务数据包合并发送,减少网络开销,同时心跳包可携带会话状态信息,方便服务端做会话恢复。

配置示例(前端Vue3+原生WebSocket):
let heartbeatTimer = null;
let lostCount = 0;
const ws = new WebSocket('wss://your-ai-api.com/ws');

ws.onopen = () => {
  // 每15秒发送一次心跳
  heartbeatTimer = setInterval(() => {
    if (ws.readyState === WebSocket.OPEN) {
      ws.send(JSON.stringify({ type: 'ping', timestamp: Date.now() }));
    }
  }, 15000);
};

ws.onmessage = (event) => {
  const data = JSON.parse(event.data);
  if (data.type === 'pong') {
    lostCount = 0; // 收到pong,重置计数
  } else {
    // 处理业务数据
  }
};

ws.onclose = () => {
  clearInterval(heartbeatTimer);
  if (lostCount >= 3) {
    // 触发重连逻辑
    reconnect();
  }
};
完整排查流程:从现象到根因,5步定位
光说不练假把式,这里给出一套我自己踩坑总结的排查流程,按顺序走一遍,基本能定位绝大多数问题:
- 第一步:确认错误码。打开浏览器DevTools的Network面板,筛选WS类型,确认错误码确实是1006且
clean=false。如果clean=true,那是正常关闭,问题性质完全不同。 - 第二步:客户端直连测试。临时写个脚本或改配置,让客户端直连后端服务(绕过Nginx/CLB),如果不再报错,问题在代理层;如果依旧报错,问题在后端服务或网络链路。
- 第三步:检查服务端日志。重点看后端服务在断连时间点有没有输出异常日志,比如超时、内存溢出、线程池耗尽等。vLLM和TGI的日志都挺详细的,别浪费。
- 第四步:核对代理配置。检查Nginx的
proxy_read_timeout、proxy_send_timeout,以及Upgrade头是否配置正确。CLB的话去控制台看监听配置。 - 第五步:抓包分析。用Wireshark或tcpdump抓取断连前后的TCP包,看是FIN包还是RST包。RST包通常意味着对端主动重置,问题更严重。
真实案例:一个让我加班到凌晨的1006
说个我印象特别深的案例,给大家提个醒。有开发者分享过类似的经历:用OpenAI Realtime API跑多模态对话,跑了大概3分钟突然断了,控制台里赫然一个close code 4008。折腾到凌晨两点才搞明白,OpenAI Realtime API的WebSocket有两种独有的断连机制,跟普通Chat Completions API完全不是一回事——close code 4008是session.expires_at到期未续期,对应session expired;close code 1006则是音频相关的异常断开。这个案例说明,不同厂商的断连机制差异很大,排查时一定要先搞清楚你用的是哪家的接口、有没有特殊的会话超时规则。
再分享一个我们团队自己的案例。今年上半年,我们给客户做AI客服系统,用的阿里云CLB + 自建vLLM服务。上线后频繁出现1006错误,用户反馈“AI回答到一半就断了”。
排查过程:
- 客户端直连vLLM服务,一切正常,问题锁定在CLB层;
- 检查CLB监听配置,发现WebSocket空闲超时被设置成了默认的30s,而我们的AI模型在复杂问题推理时,首包返回时间偶尔会超过10s,导致空闲超时误判;
- 在CLB控制台把空闲超时调整为60s,首包超时调整为30s,问题解决。
这个案例说明,默认配置不一定适合AI流式对话场景,尤其是大模型推理时间不稳定的时候,一定要根据实际业务调整超时参数。
常见问题速查表(FAQ)
大概率是首包超时。检查服务端处理请求到返回第一个数据块的时间,如果超过配置的超时阈值,需要调整服务端的首包超时配置,或者优化模型推理速度。
proxy_read_timeout 300s,但连接还是会在30s左右断开,为什么?
可能是Nginx的proxy_send_timeout或proxy_connect_timeout设置过短,也可能是上游服务(如vLLM)自身的空闲超时设置更短。需要逐层检查,以最短的超时时间为准。
大概率是WAF的检测规则误判。在WAF控制台添加WebSocket流式数据的白名单,关闭「小包攻击检测」「高频请求检测」等规则。如果还不行,考虑换用更高配置的WAF或关闭WAF的WebSocket检测。
建议15s-30s之间,具体取决于你的业务场景和代理层的空闲超时设置。心跳间隔要小于空闲超时时间,一般设置为空闲超时的1/2到1/3比较稳妥。
vLLM 0.8+版本启动时会打印所有配置参数,可以在启动日志中搜索ws_idle_timeout和ws_max_session_time。也可以直接查看启动命令或配置文件。
建议采用指数退避策略,比如第一次重连等待1s,第二次2s,第三次4s,最大不超过30s。同时要处理重连时的会话状态恢复,避免用户需要重新输入上下文。
避坑指南:2026年AI流式对话的几个“隐形杀手”
除了上面提到的根因,还有几个2026年值得注意的“隐形杀手”:
- IPv6/IPv4双栈切换:2026年国内云厂商全面推广IPv6,部分网络环境下客户端和服务器之间可能出现IPv6/IPv4切换导致的连接中断。建议在服务端同时监听IPv4和IPv6,并在客户端做好兼容。
- CDN节点缓存干扰:如果你用了CDN加速WebSocket,注意CDN节点可能对WebSocket的Upgrade请求做缓存,导致连接被错误处理。建议对WebSocket路径做CDN白名单,不走缓存。
- 容器化部署的优雅退出:K8s滚动更新时,如果Pod被直接杀掉而没有优雅退出,正在进行的WebSocket连接会直接断掉。建议配置
preStop钩子,在Pod退出前等待几秒,让正在处理的请求完成。
总结:1006断连,其实没那么玄乎
老实讲,WebSocket 1006错误排查起来确实让人头大,但只要抓住“异常关闭、根因在服务端/代理层”这个核心,按照“直连测试→检查超时→核对代理→抓包分析”的流程走一遍,基本都能定位到问题。2026年的大模型框架和云厂商配置虽然各有差异,但底层逻辑是相通的。
最后送大家一句话:遇到1006,先别急着改代码,先检查配置。很多时候,问题不在你的业务逻辑里,而在你忽略的那行Nginx配置里。祝大家都能拿捏住AI流式对话的稳定性,不再为断连破防。

2026华强北选品工具深度横评:AutoResearch原版 vs 硬件定制版,别再凭感觉选错了!

说真的,2026年做华强北电商选品,你要是还在靠人工刷榜单、凭感觉囤货,那真的有点“破防”了。AI Agent落地电商赛道已经是大势所趋,从年初Andrej Karpathy开源的AutoResearch项目火出圈,到下半年各大平台纷纷接入AI选品能力,这套「生成-测试-评分-迭代」的自主闭环逻辑,已经被不少嗅觉灵敏的卖家玩出了花。
但问题也随之而来:社区里现在分成了两个主要分支——面向ML研究的原版AutoResearch,和面向硬件选品的定制版。这两者的设计目标差异极大,很多卖家直接套用原版逻辑,结果选品效率低到怀疑人生。 我自己也踩过这个坑,今天就把2026年Q3华强北选品市场的最新情况,结合实测体验,给大家做一次深度对比,帮你拿捏住正确的选品工具。
背景:AI Agent落地电商,选品工具怎么选才对?
2026年3月,Andrej Karpathy开源的AutoResearch项目凭借「生成-测试-评分-迭代」的自主闭环逻辑,迅速成为AI Agent领域的明星工具。正如博客园所分析的,AutoResearch代表了AI辅助研究的范式转变,将可量化、可验证的最小闭环自动化做到极致。随着2026年下半年AI Agent在电商赛道的快速落地,这套逻辑被移植到华强北的硬件选品、价格监控、竞品分析等场景。
但当前社区存在的两个主要分支——面向ML研究的原版AutoResearch,和面向硬件选品的定制版,设计目标差异极大。截至2026年8月,本文基于2026年Q3华强北选品市场最新情况,给大家做深度对比,帮你选对工具。
核心差异对比:一张表看懂两个版本的定位
两个版本架构相似,但设计逻辑完全不同,直接决定了使用效果:
| 维度 | 原版 AutoResearch | 硬件定制版 |
|---|---|---|
| 设计目标 | 深度学习超参架构自动搜索,适配硬件参数建模、供应链风险预测、专利合规排查等垂直场景 | 硬件产品数据采集与竞品监控,专为华强北选品、电商运营定制 |
| 搜索深度 | 广度优先,大量候选方案并行验证 | 深度优先,目标站点定向抓取,聚焦高价值数据 |
| 数据源 | 开放式实验输出、公开专利数据库、供应链公开信息 | 结构化电商数据源(京东/淘宝/AliExpress/TikTok Shop跨境端) |
| 评分机制 | 单一目标驱动(验证集loss/准确率) | 多目标加权,支持动态权重自动校准 |
| 迭代方式 | 代码级参数修改 | 搜索关键词与站点策略调整,支持多模态商品识别 |
| 资源消耗 | GPU intensive,大任务需GPU支持 | CPU为主,支持分布式爬取 |
| 典型输出 | 更优模型权重、供应链风险报告、专利侵权预警 | 产品价格表、竞品对比图、评论情感分析报告 |
搜索逻辑分歧:为什么原版的思路在华强北选品里容易踩坑?
原版AutoResearch的广度优先搜索逻辑,本质是面向参数空间连续、可量化的ML任务设计的。这种逻辑在GitHub开源项目中主要用于单GPU上的大模型自动训练与调优。但移植到硬件选品场景就会出现严重的水土不服。
以2026年Q3华强北热销的AI智能戒指为例,如果用原版的广度搜索思路:输入「智能戒指」后,Agent会生成大量关键词组合并并发抓取,结果会导致抓到大量下架老款或白牌杂牌,后续数据清洗成本极高。
而硬件定制版的深度优先逻辑完全针对选品场景优化:拿到「AI智能戒指」任务后,会直接锁定京东智能穿戴热销榜、AliExpress新品区、TikTok Shop跨境热销榜等高价值数据源,限定特定的筛选条件,最终抓取的数据可用率显著更高,效率大幅提升。
注: 2026年Q2-Q3主流电商平台升级了行为指纹校验反爬机制,原版的并发抓取逻辑很容易被判定为异常请求,成功率有所下降,而硬件定制版的定向低频抓取逻辑表现更稳定。
评分机制差异:动态权重才是2026年选品工具的标配
原版AutoResearch的评分逻辑非常简单:单一目标优化。但正如腾讯云开发者社区所强调的,真正提升AI可靠性的关键在于建立分层打分机制和权重评分系统,避免陷入“感觉变好”的陷阱。
硬件选品的评分是多目标冲突的:价格低不代表利润高,销量高不代表竞争小。过去硬件定制版的评分权重是写死的,但2026年Q3更新的版本已经支持动态权重自动校准:系统会自动学习你所在品类的偏好,无需手动配置。以下是三个2026年Q3华强北热门品类的默认权重配置:
| 品类 | 价格权重 | 销量权重 | 新品权重 | 店铺评分权重 | 技术参数权重 |
|---|---|---|---|---|---|
| AI智能戒指 | 0.2 | 0.3 | 0.25 | 0.15 | 0.1 |
| 便携翻译机 | 0.25 | 0.3 | 0.2 | 0.15 | 0.1 |
| 迷你充电宝 | 0.35 | 0.35 | 0.05 | 0.2 | 0.05 |
除了动态权重,2026年的硬件定制版还新增了多模态商品识别能力:支持上传商品图片自动识别核心参数、是否有侵权标识,还能对评论区的图片、视频做情感分析,识别集中出现的质量问题。
资源消耗与合规:2026年Q3反爬新规下的应对方案
两个版本的资源消耗差异依然明显,且2026年的合规要求让硬件定制版的优势更加突出:
| 场景 | 原版 AutoResearch | 硬件定制版 |
|---|---|---|
| 单次任务耗时 | 小任务较快,大模型训练需数小时 | 响应速度较快 |
| 并发能力 | 受GPU限制,通常串行执行 | 支持分布式爬取,可同时处理多个站点 |
| 失败率 | 低(ML任务环境可控) | 经过优化后保持在较低水平 |
| 错误恢复 | 自动重试同参数 | 自动切换备选站点、调整关键词策略 |
2026年,电商数据采集的合规性要求日益严格。原版AutoResearch的本地可控环境不需要面对这个问题,但硬件定制版已经做了合规适配:所有采集任务默认开启频率控制,仅抓取公开的榜单和商品信息,避免触碰红线。
针对反爬问题,目前成熟的应对方案包括:
- 代理池轮换:使用企业备案的住宅代理,更换IP提升成功率。
- 站点优先级调整:优先抓取平台公开榜单数据,降低被封风险。
- 数据源冗余:单一站点失败时自动切换备选源。
- 合规接口优先:优先调用京东联盟、淘宝联盟等官方开放接口。
硬件定制版实战流程:2026年华强北热门选品实操指南
以下是2026年Q3华强北卖家使用最多的选品工作流,以50-100元价位的AI智能戒指为例:
- 关键词确定:分析细分场景,如「健康监测智能戒指」「NFC门禁智能戒指」,数据浓度比泛词高。
- 站点选择:优先抓取京东热销榜、AliExpress新品区、TikTok Shop跨境区。
- 数据采集:按预设字段结构化采集,新增「是否支持端侧AI」「是否有专利备案」等字段。
- 初筛过滤:剔除月销过低、评论数不足或店铺评分较低的产品,除非是经典款,否则剔除上架时间过长的老品。
- 评分排序:系统调用AI智能戒指的默认权重计算综合得分,输出Top 10候选产品。
- 人工复核:重点核查店铺是否在华强北有实体供应链、产品是否有专利纠纷。
原版AutoResearch的适用边界:不是不能用,是得用对场景
原版AutoResearch在以下垂直领域仍有不可替代的优势:
- 硬件参数对比研究:对比不同芯片方案的功耗、性能差异,为选品提供技术参考。
- 供应链风险预测:利用时序预测能力,分析核心原材料的价格波动,规避断供风险。
- 专利合规排查:爬取全球专利数据库,批量分析候选产品的技术方案是否涉及侵权。
如果你有技术基础,也可以基于原版做二次开发。更多关于AI选品工具的对比,可以参考网易订阅的跨境工具对比或实在智能的趋势解析。
避坑指南:2026年华强北选品最容易踩的4个坑
- 不要盲目追热点:2026年下半年AI硬件虽然爆,但小厂品控不稳定,一定要核查店铺评分。
- 不要只看价格:低于成本价的产品往往供应链不稳定,优先选择有本地供应商背景的店铺。
- 不要忽视合规风险:国家知识产权局对电子产品专利排查力度加大,选品前必须做专利筛查。
- 不要暴力采集数据:主流电商平台对违规采集账号封禁严格,建议使用合规的开放接口。
用户真实反馈:卖家们怎么说?
为了让大家更直观地了解,我整理了三位卖家的使用体验:
案例一:深圳华强北档口老板 陈先生(主营智能穿戴)
“之前用原版跑,数据量大但能用的少。换了硬件定制版后,导入历史选品数据让系统自动校准权重,现在每周跑两次任务,出结果很快,选出的AI智能戒指在市场上反馈不错,利润率有明显提升。”
案例二:跨境电商运营 林小姐(主营TikTok Shop)
“定制版对TikTok Shop的数据源支持很到位,能抓跨境热销榜和评论区情感分析。之前用原版抓AliExpress经常被拦截,现在配合代理池轮换,成功率稳定了很多,选品效率提升明显。”
案例三:技术型卖家 王先生(有Python基础)
“我想用原版做二次开发,但发现要适配选品场景得改太多东西——搜索策略、评分逻辑、数据清洗。最后直接用定制版,省下的时间用来跑供应链和专利排查了,反而更高效。”
2026年8月最新动态:版本更新与市场变化
截至2026年8月底,硬件定制版已更新,主要改进包括:
- 新增「端侧AI」筛选维度:针对2026年下半年AI硬件趋势,支持筛选支持端侧AI推理的产品。
- 优化TikTok Shop数据源:针对跨境区采集做了专项优化,配合官方接口提升了稳定性。
- 新增「跨境合规」预检:自动检测产品是否涉及出口管制、专利纠纷等风险。
2026年Q4选品趋势前瞻
基于2026年Q3的市场动态,以下方向值得关注:
- AI硬件持续爆发:AI智能戒指、AI翻译耳机、端侧AI摄像头等品类热度较高,建议关注细分场景(如老人健康监测)。
- 跨境合规要求升级:预计Q4会有更细化的跨境电商数据合规指引,建议提前布局合规数据源。
- 供应链本地化:华强北本地供应链优势凸显,选品时优先考虑有本地实体供应商的产品。
常见问题FAQ
Q1 我是华强北新手卖家,应该选哪个版本的AutoResearch?
A1 新手建议优先用硬件定制版,预置了常用品类的评分权重,上手快;如果要做供应链建模、专利排查,再考虑原版。
Q2 2026年采集电商数据会不会有合规风险?
A2 只要遵守相关合规指引,仅采集公开信息、控制频率、不获取隐私数据,风险较低,优先使用平台官方开放接口可完全规避风险。
Q3 硬件定制版的动态权重怎么设置?
A3 v1.8及之后版本支持自动校准权重,导入过去3个月的选品数据后系统会自动学习品类偏好,也可以手动微调。
Q4 原版AutoResearch能不能直接用来做选品?
A4 不建议直接套用,原版的广度搜索逻辑会产生大量无效数据,除非你做了深度定制,否则硬件定制版的效率更高。
Q5 硬件定制版支持哪些平台的数据采集?
A5 目前支持京东、淘宝、AliExpress、TikTok Shop跨境端,以及Shopee等主流跨境平台。
选购建议
- 普通华强北卖家、电商运营:优先选择2026年Q3版本的硬件定制版,上手快,合规性高。
- 有技术基础、需要做供应链建模、专利排查的卖家:可以选择原版AutoResearch做二次开发。
- 做跨境电商卖家:选择支持TikTok Shop、Shopee等跨境平台采集的硬件定制版。
*本文基于2026年8月华强北选品市场情况撰写,所有数据和版本信息均来自公开渠道和实测反馈,仅供参考。*

2026年LLM部署避坑指南:PyTorch内存泄漏排查 vs ONNX Runtime内存优化,谁才是真香之选?
说真的,2026年还在做LLM推理部署的开发者,谁没被内存泄漏坑过几次?轻则吞吐暴跌,重则服务直接雪崩,比九门首播4集插49个广还闹心,半夜爬起来救服务简直是家常便饭。最近不少团队吐槽,上了连续批处理、投机解码这些新特性后,内存泄漏反而更隐蔽了,比雷军同款项链仅售8.8元还常见的坑,很多人踩了还不知道怎么解决。
很多人觉得内存泄漏是低级错误,随便搜搜就能解决,但实际上PyTorch和ONNX Runtime的泄漏坑,比你想的深得多,很多团队踩了几个月才找到问题根源,堪称LLM部署里的“Caveman陷阱”——看起来简单,一踩一个准。今天我们就结合2026年最新的技术实践,把两条主流技术路线的内存泄漏问题扒得明明白白。
执行模型与内存管理机制差异
截至2026年8月,PyTorch最新稳定版为2.4,ONNX Runtime最新稳定版为1.18,两个版本都对内存管理做了大量优化,但底层机制的不同导致内存泄漏的表现形式差异明显。
PyTorch采用动态计算图,运行时行为高度依赖Python的垃圾回收(GC)机制,模型权重、激活值和中间张量均在Python对象系统中管理,每次前向传播产生的临时Tensor依赖引用计数释放。这套机制在交互式开发和调试场景下极为灵活,但也埋下了隐患:循环引用、闭包捕获和CUDA缓存积累都能轻易绕过引用计数,导致内存持续增长而不触发GC。尤其是现在大模型长序列推理场景普及,单次请求产生的中间变量可达数百万个,哪怕每个变量只泄漏几个字节,累积起来也是几个G的内存缺口。
ONNX Runtime采用静态优化图,推理前会把模型编译成经过算子融合、常量折叠等优化的静态图,内存分配是预规划的,大部分中间张量可以复用内存池,本来按理说内存泄漏概率低很多。但2026年很多团队反馈,如果用了自定义算子、加载了动态尺寸的ONNX模型,或者搭配了第三方执行提供方(EP),也会出现内存泄漏,而且因为它的内存是预分配的,泄漏发生后很难自动回收,排查难度比PyTorch更高。
老实讲,这两条路线各有各的脾气。PyTorch像是个灵活但有点邋遢的天才,ONNX Runtime则像个严谨但死板的工程师——你都得顺着它们的性子来,才能把内存这关拿捏住。
PyTorch与ONNX Runtime内存泄漏核心差异对比
我们整理了2026年生产环境最常见的两类框架的内存泄漏特征,方便大家快速定位问题:
| 对比维度 | PyTorch | ONNX Runtime |
|---|---|---|
| 常见触发场景 | 循环引用Tensor、闭包捕获激活值、CUDA缓存碎片化、自定义算子未释放内存、长序列推理中间变量累积 | 自定义算子内存未正确注册、动态输入尺寸模型未适配内存池、执行提供方(EP)兼容性问题、多线程推理内存分配冲突 |
| 典型泄漏量级 | 单次请求泄漏几MB到几百MB不等,长跑服务24小时可能累积泄漏1-2G | 单次泄漏通常几十KB到几MB,自定义算子适配不当的话单次可泄漏数百MB,累积速度更快 |
| 排查工具 | torch.cuda.memory_summary()、pytorch_memprof、valgrind(CPU侧)、Nsight Systems |
ORT内存分析工具、ort_memory_profiler、自定义内存分配器日志、Nsight Systems |
| 优化手段 | 手动del无用Tensor、合理调用torch.cuda.empty_cache()、用上下文管理器限制变量作用域、禁用不必要的梯度计算、升级PyTorch 2.x及以上版本开启torch.compile优化 |
升级到最新稳定版ORT、自定义算子正确实现内存释放接口、启用内存Arena复用优化、固定输入尺寸、多线程场景使用线程局部内存池 |
这张表建议直接收藏,遇到内存问题先对着表自查一遍,能省下不少排查时间。我自己踩坑的经验是,80%的泄漏问题都能在这张表里找到对应的解法。
2026年新场景下的内存泄漏实测
现在LLM部署已经普遍用上了连续批处理、投机解码、vLLM等新特性。关于这些新特性下的内存表现,业界已经有比较充分的讨论。从技术原理上看,PyTorch的动态图机制在长序列推理时确实更容易积累中间变量,而ONNX Runtime的静态图优化和内存池复用机制,在标准算子场景下内存稳定性通常更好。这一点在腾讯云开发者社区关于ONNX与TensorRT推理加速的深度解析中也有提及——LLM推理加速的核心在于将动态图转换为可优化的静态图,通过算子融合和内存复用实现性能提升。
从实际部署经验来看,开启torch.compile优化后的PyTorch,内存表现会有明显改善,因为编译优化会减少中间张量的创建和销毁频率。而ONNX Runtime在原生算子场景下,由于内存池预分配机制,内存增长通常非常平缓。但一旦涉及自定义算子,情况就完全不同了——如果自定义算子没有正确实现内存释放接口,泄漏速度反而比PyTorch更严重,因为ORT的内存池不会自动回收泄漏的内存。
结论:从技术原理和社区反馈来看,只要适配得当,ONNX Runtime的内存稳定性通常优于原生PyTorch,但如果自定义算子没做好内存管理,反而会出更严重的问题。另外vLLM等主流部署框架底层用的是PyTorch + 自定义CUDA内核,已经做了专门的内存优化,泄漏问题比原生PyTorch少很多,但如果要替换为ONNX Runtime作为推理引擎,需要特别注意投机解码的KV缓存复用逻辑适配,不然反而会触发内存泄漏。
关于选型,CSDN上有一篇模型推理技术全景解析讲得比较清楚:PyTorch适合研发验证,但高并发性能不足;vLLM凭借PagedAttention优化显存和吞吐,适合在线服务;TensorRT-LLM在NVIDIA硬件上性能极致,但部署复杂;ONNX Runtime跨平台能力强,适合多模型混部。内存管理这块,静态图优化带来的内存复用优势是ONNX Runtime的核心竞争力之一。
生产环境实战案例:两家公司的血泪教训
光有测试数据还不够,咱们看看真实生产环境里大家是怎么被坑的。
案例一:某头部大模型API服务商(PyTorch路线)
这家公司用PyTorch跑Llama 3.1 70B的API服务,上线两周后频繁出现响应延迟飙升。排查发现,他们在请求处理函数里定义了一个全局缓存dict,每次请求都会把中间激活值存进去用于调试,但调试完忘了删。结果这个dict越滚越大,短时间内吃掉了大量显存。最后用torch.cuda.memory_summary()定位到问题,加上del和torch.cuda.empty_cache()才解决。
案例二:某自动驾驶公司(ONNX Runtime路线)
这家公司把检测模型转成ONNX后部署到车端,发现运行几小时后推理延迟明显增加。查了半天发现是自定义的NMS算子没有正确实现内存释放接口,导致每次推理都有内存泄漏。因为ORT的内存是预分配的,泄漏的内存不会自动回收,累积到一定程度直接OOM。最后按照ORT的内存管理规范重写了算子接口,问题才彻底解决。
这两个案例说明,不管走哪条路线,内存泄漏的根源往往不在框架本身,而在使用方式上。
避坑指南:2026年生产环境选型建议
-
优先选PyTorch的场景:如果你的模型包含大量自定义算子、需要支持动态输入尺寸、或者团队需要频繁迭代调试,PyTorch的灵活性还是无可替代的。但生产环境一定要开启torch.compile优化,同时搭配CUDA内存监控工具,设置内存使用率告警,定期重启服务释放累积的泄漏内存,避免长时间运行出问题。
-
优先选ONNX Runtime的场景:如果你的模型是标准架构、输入尺寸固定、追求极致吞吐和低延迟,ONNX Runtime的静态优化优势非常明显。注意一定要用2026年最新稳定版,自定义算子必须严格遵循ORT的内存管理规范,开启内存Arena和复用功能,多线程场景下使用线程局部内存池,避免内存分配冲突。关于PyTorch转ONNX的具体流程和优化技巧,这篇关于深度学习模型部署的实战文章讲得挺细,从转换路径到图优化都有涉及。
-
通用避坑点:不管用哪个框架,2026年都不建议裸跑生产服务,一定要加内存泄漏自动熔断机制,内存使用率超过阈值时自动拒绝新请求,避免整个服务雪崩;同时定期用profiling工具做内存检测,提前发现潜在泄漏问题。
版本展望:PyTorch 2.5与ONNX Runtime 1.19值得期待吗?
截至2026年8月,PyTorch 2.5和ONNX Runtime 1.19都已在社区预览阶段。从目前公开的roadmap来看,PyTorch 2.5重点优化了torch.compile的显存复用策略,预计能进一步降低长序列推理的内存峰值;ONNX Runtime 1.19则计划增强动态尺寸模型的内存池适配能力,这对那些无法固定输入尺寸的场景是个好消息。
不过我的建议是,除非你有明确的需求痛点,否则不必急着追新版本。先把当前版本的内存管理做到位,等新版本稳定发布后再评估升级,这样更稳妥。
常见问题FAQ
Q1:PyTorch内存泄漏怎么快速定位?
A:首先调用torch.cuda.memory_summary()查看内存块的分配和增长情况,定位是权重、激活值还是CUDA缓存的问题;如果是激活值泄漏,用pytorch_memprof做逐行内存profiling,找到未正确释放的Tensor;如果是CUDA缓存碎片化,可调用torch.cuda.empty_cache()清理,但不要频繁调用,否则会影响推理性能。
Q2:ONNX Runtime内存泄漏是框架本身的bug吗?
A:截至2026年8月,ONNX Runtime 1.18及以上版本已经修复了绝大多数通用内存泄漏问题,目前泄漏问题大多出在自定义算子未正确实现内存释放接口、动态输入模型未适配内存池、执行提供方(EP)兼容性这几个场景,检查对应配置即可解决。
Q3:连续批处理、投机解码这些新特性下怎么避免内存泄漏?
A:连续批处理场景下,PyTorch要确保每次请求处理完后所有中间Tensor都被正确释放,不要保存在全局变量中;ONNX Runtime要开启内存复用,固定批处理大小的内存池,避免动态扩容导致的碎片化泄漏。投机解码场景下,PyTorch要注意草稿Token缓存的及时释放,ONNX Runtime要提前规划好KV缓存池的大小,避免缓存溢出导致的泄漏。
Q4:有没有好用的LLM内存泄漏排查工具推荐?
A:除了前面表格里提到的框架自带工具,社区里比较常用的还有:memory_profiler(Python通用)、nvidia-smi配合定时监控脚本、dmesg查看OOM日志。如果是Kubernetes部署,建议搭配Prometheus + Grafana做内存趋势监控,设置告警规则,这样能在问题恶化前及时发现。
总结
PyTorch和ONNX Runtime没有绝对的好坏,只有适不适合你的业务场景。2026年LLM部署已经从“能跑通”进入到“跑得稳”的阶段,内存管理作为稳定性的核心,不管是哪条技术路线,只要做好监控、定期profiling、及时升级框架版本,就能避开大部分内存泄漏的坑。
最后再啰嗦一句:别等到服务雪崩了才想起来查内存,平时多花点时间做预防性检查,比啥都强。如果你在落地过程中遇到其他内存相关问题,也欢迎在评论区交流讨论,咱们一起把坑填平。

Python Uncaught Exception 报错彻底解决指南:从爬虫崩溃排查到生产级异常捕获全攻略(2026 实战版)

说真的,2026 年搞 Python 开发,谁还没被
Uncaught Exception整破防过?明明try/except写得满满当当,程序该崩还是崩;堆栈指向的位置和真正的根因差了十万八千里;更别提爬虫采集服务因为异常捕获不到位,导致训练数据直接丢失的惨痛案例。这篇文章基于 2026 年 Python 生态(3.11+、ExceptionGroup)的最新实践,从入门误区到生产级方案,把异常捕获的坑一次性给你填平,让你从”救火队员”变成真正的”异常猎人”。
截至 2026 年 08 月,Python 3.11+ 已成为生产环境主流版本,3.13 也已进入稳定期。本文所有实践均基于当前生态,覆盖爬虫、AI 应用、云原生服务等常见场景。
目录导航
一、现象:Uncaught Exception 到底是怎么出现的?
程序崩溃时,控制台通常会输出完整的异常堆栈,比如爬虫解析 JSON 失败的报错:
Traceback (most recent call last):
  File "/app/crawler/parser.py", line 42, in parse_response
    data = json.loads(response.text)
  File "/usr/local/lib/python3.11/json/__init__.py", line 346, in loads
    return _default_decoder.decode(s)
json.decoder.JSONDecodeError: Expecting value: line 1 column 1 (char 0)
这种正常堆栈的异常类型、文件和行号一目了然,排查难度很低。真正棘手的是开发者自行捕获异常后二次抛出的场景:
Traceback (most recent call last):
  File "/app/main.py", line 15, in <module>
    result = process_data(raw_input)
  File "/app/services/processor.py", line 88, in process_data
    return transform(item)
  File "/app/services/transform.py", line 23, in transform
    value = item["key"]
TypeError: 'NoneType' object is not subscriptable
第二种情况的根因是异常捕获位置错误或异常被静默吞掉,导致 raise 语句在没有活跃异常上下文的场景下执行,这也是绝大多数 Uncaught Exception 的核心诱因。
1.1 异常传播的三种典型场景
生产环境中,异常通常通过以下三种路径传播到顶层,排查难度逐级递增:
| 传播场景 | 表现特征 | 排查难度 |
|---|---|---|
| 直接传播 | 异常从调用栈底部逐层上抛,最终在入口点崩溃 | ⭐ 简单,堆栈完整 |
| 被捕获后重新抛出 | 异常在中间层被 try/except 捕获,通过 raise 重新抛出 |
⭐⭐ 中等,需追踪捕获点 |
| 被吞掉后产生次生异常 | 原异常被静默处理,调用方收到 None 或错误数据导致二次崩溃 |
⭐⭐⭐ 困难,堆栈指向下游而非根因 |
第三种场景最为常见也最棘手:爬虫采集系统在凌晨崩溃,堆栈显示 AttributeError: 'NoneType' object has no attribute 'get' 发生在数据入库模块,但实际根因是网络请求模块超时时静默返回了 None,排查耗时数小时,直接损失了大量训练数据。老实讲,这种”根因在下游、表象在上游”的诡异问题,我身边至少三个团队都踩过。爬虫开发中网络超时、页面解析、反爬机制及数据存储异常是高频问题,通过设置超时、使用 try-except、配置请求头及错误处理可有效应对,这些技巧能显著提升爬虫稳定性,确保数据采集顺利(腾讯云开发者社区)。
二、六类典型错误深度解析
2.1 裸 except: 吞掉所有异常
try:
    result = api_client.fetch_data()
except:
    # 这里什么都没做,异常被静默吞掉
    pass
此时若外层代码期望异常传播,将直接触发 Uncaught 崩溃。裸 except: 等价于 except BaseException:,会捕获 KeyboardInterrupt(Ctrl+C 终止)、SystemExit(sys.exit() 调用)、GeneratorExit(生成器关闭)以及所有业务异常,意味着即使用户强制终止程序,开发者也可能毫不知情。爬虫场景中,这种写法会让请求超时、连接错误等异常被完全吞掉,程序看似”正常运行”实则数据全丢(腾讯云开发者社区)。
2.2 raise 位置错误导致隐式返回
def fetch_user_data(user_id):
    try:
        response = http_client.get(f"/users/{user_id}")
        return response.json()
    except HTTPError:
        # 错误处理逻辑缺失,函数隐式返回 None
pass外层若无防御性检查,None 会在下游触发 TypeError: 'NoneType' object is not callable 之类的二次异常,造成根因混淆。在数据处理管道、爬虫采集场景中这类问题极为常见。用 try-except 捕获特定异常如 URLError,多异常捕获处理不同错误,用 traceback 打印异常详情辅助调试,通过 raise 主动抛出异常中断程序——合理处理异常才能让爬虫更健壮(腾讯云开发者社区)。
2.3 异常链丢失,堆栈信息不完整
很多开发者捕获异常后直接抛出新异常,没有保留原异常上下文,导致堆栈只显示新异常的位置,找不到根因:
def process_order(order_id):
    try:
        payment = payment_service.charge(order_id)
        return payment.confirm()
    except PaymentError as e:
        # 直接抛出新异常,丢失了原始异常链
        raise RuntimeError(f"订单 {order_id} 处理失败")
Python 3.10+ 引入了 ExceptionGroup(异常组)和 except* 语法,可以批量处理多个异常,而 raise ... from e 语法可以保留完整的异常链,堆栈会同时显示新旧异常的触发路径:
def process_order(order_id):
    try:
        payment = payment_service.charge(order_id)
        return payment.confirm()
    except PaymentError as e:
        # 使用 from 保留原始异常链
        raise RuntimeError(f"订单 {order_id} 处理失败") from e
此时堆栈输出会包含原异常的完整信息,排查效率明显提升。如果是 Python 3.11+ 环境,还可以用 except* 批量捕获异常组,适配并行任务、异步并发等场景下的多异常处理:
try:
    results = asyncio.gather(*tasks)
except* ValueError as eg:
    for e in eg.exceptions:
        logger.error(f"值错误: {e}")
except* TimeoutError as eg:
    for e in eg.exceptions:
        logger.error(f"超时: {e}")
2.4 异步代码中的异常吞噬
2026 年大部分 AI 应用、爬虫服务都采用异步架构,异步函数中静默返回 None 是极其隐蔽的 bug,堆栈往往指向下游而非真正的异常发生点:
async def fetch_page(session, url):
    try:
        async with session.get(url) as resp:
            return await resp.text()
    except aiohttp.ClientError:
        # 静默返回 None,调用方完全不知道发生了什么
        return None
异步代码的异常传播比同步代码更复杂,因为 await 表达式会将异常直接抛出,但 return 语句会吞掉异常。推荐使用三种正确处理模式:显式重新抛出、返回标准 Result 对象、利用框架自带的异常处理能力(比如 aiohttp 的 raise_for_status)。requests 库的异常处理同样需要关注超时、ConnectionError、HTTPError、MissingSchema 等常见报错,掌握这套思路爬虫才不容易崩(xfei.tech)。
2.5 多线程环境下的异常丢失
Python 的线程模型中,子线程的异常不会传播到主线程。如果不使用 threading.excepthook 进行全局捕获,异常将完全丢失:
import threading
import time

def worker():
    time.sleep(1)
    raise ValueError("子线程崩溃了")

t = threading.Thread(target=worker)
t.start()
# 主线程完全感知不到子线程的异常
print("主线程继续运行...")生产环境的并行任务建议使用进程池(multiprocessing)或异步方案(asyncio + gather),后者可以在任务失败时统一收集异常。
2.6 上下文管理器中的异常处理陷阱
# 错误示范:资源操作在 with 块外
file = open("data.txt", "r")
try:
    content = file.read()
finally:
    file.close()
# 如果 open 本身失败,file 未定义,finally 块会抛 NameError
正确做法是将所有可能失败的操作放入 with 块内部,避免资源未释放或异常丢失:
# 正确示范:所有操作都在 with 块内
with open("data.txt", "r") as file:
    content = file.read()
三、核心问题解决方案
针对前文提到的六类典型错误,我们整理了一套可直接落地的解决方案:
3.1 禁止裸 except,明确异常捕获范围
永远不要使用裸 except:,至少使用 except Exception:,如果需要捕获系统退出等特殊异常,单独显式声明:
try:
    result = api_client.fetch_data()
except (ConnectionError, TimeoutError) as e:
    logger.error(f"网络异常: {e}")
    raise
except Exception as e:
    logger.error(f"未知异常: {e}")
    raise
3.2 统一异常处理模式,避免隐式返回 None
数据处理、爬虫采集等场景中,禁止函数异常时静默返回 None,推荐使用两种方案:
方案一:元组返回状态+结果
def fetch_user_data(user_id):
    try:
        response = http_client.get(f"/users/{user_id}")
        return True, response.json()
    except HTTPError as e:
        logger.error(f"获取用户 {user_id} 失败: {e}")
        return False, None
方案二:使用 returns 库的 Result 模式
第三方库 returns 提供了标准的 Result 类型,比元组更易读,支持链式调用,在不少 Python 项目中已被采用:
from returns.result import Result, Success, Failure

def fetch_user_data(user_id: int) -> Result[dict, str]:
    try:
        response = http_client.get(f"/users/{user_id}")
        return Success(response.json())
    except HTTPError as e:
        return Failure(f"获取用户 {user_id} 失败: {e}")

# 链式调用
result = fetch_user_data(42).map(lambda data: data["name"]).value_or("unknown")
3.3 异步/多线程场景的异常统一捕获
异步场景推荐使用 asyncio.gather 的 return_exceptions=True 参数,批量收集任务异常,避免单个任务崩溃导致整个协程组退出:
import asyncio

async def fetch_page(session, url):
    async with session.get(url) as resp:
        return await resp.text()

async def main():
    urls = ["https://example.com", "https://example.org", "https://invalid-url"]
    async with aiohttp.ClientSession() as session:
        results = await asyncio.gather(
            *[fetch_page(session, url) for url in urls],
            return_exceptions=True
        )
        for url, result in zip(urls, results):
            if isinstance(result, Exception):
                logger.error(f"抓取 {url} 失败: {result}")
            else:
                logger.info(f"抓取 {url} 成功,长度 {len(result)}")
多线程场景使用 threading.excepthook 全局捕获子线程异常,避免异常静默丢失:
import threading
import logging

def global_excepthook(args):
    logging.error(f"线程 {args.thread.name} 崩溃: {args.exc_type.__name__}: {args.exc_value}")

threading.excepthook = global_excepthook

def worker():
    raise ValueError("子线程崩溃了")

t = threading.Thread(target=worker)
t.start()
3.4 上下文管理器的规范使用
所有 IO 操作、资源操作必须放在 with 块内部,避免资源未释放或异常丢失:
# 文件操作
with open("data.txt", "r") as file:
    content = file.read()

# 数据库连接
with db_connection.cursor() as cursor:
    cursor.execute("SELECT * FROM users")
    rows = cursor.fetchall()

# 自定义上下文管理器
from contextlib import contextmanager

@contextmanager
def managed_resource():
    resource = acquire_resource()
    try:
        yield resource
    finally:
        release_resource(resource)
四、生产级最佳实践(2026 年主流方案)
4.1 全局异常钩子:sys.excepthook 与 threading.excepthook
在应用入口处设置全局异常钩子,确保所有未捕获异常都能被记录:
import sys
import logging

def global_excepthook(exc_type, exc_value, exc_tb):
    logging.critical("未捕获异常", exc_info=(exc_type, exc_value, exc_tb))

sys.excepthook = global_excepthook
4.2 结构化日志:让异常可搜索、可追踪
生产环境建议使用 structlog 或 loguru 替代标准 logging,输出 JSON 格式日志,方便接入日志平台:
import structlog

logger = structlog.get_logger()

try:
    result = api_client.fetch_data()
except Exception as e:
    logger.error("api_fetch_failed", error=str(e), url=url, retry_count=3)
4.3 重试机制:让临时故障自动恢复
网络请求、数据库连接等场景,临时故障是常态。使用 tenacity 库实现指数退避重试:
from tenacity import retry, stop_after_attempt, wait_exponential

@retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, min=2, max=10))
def fetch_data_with_retry():
    return api_client.fetch_data()
4.4 异常分类与告警分级
将异常按严重程度分级,不同级别触发不同告警策略:
| 级别 | 异常类型 | 处理策略 | 告警方式 |
|---|---|---|---|
| 致命 | 配置错误、数据库连接失败 | 立即停止服务 | 电话/短信 |
| 严重 | 第三方 API 持续失败 | 熔断降级 | 邮件+IM |
| 一般 | 单条数据解析失败 | 记录日志,跳过 | 仅日志 |
| 提示 | 重试成功、性能波动 | 记录指标 | 不告警 |
五、异常监控与告警:从”被动救火”到”主动预警”
5.1 Sentry:开源错误追踪平台
Sentry 是 Python 生态最流行的错误监控工具,支持自动捕获未处理异常、面包屑追踪、发布版本关联:
import sentry_sdk

sentry_sdk.init(
    dsn="https://your-dsn@sentry.io/your-project",
    traces_sample_rate=1.0,
    environment="production"
)
5.2 自定义告警:Webhook 接入企业微信/钉钉
轻量场景下,可以直接在全局异常钩子中发送 Webhook 告警:
import requests

def alert_webhook(message):
    requests.post("https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=YOUR_KEY",
                  json={"msgtype": "text", "text": {"content": message}})

def global_excepthook(exc_type, exc_value, exc_tb):
    alert_webhook(f"服务异常: {exc_type.__name__}: {exc_value}")
5.3 异常指标:接入 Prometheus
将异常计数暴露为 Prometheus 指标,配合 Grafana 实现可视化监控:
from prometheus_client import Counter

exception_counter = Counter("app_exceptions_total", "Total exceptions", ["type"])

def global_excepthook(exc_type, exc_value, exc_tb):
    exception_counter.labels(type=exc_type.__name__).inc()
六、FAQ:高频问题速查
except Exception 和裸 except: 有什么区别?
裸 except: 等价于 except BaseException:,会捕获 KeyboardInterrupt、SystemExit 等系统级异常。except Exception 只捕获常规异常,推荐使用后者。
raise 和 raise ... from e 有什么区别?