

前阵子出差,晚上十一点在深圳宝安机场候机,膝盖上架着刚买的 Swift 14 AI,屏幕里跑着 Qwen2.5-7B 的 GGUF 量化版,旁边充电宝挂着 USB-C 线给笔记本续命,候机厅 Wi-Fi 卡到加载不出 Ollama 的云端模型镜像。那一刻我才反应过来,「轻薄 AI 笔电」这个品类,听起来很美好,用起来全是取舍。如果你也在华强北的数码广场或者线上渠道纠结要不要入手这台 Swift 14 AI,希望我这一周的真实使用记录能帮你做决定。
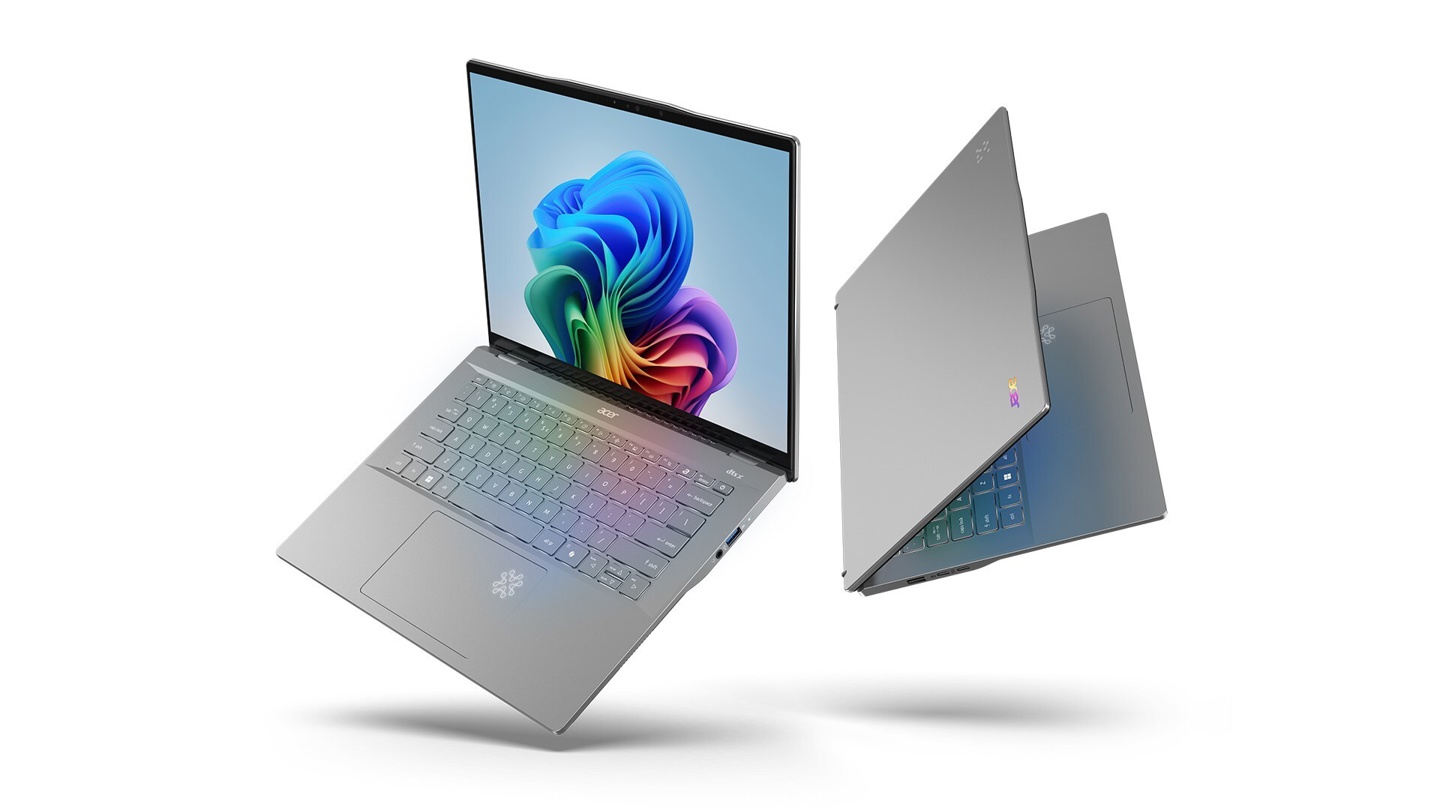
备注:Swift 14 AI 在不同批次有 Meteor Lake(Core Ultra 100 系列,约 11 TOPS NPU)和 Lunar Lake(Core Ultra 200V 系列,约 47 TOPS NPU)两个版本,本文实测机为 Lunar Lake 版本。两者在 NPU 算力和内存配置上差异不小,买之前最好跟卖家确认清楚具体型号。
一、便携性的代价:散热与续航
轻薄是真的,但代价也摆在明面上。
1.1 散热:1.5cm 机身的物理天花板
Swift 14 AI 的机身厚度不到 1.5 cm,风扇模组做得很薄。日常办公、回邮件、写代码没问题,可一旦进入持续负载,风扇会顶着转速跑,键盘面温度明显升高。
这一点对常挂模型推理的人来说很关键——大模型推理往往是分钟级的持续运行,不是几秒钟的峰值。我用 AIDA64 跑稳定性测试时,CPU 封装功耗在长时间负载下会被压到明显低于标称基础功耗的水平。这是 1.2kg 轻薄本散热模组的物理上限,不是偷工减料。
键盘面 WASD 区域在持续推理时能摸到四十多度,长时间打字会有明显热感。如果你是模型开发者需要长时间挂着推理任务盯输出,建议外接键盘或者放到散热底座上。
1.2 续航:AI 任务下的真实数据
电池在 50–65Wh 之间(具体配置不同),日常办公撑 8–10 小时问题不大;但一旦 CPU + 集显开始持续推理,掉电肉眼可见加快,半天基本就是极限。
我做了个简单的对比测试(亮度统一 60%,仅供参考,不同机器会有浮动):
- 场景 A:纯文档处理 + 浏览网页,续航大约 9 小时左右
- 场景 B:本地跑 7B 量化模型连续推理,续航大约 3-4 小时
- 场景 C:混合办公 + 偶尔调用云端 API,续航大约 7 小时
场景 B 说明本地大模型推理对 Swift 14 AI 这类轻薄 AI 笔电来说,依然是个「电池黑洞」。老实讲,如果你重度依赖本地 AI 推理,随身带 PD 充电宝是必须的。
二、接口布局:AI 工作流够不够
Swift 14 AI 的接口配置大致是:2 个 USB-C(支持 Thunderbolt 4 与 PD 充电)、2 个 USB-A、HDMI 2.1、3.5mm 音频,部分版本还带 MicroSD 读卡器。
对「AI 笔电」这个定位,这套接口只能算中规中矩。几个实际场景要拎出来说:
2.1 USB-C 的双口困局
两个 USB-C 都支持 PD 与 DP 协议,但日常插电使用时,扩展坞基本躲不掉。我自己的典型工作流是:
- 一个 USB-C 接 PD 充电器供电
- 另一个 USB-C 接扩展坞,连外接显示器 + 有线键鼠 + 网卡
这种情况下,两个 USB-C 就被「焊死」了。虽然机身上还有两个 USB-A,但如果你已经插了无线鼠标接收器和移动硬盘,想临时再插个 U 盘,还是得拔一个。出差路上如果忘带扩展坞,工作流直接断裂。
2.2 缺失接口的连锁反应
- 没有 RJ45 网口:如果要往 NAS 传大模型权重文件(比如一个 13B 模型动辄 7-8GB),Wi-Fi 速率会成为瓶颈,特别是 5GHz 受干扰的时候。我自己实测过,从 NAS 拉一个 8GB 左右的 GGUF 文件,千兆有线环境下明显比 Wi-Fi 6 快很多,后者尤其在网络拥塞的时候慢的让人想砸键盘。
- 没有 RJ45 网口也意味着:在酒店、出租屋这类网络环境复杂的场景下,如果需要稳定连接做模型下载或远程开发,USB-C 转 RJ45 转接头又是额外一笔开销。
- MicroSD 读卡器(部分版本):对于摄影创作者是加分项,但对 AI 工作流意义不大,更像是「营销导向」的接口配置。
2.3 eGPU 的悖论
想接外接显卡(eGPU)做本地大模型加速?Thunderbolt 4 理论可行,但 1.2kg 笔电 + 显卡坞,这套组合就完全背离了「轻薄」的初衷,体验上很割裂。
而且 Thunderbolt 4 的 PCIe 通道带宽有限,外接 RTX 4090 跑大模型推理时,PCIe 4.0 x4 的瓶颈会让 GPU 利用率打折扣。除非你的 AI 工作流是「出差路上写代码,回家接 eGPU 训练」这种模式,否则 eGPU 对 Swift 14 AI 来说是个伪需求。
2.4 我的出门标配
踩过几次坑后,我现在出门基本是「机器 + 一个 USB-C 扩展坞」的配置:
- 扩展坞连外接 4K 显示器
- 扩展坞接千兆网线
- 扩展坞连机械键盘
- 笔记本原生 USB-A 插 U 盘或无线鼠标接收器
单靠机身原生接口做 AI 工作流,难度不小。如果你是接口重度使用者,建议把这部分预算也纳入购机成本。
三、NPU 与本地推理:真实上限
Swift 14 AI(Lunar Lake 版本)采用 Intel Core Ultra 200V 系列处理器,集成了 NPU,官方算力在 40 多 TOPS 这个量级。但要注意,TOPS 数字和「能不能跑大模型」是两回事,别被宣传图带跑偏。
3.1 NPU 的真实定位
Intel Core Ultra 的 NPU 主要面向的是:
- Windows Studio Effects(背景虚化、眼神接触、噪音消除)
- 实时翻译、字幕生成
- 本地 Stable Diffusion 加速(部分软件如 Adobe 支持)
- 轻量级图像分类、目标检测
NPU 的优势是低功耗,但它并不擅长大语言模型的 Token 生成。原因很简单:LLM 推理是典型的 Memory-Bound 任务,NPU 算力再强,受限于内存带宽和容量,也跑不动太大的模型。
3.2 实测各档位模型表现
实际跑下来:
- 3B–7B 量化模型(如 Qwen2.5-7B-Instruct-GGUF Q4_K_M):能跑,主要走 CPU + 集显路径,速度大约在每秒几个 token 的水平。能用,但谈不上流畅。首 token 延迟大约一两秒,长文本生成会有明显卡顿。
- 13B 以上模型:受限于机器内存上限(顶配 32GB),推理明显吃力,系统 swap 频繁,实际可用性比较差。我试过用 Q5_K_M 量化跑 13B 模型,每生成几十个 token 就会停顿几秒,体验基本不可用。
- NPU 加速:目前主流的 Ollama、llama.cpp、LM Studio 对 NPU 的支持仍在完善,多数场景下 NPU 还没真正参与到 LLM 推理链里,主力还是 CPU 和集显在扛。Intel 虽然在推 OpenVINO + NPU 的 LLM 推理方案,但生态成熟度还远不如 CUDA + NVIDIA 的组合。
3.3 软件生态的滞后
除了硬件,软件生态也是个大问题:
- Ollama:目前对 Intel NPU 的支持有限,主要还是用 CPU + 集显推理
- llama.cpp:有 OpenVINO 后端,但配置复杂,普通用户上手门槛高
- LM Studio:暂时不支持 NPU 加速
- Jan、GPT4All:同样以 CPU/GPU 推理为主
这意味着,即使你买了带 NPU 的 Swift 14 AI,想把 NPU 真正用到大模型推理上,还需要等软件生态跟上。
说白了,这台机器能跑 AI,但定位不是「本地大模型工作站」。它更合适的场景是:调用云端 API、写 prompt 工程、轻量级本地推理验证这类。
四、对比竞品:Swift 14 AI 的位置
要判断值不值得买,得放到市场里看(以下数据来自厂商公开规格或公开评测,实际配置会因地区、批次、价格段不同有差异):
| 维度 | Swift 14 AI | MacBook Air M3 | 联想小新 Pro 14 AI 版 | 华硕灵耀 14 Air |
|---|---|---|---|---|
| 重量 | 约 1.2kg | 约 1.24kg | 约 1.46kg | 约 1.15kg |
| NPU 算力 | 约 47 TOPS(官方标称) | 18 TOPS(Neural Engine) | 约 50 TOPS(官方标称) | 约 47 TOPS(官方标称) |
| 内存上限 | 32GB | 24GB | 32GB | 32GB |
| 接口 | 2C2A+HDMI+MicroSD(部分版本) | 2C+MagSafe | 2C1A+HDMI+SD | 2C1A+HDMI |
| 本地 LLM 推理 | 中等 | 优秀 | 中等 | 中等 |
| 续航 | 中等 | 优秀 | 良好 | 优秀 |
| 价格区间 | 中高 | 高 | 中 | 中高 |
从表格可以看出,Swift 14 AI 的优势在于轻薄与 Windows 生态兼容性(对很多企业软件、专业工具用户很重要),劣势在于 NPU 生态成熟度不如 MacBook Air、接口数量中规中矩。
如果你看重 Windows 生态、Thunderbolt 4 扩展性、对 Intel 平台有兼容性需求,Swift 14 AI 是个合格选项;如果你只看 AI 性能上限,MacBook Air M3 在统一内存架构下的本地 LLM 推理表现依然领先。
五、谁该买,谁该绕
经过这一周的实际使用,我的结论比较清晰:
✅ 适合买的人群
- 经常出差的开发者 / 创作者:1.2kg 重量是真的能减轻通勤负担
- 轻度 AI 需求用户:写作辅助、代码补全、Prompt 工程、轻量推理
- 主力走云端 API 的开发者:本地跑代码、远程调 API,Swift 14 AI 完全胜任
- 企业 Windows 生态用户:对某些仅支持 Windows 的专业软件有刚需
拿捏的住「出差伴侣」这个定位,它是合格的。
❌ 建议绕开的人群
- 想拿它当本地大模型主力机的用户:内存上限、接口扩展性、散热持续性都会成为瓶颈
- 13B 以上模型推理的重度用户:更现实的选择是游戏本或者带独显的创作本
- 专业视频/3D 渲染用户:集显性能有限,外接显卡又有割裂感
- 预算敏感、追求性价比的用户:同价位可以找到性能更强的非 AI 标号轻薄本
🔧 选购建议
如果你已经有一台主力机,把它当第二台便携 AI 终端是合适的;想「一台搞定所有」,接口与性能的天花板会让你失望。
购买时建议关注以下几点:
- 内存配置:优先选 32GB 版本,16GB 在 AI 场景下会很快吃紧
- 存储:512GB 是底线,建议 1TB,AI 模型文件体积都不小
- 保修与售后:轻薄本维修成本高,建议买延保
- 购买渠道:华强北数码广场的价格可能更灵活,但要注意验机和正品保障
六、总结:轻薄与 AI 性能的天花板
以上就是 Swift 14 AI 在 AI 工作流下的实际表现。说真的,轻薄和 AI 性能,目前还是很难兼得。
这台机器的本质是:一台优秀的轻薄 Windows 笔电,附带「AI Ready」的标签。它不是 AI 性能怪兽,但它的便携性和做工确实能打。如果你清楚自己的需求是「出门带着不累、偶尔跑点小模型、大部分时间用云端」,那它是个理性的选择。
如果你期待的是「1.2kg 机身跑 70B 模型、做本地知识库、训练微调」,那现阶段任何轻薄本都做不到,你需要的是工作站级别的设备。
AI 笔电这个品类还在快速演进,2026-2027 年里 Lunar Lake 后续型号、AMD Strix Halo、高通 Snapdragon X Elite 2 都会带来新的变化。现在入手 Swift 14 AI,可以理解为「早买早享受」,但也要接受「早买早过时」的可能。