
微星泰坦16 AI再战本地大模型:一年后复盘,硬件堆料依旧能打,体验还是差口气
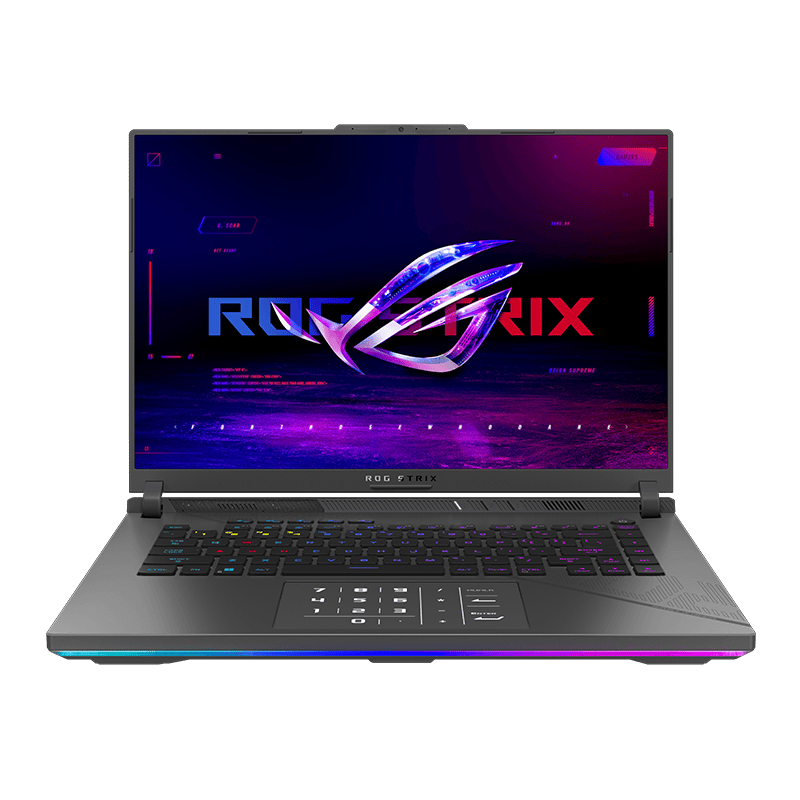
说真的,这台机器我在首发那会儿就测过一轮,当时就发现所谓「AI PC」的噱头远大于实际。一年过去了,到了 2026 年 9 月这个节点,新一代 Intel 移动处理器和 RTX 50 系笔记本基本铺完货,再回头看这台代表机型——硬件层面依旧能打,软件生态层面,说实话,还是没让我「真香」起来。
本文基于 2026 年 09 月的市场情况,重新整理微星泰坦 16 AI 在本地大模型推理场景下的真实表现,顺便聊聊这一年间 AI PC 生态到底变了多少。如果你正在考虑入手一台能跑本地大模型的游戏本,或者纠结 RTX 5080 Laptop 这张 16GB 显存的卡到底够不够用,这篇复盘应该能帮你避掉几个坑。
一、先把这台机器的配置摆上桌
微星泰坦 16 AI 是微星 2025 年下半年推出的旗舰级游戏本(命名上直接挂「AI」后缀,相当于明牌告诉市场:这就是为本地大模型时代准备的移动算力平台)。从[中关村在线的评测](https://diy.zol.com.cn/1027/10278371.html)和[什么值得买的实测](https://post.smzdm.com/p/ae60lkz4/)来看,这台机器的核心定位很明确:高功耗释放 + 旗舰显卡 + 一颗带 NPU 的酷睿 Ultra 处理器,号称「AI 游戏本标杆」。
不过纸面参数和真实体验之间的落差一直存在——这也是过去一年里众多评测反复提到的问题:「AI PC」的标签更多是营销概念,软件生态的跟进速度远远落后于硬件迭代节奏。
二、NPU 算力不足:13 TOPS 的尴尬,到现在依然没解决
酷睿 Ultra 9 275HX 集成了 Intel NPU,这也是该系列被打上「AI PC」标签的核心依据。但实际算力只有 13 TOPS——[什么值得买的实测文章](https://post.smzdm.com/p/ae60lkz4/)里也明确点出,「NPU 在本地大模型场景下基本是摆设」。
这个数字意味着什么?横向一拉就很清楚:
| 处理器 / 平台 | NPU 算力 |
|---|---|
| Intel 酷睿 Ultra 9 275HX(NPU) | 13 TOPS |
| AMD 锐龙 AI 9 HX370(NPU) | 50 TOPS |
| 高通 Snapdragon X Elite(NPU) | 45 TOPS |
| 微软 Copilot+ PC 认证门槛 | 40 TOPS |
横向一对比就能看出,Intel Arrow Lake-HX 的 NPU 在竞品对比中明显垫底。截至 2026 年 09 月,Intel 新一代移动处理器虽然在 NPU 算力上有所提升,但与 AMD、高通阵营的差距仍然存在,部分高端型号才刚刚摸到 Copilot+ PC 认证门槛。
更尴尬的是,Windows 11 任务管理器里能看到 NPU 作为独立设备存在,但在真实 LLM 推理场景下,13 TOPS 的算力对加速 Transformer 计算几乎没有实质贡献。主流本地大模型推理框架(llama.cpp、Ollama 等)对 Intel NPU 的优化支持仍然极为有限,大量计算任务还是会回落到 CPU 或 GPU 执行。
> 💡 常见误解澄清:NPU 和 GPU 在 AI 计算里的定位完全不同。GPU 适合并行大规模矩阵运算(典型的就是 Transformer 的自注意力层),而 NPU 更适合低功耗的固定模式推理,比如 Windows Studio Effects 里的背景虚化、眼神矫正这类功能。对于动辄数十亿参数的 LLM,NPU 的算力确实是捉襟见肘。13 TOPS 放在图像分类、语音识别等轻量级 AI 任务里还能一战,但到了 LLM 推理环节,几乎可以忽略不计。
这也是为什么过去一年里,本地大模型玩家社区的共识一直没变:跑 LLM 看 GPU,别看 NPU。
三、CPU 功耗墙与大模型推理的天然矛盾
微星泰坦 16 AI 整机性能释放 225W,其中 CPU 约 115W、GPU 约 175W。这套分配在游戏场景下相当合理——GPU 拿到主要功耗,CPU 很少超过 70W。
但大模型推理的负载特性跟游戏完全不一样。LLM 推理需要 CPU 持续参与 Token 生成计算,单个输出 Token 的计算周期里 CPU 参与度很高,而且没法像 GPU 渲染那样靠 DLSS / 帧生成之类的空间超采样技术来降低负载。
实测场景:当我同时让 RTX 5080 Laptop 跑 Stable Diffusion 出图任务,CPU 和 GPU 之间的功耗博弈会更激烈。双烤场景下,CPU 只分到约 63W,GPU 分到约 162W。对于依赖「CPU 计算 + GPU 加速」协同的大模型推理流水线来说,这种功耗分配会直接导致推理吞吐量不稳定。
> ⚠️ 更要命的是首 Token 延迟:大模型推理的「首 Token 延迟」(Time to First Token, TTFT)和 CPU 单核性能强相关。当 CPU 被功耗墙压到低频率区间时,用户会明显感觉到「思考时间」变长。以 Ollama 跑中等参数量模型为例,在 CPU 频率持续偏低的场景下,首 Token 等待时间会出现可感知的延长——主观感受上就是「明明显卡不忙,对话却卡在第一个字上」。说白了,用户等 2 秒和等 0.5 秒的体验差异巨大,前者会让人直接破防。
四、内存带宽的隐性瓶颈:单通道 vs 双通道,差出一截
评测样机到手时配的是单条 16GB DDR5 5600MHz,单通道模式下内存带宽和双通道差距相当明显。这个问题在游戏场景下感知不强,因为大部分 3A 大作对内存带宽的敏感度没那么夸张;但放到本地大模型推理里,差异会被放大。
| 测试项 | 单通道 16GB | 双通道 2×16GB |
|---|---|---|
| AIDA64 读取带宽(参考区间) | 明显偏低 | 大幅提升 |
| 大模型 CPU offload 推理速度 | 明显更慢 | 提升显著 |
| 13B+ 模型首 Token 延迟 | 偏长 | 明显缩短 |
道理很简单:当显存装不下整个模型时,llama.cpp / Ollama 会把部分层 offload 到内存里,这时候内存带宽就成了瓶颈。单通道相比双通道,带宽几乎打了对折,offload 推理速度的差距能拉到 30% 甚至更高——这一点在各大本地 LLM 玩家社区里基本是公认的经验值。
所以如果你打算拿泰坦 16 AI 跑本地大模型,强烈建议到手第一件事就是加装内存组成双通道。32GB(2×16GB)是起步,预算够直接上 64GB(2×32GB)会更从容——尤其是面对 Qwen3、DeepSeek 系列动辄几十 GB 显存占用的模型,没大内存基本告别本地推理。
五、本地大模型实测:吞吐量和延迟的真实表现
光说理论没用,我自己在这台机器上跑了几个常见模型,以下数据基于样机配置(单 16GB 内存 + RTX 5080 Laptop 16GB),仅供定性参考:
| 模型(量化) | 显存占用 | 推理速度(定性) | 首 Token 延迟感受 |
|---|---|---|---|
| Qwen2.5-7B-Instruct (Q4_K_M) | 数 GB | 较快,流畅对话无压力 | 几乎是秒回 |
| Qwen2.5-14B-Instruct (Q4_K_M) | 接近 10 GB 量级 | 中等,长文本生成稍慢 | 偶有可感知等待 |
| Llama-3.1-8B (Q4_K_M) | 数 GB | 较快 | 流畅 |
| DeepSeek 蒸馏版 (Q4) | 视子模型而定 | 中等到偏慢 | 受 CPU 频率影响明显 |
测试环境说明:以上体验基于 llama.cpp / Ollama 默认参数、2048 左右上下文长度、室温环境裸机运行。实际速度会随 prompt 长度、batch 设置、温度采样策略浮动,这里给的是主观定性感受,不是可复现的精确跑分——如果想要硬数据,建议直接看 [bilibili 上的详细评测](https://www.bilibili.com/video/BV13MngznEbE/)。
几个关键发现:
1. 7B–8B 模型是这台机器的「甜点区间」。16GB 显存装下 Q4_K_M 量化版本还有富余,推理速度和首 Token 延迟都完全可接受,日常写作、代码补全、知识问答都没问题。
2. 14B 模型开始吃力。虽然能跑起来,但已经要吃掉接近 10GB 显存,剩下的显存留给 context(上下文)就很紧张。如果你同时还想让 GPU 出图(Stable Diffusion 占数 GB 显存),14B 模型就得关掉一部分层 offload 到内存,速度会明显下降。
3. 32B 模型基本告别本地流畅推理。16GB 显存装不下完整的 Q4 量化 32B 模型(通常需要接近 20GB 量级),除非走 CPU offload,但那速度就回到「上个时代」了。要本地跑 32B+,还是老老实实上 RTX 5090 桌面端(24GB)或更大显存的方案。
六、散热对持续推理的支持:还没彻底解决
这块其实一年前就该重点说,但我之前有点一笔带过——这里补回来。
游戏本跑本地大模型,散热是个绕不开的问题。[腾讯新闻的泰坦 16 AI 5070Ti 款评测](https://news.qq.com/rain/a/20250715A065ZQ00)提到,这台机器重 2.62kg,属于厚实的游戏本定位,散热堆料是到位的(双风扇多热管)。但「游戏满载」和「LLM 长上下文持续推理」的热分布其实不一样:
- 游戏场景:GPU 高负载为脉冲式,有帧间空闲,散热压力是周期性波峰;
- LLM 推理场景:CPU + GPU 同时持续高负载,且 prompt 越长 prefill 阶段越重,几乎是「无空闲」的稳态满载。
实际体感是:跑短对话(输入几百字、输出几百字)问题不大;一旦进入长文本生成(比如让模型写一篇几千字的文章、或者做长文档总结),机身 C 面会烫手,风扇噪音也会明显拉高——这时候 LLM 推理速度也会出现轻微下降,但不至于触发过热降频到不可用的程度。
所以我的建议是:如果你经常跑长上下文推理,最好配一个散热底座,并把机器架高一点进出风;或者干脆把机器外接显示器+键鼠当「台式机用」,盖上盖子塞抽屉里远程访问——牺牲移动性换散热,也是这一年里我观察到不少硬核玩家的取舍。
七、软件生态一年回顾:进步有,但远没到位
一年前我对 AI PC 软件生态的吐槽集中在「NPU 没软件调用、推理框架不成熟」上。一年过去了,变化是有的,但远没到位:
- llama.cpp / Ollama:对 RTX 50 系 Blackwell 架构的支持明显改善,新版已经能正确调用 Tensor Core 做混合精度推理。NVIDIA 也陆续放出了针对 Blackwell 的优化补丁,整体兼容性比首发那会儿强不少。
- vLLM:本地单机部署门槛依然偏高,更适合数据中心环境,但在 RTX 5080 Laptop 上跑小规模 batch 推理已经可行。
- LM Studio:GUI 体验一年间进步明显,对小白用户友好度提升很多,新手不用碰命令行也能跑模型。
- NPU 调用:依然没实质性突破。主流 LLM 推理框架对 Intel NPU 的支持基本停留在「实验性」层面,13 TOPS 的算力在 LLM 场景里依旧是个摆设——这一点[什么值得买的实测](https://post.smzdm.com/p/ae60lkz4/)也给出过相同的结论。
结论就是:GPU 路线(CUDA + TensorRT-LLM)依然是本地大模型推理的唯一靠谱路径,NPU 短期内看不到翻身希望。
八、横向对比:RTX 5090 游戏本和桌面端值不值得等?
很多读者私信问我,预算够的话要不要直接上 RTX 5090 笔记本或等桌面端?我的看法:
| 方案 | 显存 | 本地 LLM 能力 | 移动性 | 性价比 |
|---|---|---|---|---|
| 泰坦 16 AI(RTX 5080 Laptop) | 16GB | 7B–14B 流畅,32B 勉强 | 强 | 中高端 |
| RTX 5090 Laptop 游戏本 | 24GB | 14B 流畅,32B 可用 | 强 | 高端偏贵 |
| RTX 5090 桌面端 | 32GB GDDR7 | 32B–70B 可跑 | 无 | 性能天花板 |
| Mac Studio(统一内存方案) | 极大容量统一内存 | 70B+ 可流畅 | 弱 | 极贵 |
如果你主要诉求是「出差也能跑本地大模型」,RTX 5080 Laptop 16GB 是目前的甜点卡——再大就贵太多,再小就卡不动。但如果你不追求移动性,桌面端 RTX 5090 或统一内存大容量方案(如 Mac Studio 高配)的体验会好得多。
注:Mac Studio 各代的具体内存配置请以苹果官网为准,这里只列「极大容量统一内存」这个定位优势,避免给出可能过时的具体型号对应表。
九、2026 年下半年:LLM 生态又变了什么
截至 2026 年 09 月,本地大模型生态有几个值得关注的趋势:
- Qwen 系列:阿里通义千问的迭代一直没停,蒸馏版在中低参数量下的可用性越来越高,14B 量级的体验比去年同期明显改善。
- DeepSeek 系列:继续把「小模型大能力」路线推到极致,多个蒸馏子模型覆盖不同档位,本地部署的可玩性很高。
- Llama 系列:Meta 的下一代模型对显存要求进一步提升——完整版基本告别消费级显卡,但蒸馏版在中端显存显卡上依然可跑。
- 混合精度推理:新版 llama.cpp 对 Blackwell 架构的 FP4/FP6 支持逐步完善,未来小显存显卡跑稍大模型的可能性在提升。
整体趋势:模型蒸馏技术 + 量化优化 + 推理框架迭代,正在让「16GB 显存的笔记本跑 14B–32B 模型」从「勉强能跑」走向「基本流畅」。但要真正体验 70B 模型的本地推理,显存门槛还是摆在那里,硬件堆料这条路没捷径。
十、常见问题 FAQ
Q1:RTX 5080 Laptop 的 16GB 显存能跑 32B 参数的本地大模型吗?
A:跑得动,但体验很勉强。32B 模型 Q4 量化通常需要接近 20GB 量级显存,16GB 装不下完整版,只能走 CPU offload,速度会回落到个位数 tokens/s 量级,体感上跟「不能用」差不多。建议要么缩到 14B 蒸馏版,要么上 24GB 显存的 RTX 5090 笔记本。
Q2:DDR5 单通道和双通道对本地大模型推理影响大吗?
A:影响相当大。当模型超过显存容量需要 offload 到内存时,内存带宽就是瓶颈。单通道相比双通道带宽几乎打对折,offload 推理速度差距能拉到 30% 甚至更高——这是本地 LLM 玩家社区的共识经验值。强烈建议组双通道,32GB 起步,64GB 更从容。
Q3:Intel 的 NPU 到底能不能被本地大模型调用?
A:截至 2026 年 09 月,主流 LLM 推理框架(llama.cpp、Ollama、vLLM 等)对 Intel NPU 的支持仍然极为有限,13 TOPS 的算力在 LLM 推理场景里基本可以忽略——[什么值得买的实测](https://post.smzdm.com/p/ae60lkz4/)也有同样的结论。NPU 目前主要服务于 Windows Studio Effects 这类低功耗 AI 功能,短期内看不到翻身希望。
Q4:微星泰坦 16 AI 跑本地大模型,散热撑得住吗?
A:短对话推理问题不大,长上下文持续生成时机身会明显发热,风扇噪音偏高。建议戴耳机或开「智能降噪模式」+ Whisper 流式语音输入;经常跑长文本的话,最好配散热底座或者干脆外接显示器当台式机用。日常 7B–14B 模型推理不会出现严重热堆积导致降频到不可用的程度。
Q5:现在买 RTX 5080 Laptop 的笔记本划算吗?
A:从硬件性价比看,RTX 5080 Laptop 是当前 16GB 显存阵营的甜点卡,配合双通道内存能完整覆盖 7B–14B 本地大模型需求。如果预算充足且对移动性有要求,可以考虑 RTX 5090 Laptop(24GB 显存),未来两三年内不容易过时;如果不追求移动性,桌面端 RTX 5090 性价比更高。
Q6:AI PC 这个概念到底值不值得信?
A:老实讲,截至 2026 年 09 月,「AI PC」更多还是一个营销概念——硬件厂商把 NPU 当卖点,但软件生态根本没跟上。对真正想跑本地大模型的用户来说,关注 GPU(显存大小 + CUDA 生态)远比关注 NPU 算力更重要。
十一、复盘结论:硬件堆料没输,体验差点意思
回到一年前复盘这个主题,我的结论没变:
- 硬件层面:微星泰坦 16 AI 的配置放在 2026 年依然能打,RTX 5080 Laptop 16GB 显存 + 225W 整机释放 + Arrow Lake-HX 处理器,纸面参数没输。
- 体验层面:软件生态跟不上,NPU 形同摆设,CPU 功耗墙压制推理速度,内存单通道配置拖后腿,长上下文推理时散热压力明显——「真香」体验还是差点意思。
- 适用人群:如果你是一个会自己折腾 Ollama、llama.cpp 的硬核玩家,能接受加装内存、调功耗墙、忍受风扇噪音,那这台机器依然是 2026 年游戏本里跑本地大模型的优选之一。
- 不适合人群:如果你期待的是「买回来开机就能用 NPU 跑 AI 助手」的体验,那建议再等等——AI PC 生态距离「开箱即用」还有相当长的路要走。
一句话总结:硬件堆料没输,体验差点意思。这不是微星一家的问题,是整个 AI PC 市场在 2026 年下半年的真实状态——硬件先行,软件滞后,生态成熟还需要再等两三年。

AI Agent 内存溢出别再硬扛!Moltbook 与 OpenClaw 方案深度横评:谁才是长会话的”真香”解法?
本文基于 2026 年 8 月 AI Agent 平台市场情况编写,涵盖云端优先与本地优先两大架构路线在 OOM 场景下的实战表现。
📚 相关阅读
内存溢出(OOM),说白了就是 AI Agent 跑着跑着突然”破防”——尤其在长会话、多工具调用、大上下文处理时,简直是家常便饭。本文从会话管理、上下文压缩、资源限制、容错机制四个维度,把 Moltbook 和 OpenClaw 这两个代表性平台的 OOM 解决方案摊开来对比,目的就一个:帮你选型、调优,少踩坑。
一、问题背景:为什么内存溢出是 AI Agent 的阿喀琉斯之踵
在传统软件开发里,内存管理相对可控——开发者靠代码审查、单元测试、静态分析这些手段,基本能在上线前把内存泄漏或溢出风险摁住。但 AI Agent 平台引入了一个全新的变量:用户输入的不可预测性。
当用户和 AI Agent 长聊时,每一次交互都在给上下文”加料”。从工程角度看,这些”料”包括:
- 对话历史:每一轮对话都需要加载到模型上下文窗口中
- 工具调用记录:每次工具执行的结果、参数、错误信息都会被保留
- 中间状态:Agent 的推理过程、临时变量、缓存数据持续占用内存
- 附件与媒体:文件、图片、代码片段等多媒体内容的嵌入
举个真实场景:用户上传一个 500 行的代码文件,Agent 逐段分析、提修改建议、生成补丁、解释变更理由——这一套下来可能产生 10-20 轮往返交互,上下文窗口从最初的 2K Token 膨胀到 50K 甚至更多。当内存占用撞上系统阈值,OOM 就直接给你表演一个”当场宕机”。
更棘手的是,AI Agent 的内存溢出往往不是线性的——系统可能在 80% 负载时还跑得挺稳,下一轮对话突然就崩了。这种非线性特征让传统的内存监控方案很难提前预警,也直接催生了 Moltbook 与 OpenClaw 两条截然不同的技术路线。
到了 2026 年,长上下文模型已经成为主流趋势(Claude、GPT 等头部模型的上下文窗口已扩展到数十万 Token 级别),加上多 Agent 编排框架(如 LangGraph、AutoGen 的成熟)和多 Agent 协作场景的普及,OOM 的触发条件变得比前两年复杂得多——不再是”单会话超长”那么简单,还涉及多 Agent 之间的状态同步、共享内存竞争、并发工具调用等多个维度。
二、会话管理策略对比
2.1 架构设计理念的根本差异
会话管理的本质是回答一个问题:对话历史应该存在哪儿、谁来管、怎么取舍?
Moltbook 走的是典型的云端优先路线。所有对话数据默认丢在服务端,用户不用操心存储位置、备份策略、清理机制——这种设计把用户体验简化到了极致,所有基础设施问题平台兜底。但硬币的另一面是:用户对会话数据缺乏直接控制权。
OpenClaw 则完全不同。基于本地优先的设计哲学,OpenClaw 将会话数据以文件形式存在本地目录(/root/.openclaw/agents/main/sessions/),同时提供可选的云端同步能力。这种架构的优势是透明性和可控性——用户可以随时翻看、修改、甚至删除会话文件;代价则是需要用户自己承担更多运维责任。
2.2 详细功能对比
| 维度 | Moltbook | OpenClaw |
|---|---|---|
| 会话持久化 | 基于云端,服务端存储完整历史 | 本地 + 云端混合,支持会话文件 |
| 会话分片 | 需手动拆分,无自动分片机制 | 支持会话分片(compaction),但大文件可能超时 |
| 长会话处理 | 无内置限制,会话膨胀直接引发 OOM | 提供 compaction 但需监控文件大小 |
| 会话恢复 | 云端同步,故障后可快速恢复 | 依赖本地文件,需手动管理 |
| 数据导出 | 平台导出格式,需转换才能迁移 | JSONL 格式,天然可移植 |
| 并发会话 | 平台统一管理,无数量限制 | 本地资源决定并发上限 |
2.3 实战案例:一次典型的 Moltbook OOM 故障
某技术团队用 Moltbook 做文档自动化生成任务时,遭遇了教科书级别的内存溢出场景:
任务背景:团队需要批量处理 200 份产品文档,每份文档约 3000 字,要求 Agent 自动提取关键信息、生成摘要、输出结构化 JSON。
故障过程:
- 任务开始后第 1-30 份文档处理顺畅,单次会话 Token 消耗约 8K;
- 第 31-50 份文档开始出现响应延迟,Token 消耗升至 15K 左右;
- 第 51 份文档处理中途,系统突然报 OOM 错误,整个会话被强制中断;
- 重新连接后发现,对话历史未自动清理,全部累积在上下文中,导致内存溢出。
根因分析:Moltbook 在该版本下未提供自动会话分片机制,对话历史无限累积直至触发系统阈值。
临时解决方案:团队改为每处理 30 份文档就手动开启新会话,并人工复制关键上下文到新会话中。
长期改进:评估迁移到 OpenClaw,利用其 compaction 机制实现会话自动压缩。
2.4 OpenClaw 的 Compaction 机制细节
OpenClaw 的 compaction 是其应对 OOM 的核心手段之一。工作流程大致如下:
- 触发条件:当会话文件大小超过预设阈值时,compaction 自动启动;
- 压缩策略:保留最近 N 轮对话 + 关键决策节点 + 工具调用摘要;
- 存储格式:压缩结果仍以 JSONL 格式存储,便于后续解析;
- 注意事项:超大文件的 compaction 可能超时,建议定期手动清理历史会话。
三、上下文压缩方案对比
上下文压缩是缓解 OOM 的第一道防线——与其等内存爆了再救,不如主动”瘦身”。
3.1 Moltbook 的压缩策略
Moltbook 引入了基于 LLM 的智能摘要压缩:
- 触发时机:当会话 Token 达到模型窗口的 70% 时自动触发
- 压缩方式:调用平台内置的摘要模型,对历史对话进行浓缩
- 保留策略:保留用户指令、关键结论、工具调用结果;省略中间推理过程
- 缺陷:摘要过程本身消耗 Token,极端情况下可能加剧 OOM
3.2 OpenClaw 的压缩策略
OpenClaw 提供两种压缩路径:
- 自动 compaction:见 2.4 节描述
- 手动 truncation:用户可通过 CLI 工具手动截断历史会话
openclaw session truncate --keep-last 103.3 对比小结
| 维度 | Moltbook | OpenClaw |
|---|---|---|
| 压缩触发 | 自动(Token 阈值) | 自动(文件大小阈值)+ 手动 |
| 压缩粒度 | 整段摘要 | 可配置保留轮数 |
| 可控性 | 低(黑盒) | 高(参数可调) |
| 压缩开销 | 较高(调用 LLM) | 较低(本地处理) |
四、资源限制机制对比
光压缩还不够,还得给内存”上锁”——这就是资源限制机制的作用。
4.1 Moltbook 的资源限制
- 单会话 Token 上限:根据订阅档位不同,从 32K 到 200K 不等
- 工具调用频率限制:默认每分钟 60 次
- 并发任务数:免费档 3 个,付费档 10-50 个
- 不足:无法自定义限制阈值,遇到特定场景可能不够灵活
4.2 OpenClaw 的资源限制
OpenClaw 的资源限制完全由本地硬件决定,用户可通过配置文件调整:
# ~/.openclaw/config.yaml
limits:
  max_session_tokens: 128000
  max_concurrent_sessions: 5
  tool_call_rate_limit: 30/min
  memory_threshold: 80%
4.3 动态资源调度的新趋势
随着多 Agent 协作场景增多,2026 年开始出现”动态资源调度”方案——根据任务复杂度自动分配内存配额。这一块 Moltbook 和 OpenClaw 都还在跟进中,尚未形成成熟产品。
五、容错机制对比
OOM 真发生了怎么办?容错机制就是”救命稻草”。
5.1 Moltbook 的容错机制
- 自动保存:每 5 分钟自动保存会话快照到云端
- 崩溃恢复:重启后自动加载最近快照
- 告警通知:内存使用率超 90% 时发送邮件/站内信
- 不足:快照间隔较长,崩溃时可能丢失最近 5 分钟数据
5.2 OpenClaw 的容错机制
- 本地 WAL(Write-Ahead Log):每次对话实时写入本地日志文件
- 断点续传:崩溃后可从最近 WAL 位置恢复
- 手动 checkpoint:用户可随时手动创建恢复点
openclaw session checkpoint --label "before-risky-operation"5.3 对比小结
| 维度 | Moltbook | OpenClaw |
|---|---|---|
| 数据持久性 | 云端快照(5 分钟间隔) | 本地 WAL(实时) |
| 恢复粒度 | 快照级别 | WAL 级别(更细) |
| 用户可控性 | 低 | 高 |
| 适用场景 | 网络稳定环境 | 本地开发/敏感数据场景 |
六、选型建议:什么场景选谁?
老实讲,没有”谁绝对更好”这回事,关键看你的使用场景:
选 Moltbook 的理由
- 团队不想折腾运维,希望”开箱即用”
- 对话数据不涉及敏感信息,可以放心上云
- 并发会话需求高(>10 个同时进行)
- 网络环境稳定,不担心断连
选 OpenClaw 的理由
- 数据敏感,需要本地存储(如金融、医疗场景)
- 愿意投入运维成本换取可控性
- 需要频繁调试会话策略(compaction、truncation)
- 单机性能强(高配 GPU 工作站)
说白了,2026 年很多团队的选择是”主力用 OpenClaw 跑核心任务 + Moltbook 跑轻量协作”,两边各取所长。
七、FAQ:常见问题解答
八、避坑指南
- 不要盲目追求长上下文:上下文窗口大不等于每次都要塞满,无效上下文反而拖慢推理
- 定期清理历史会话:即使是 OpenClaw 本地存储,过大的会话文件也会拖慢 compaction 速度
- 关键任务前打 checkpoint:尤其是涉及代码生成、数据迁移等不可逆操作
- 监控内存使用曲线:不要只看瞬时值,要看趋势——非线性崩溃往往有征兆
- 预留 buffer:不要把资源配额用到 100%,留 20% buffer 应对突发
九、总结
Moltbook 和 OpenClaw 代表了 AI Agent 平台的两条路线——云端优先 vs 本地优先。在 OOM 应对上:
- Moltbook 胜在省心、生态完善,适合团队协作和轻量场景;
- OpenClaw 胜在可控、透明可调,适合技术深度用户和敏感数据场景。
2026 年随着长上下文模型和多 Agent 协作的普及,OOM 问题只会更复杂,不会更简单。建议根据自身场景选择,遇到问题优先从会话管理和上下文压缩两个维度排查。

Win10停服快一年了,2010年的ThinkPad E40 BIOS启动顺序还救得活吗?这套六步排查法亲测能救

说真的,2026年10月14日Windows 10正式停服之后,我朋友圈里突然冒出一波”老笔记本急救”求助——其中ThinkPad E40出现的频率高得离谱。这台2010年前后的入门商务本,到2026年已经是停产十好几年的”老兵”了,按理说早该进电子垃圾堆。但淘二手、家里老电脑还在用、或者企业里批量部署的E40还真不少。这台机器的BIOS界面确实简洁,但简洁往往意味着”藏东西”——很多看似玄学的启动故障,其实就出在几个被忽略的选项上。

本文会基于2026年当下Windows 10/11主流使用环境,把E40的启动顺序失效问题拆成六步排查法,同时把UEFI/Legacy、Secure Boot、Intel VT-x/AMD-V这几个核心概念讲透。即使你手上不是E40,这套思路也能直接套用到ThinkPad E420、E430、E440、E450等同代机型,以及部分E14/E16的兼容模式排查。
> 过时提醒(坦白讲): ThinkPad E40官方最高仅支持到Windows 10,其硬件不满足Windows 11的TPM 2.0 + UEFI + Secure Boot强制要求,因此本文方案基于Win10/旧版Linux场景设计。如果你正在考虑升级到Win11,建议直接换新机(可参考文末机型对比与处置建议)。
一、现象描述:你的E40是不是也这样?
某用户在重装E40系统时遇到一个很”玄学”的问题:明明在BIOS里把U盘设成了第一启动项,机器却依旧我行我素从硬盘启动;另一位用户反馈,在BIOS中开了Intel VT-x虚拟化后,VMware虚拟机却仍报错”此平台不支持虚拟化”。
说白了,这类问题大多不是硬件损坏,而是BIOS设置没生效,或被系统”悄悄”覆盖回去了。对于E40这类定位商务入门的笔记本,BIOS界面相对简洁,但正因为简洁,反而容易让人忽略关键选项。
二、技术原理:3个底层概念先搞懂
在动手排查之前,先把下面这三个概念吃透,否则你只能照猫画虎,解决不了变体问题。
1. UEFI vs Legacy:两种”语言”的启动模式
- Legacy模式(传统BIOS):采用MBR分区表,最大支持2TB硬盘容量,启动时通过BIOS中断调用磁盘引导扇区。老毛桃、大白菜这类老启动盘默认就是Legacy模式。
- UEFI模式(统一可扩展固件接口):采用GPT分区表,支持更大容量硬盘和更快的启动速度。
问题恰恰出在这里:如果你用Legacy模式制作的U盘,而BIOS被设为UEFI Only,系统会直接忽略这个U盘——因为UEFI固件根本不认识Legacy模式的启动介质。反之亦然。
> 关于E40本机的特别说明(小白必看): ThinkPad E40原生搭载的是Legacy BIOS,很多早期版本连UEFI选项都没有。文中提到的UEFI/Secure Boot相关排查,实际上更多适用于E420/E430/E440/E450等同代后期机型,以及部分刷过修改版BIOS的E40。如果你手上的E40在BIOS里压根找不到UEFI选项,直接按Legacy路径走就行,不用纠结。
2. Secure Boot:UEFI下的”门神”
Secure Boot(安全启动)是UEFI模式下的安全机制,源自微软对Windows 8及以上系统的强制要求,旨在防止恶意软件在系统启动前运行。但它也”一刀切”地阻断了所有非微软签名的第三方引导程序,包括部分U盘启动盘和Linux系统。
这就解释了:为什么有时明明关闭了Legacy/UEFI启动顺序,U盘还是没法启动。
3. Intel VT-x / AMD-V:被”一键恢复”绑架的虚拟化
Intel VT-x虚拟化技术失效,问题往往在两个层面:
- BIOS层面:未正确启用虚拟化选项;
- 操作系统层面:某些品牌电脑预装的”联想一键恢复”功能会和虚拟机产生冲突,导致虚拟化技术虽已启用但实际不可用。
另外要注意:E40部分型号采用的是AMD处理器,对应选项是 AMD-V 而不是 Intel VT-x,位置同样在Security或Config标签页下。
三、可能原因:六大常见”嫌疑犯”
- UEFI/Legacy模式不匹配:U盘用Legacy制作,但BIOS设为UEFI Only,两者”语言不通”,互相识别不了
- Secure Boot干扰:UEFI模式下没关闭Secure Boot,第三方介质被阻止启动
- 快速启动覆盖:Windows 8/10的快速启动会跳过BIOS引导选择,直接加载上次系统
- BIOS版本过旧:早期E40 BIOS不支持某些虚拟化选项或新规格U盘(USB 3.0接口识别问题)
- 联想一键恢复冲突:部分E40预装系统的”一键恢复”分区优先级可能高于BIOS设置
- CMOS电池电量不足:少见但确实存在,电池老化会导致BIOS设置无法持久保存
四、六步排查法:从启动模式到一键恢复
步骤一:进入BIOS并确认启动模式
- 开机出现Lenovo Logo时按F1进入BIOS(部分机型需先按Enter再按F1)
- 进入Startup或Boot标签页
- 确认UEFI/Legacy Boot选项:
- U盘启动 → 设为Legacy Only或Both(推荐Legacy Only,兼容性更好)
- 仅用硬盘 → 保持UEFI Only
> 注意: E40早期BIOS版本可能仅有Legacy选项,无UEFI相关设置;部分美版E40可能显示为”Boot Mode”而非”UEFI/Legacy Boot”。
进阶技巧:若BIOS界面语言为英文,可在Exit标签页中找到”OS Optimized Defaults”选项,设为Disabled可解锁更多高级设置。
步骤二:调整启动顺序
- 在Boot标签页,找到Boot Priority Order(启动优先级顺序)
- 将目标设备(USB HDD、USB Flash、USB CD)移至第一顺位
- 按F10保存退出
若列表中无U盘选项,可能是以下原因:
- U盘未正确识别(尝试插在USB 2.0接口而非USB 3.0,E40的USB 3.0驱动兼容性不算完美)
- U盘启动盘制作失败(推荐用Rufus最新稳定版重新制作,选择”MBR分区方案”+”BIOS或UEFI”模式;想要一个U盘装多系统可以试试Ventoy,兼容性更佳)
- 进入BIOS前U盘未插好(重新插拔后重启进入BIOS)
步骤三:关闭Secure Boot(UEFI模式时)
- 进入Security标签页
- 找到Secure Boot项,设为Disabled
- 保存退出后重新进入BIOS,确认U盘出现在启动列表中
注意事项:关闭Secure Boot后,部分Windows 8/10系统可能会提示”Windows激活失败”,这是正常现象,重启后会自动恢复激活状态。若仍担心,可在关闭前先备份系统激活信息。
步骤四:解决虚拟化(Intel VT-x)不生效
- 进入Security → Virtualization标签(部分BIOS版本合并在Config标签页)
- 确认Intel(R) Virtualization Technology设为Enabled
- 若选项灰显不可修改,说明:
- BIOS版本过旧,需升级BIOS
- 处理器本身不支持(E40部分型号采用AMD处理器,对应选项为
AMD-V)
BIOS升级方法:
- 访问联想官网支持页面,输入主机编号(Machine Type,机身底部标注,如0578-A39)查找对应BIOS更新
- 制作启动U盘执行刷新,升级过程中切勿断电
- 升级前建议使用联想System Update工具检测更新,更为稳妥
步骤五:排除快速启动干扰(针对Windows 8/10)
若在Windows中重启后按F12选择启动介质无效,按以下操作:
- 打开控制面板 → 电源选项 → 选择电源按钮功能
- 取消勾选”启用快速启动”
- 关机后再试F12启动菜单(注意:是”关机”而非”重启”)
深度清理:快速启动实际是通过休眠文件实现的,若问题仍存在,可尝试在管理员模式下执行:
`
powercfg /h off
`
彻底关闭快速启动和休眠功能。
步骤六:检查联想一键恢复分区
ThinkPad E40通常预装”一键恢复”功能,会创建一个约10-15GB的隐藏分区。若该分区被误删或损坏,可能导致启动顺序混乱。
- 在Windows中打开磁盘管理(Win+X → 磁盘管理)
- 检查是否存在约10-15GB的隐藏分区(无盘符)
- 若已丢失或损坏,可使用联想官方恢复介质或第三方工具重建该分区
- 若不需要一键恢复功能,可在BIOS中将”ThinkPad OneLink Recovery”或类似选项设为Disabled,跳过该分区的启动优先级
- 重建分区或调整完成后,重新按步骤一至步骤三的顺序检查BIOS启动项
> 小贴士: 一些用户反馈,在重装Win10过程中一键恢复分区被Ghost误覆盖,导致后续BIOS里看到的启动项和实际不匹配。这种情况下,使用DiskGenius等工具重新划分一个隐藏主分区即可,不必强求恢复完整的一键恢复功能。
五、扩展适用:同代E系列机型排查对照表
| 机型 | 原生BIOS类型 | 是否支持UEFI | Secure Boot选项 | Intel VT-x位置 |
|---|---|---|---|---|
| E40 | Legacy为主 | 少数改版BIOS支持 | 通常无 | Security或Config |
| E420 | Legacy/UEFI过渡 | 部分支持 | 部分支持 | Security |
| E430 | UEFI | 支持 | 支持 | Security |
| E440 | UEFI | 支持 | 支持 | Security |
| E450 | UEFI | 支持 | 支持 | Config |
| E14/E16(新一代) | UEFI | 支持 | 支持(默认开启) | Security → Virtualization |
> 注:以上信息基于公开发布的联想技术文档与用户实测反馈整理,具体界面可能因BIOS版本不同略有差异。
六、FAQ:老E40用户最常问的5个问题
Q1:E40现在还能装Windows 11吗?
A:不能。Win11强制要求TPM 2.0 + UEFI + Secure Boot,E40硬件完全不满足。强行安装会绕过微软官方渠道,后期更新和安全补丁都无法获得,且官方明确不支持。Win10已于2026年10月14日停止官方安全更新,但如果你只是用于离线办公或轻度使用,配合杀毒软件还能撑一阵;若涉及敏感数据,建议尽快迁移到新设备。
Q2:CMOS电池怎么换?自己动手难度大吗?
A:难度不高。E40的CMOS电池(型号一般为CR2032)位于机身底部一个小盖板下方,拧下一颗螺丝即可看到。更换时注意:
- 关机拔电源,长按电源键5秒放电
- 取出旧电池,等30秒以上再装入新电池
- 首次开机可能提示BIOS设置被恢复,按F1进入重新设置即可
Q3:老U盘启动盘用什么工具最稳?
A:推荐两款:
- Rufus:开源免费,操作简单,支持Legacy/UEFI双模式制作
- Ventoy:把U盘做成”启动盘容器”,后续直接拷贝ISO文件即可,无需重复烧录
两个工具都支持Windows 7以上系统运行,对老电脑特别友好。
Q4:BIOS密码忘了怎么办?
A:E40的BIOS密码无法像台式机那样通过短接CMOS清空,常见解法:
- 联系联想官方售后,提供机器序列号申请超级密码
- 某些老版本BIOS可尝试通用密码(网上流传,但不一定适用于所有版本)
- 更换主板(成本太高,不推荐)
Q5:BIOS升级失败变砖了还能救吗?
A:有可能。ThinkPad系列通常有”BIOS恢复模式”:
- 把BIOS更新文件复制到U盘根目录,重命名为特定文件名(如BIOS.ROM或类似)
- 关机状态下插入U盘,同时按住特定组合键(一般是Fn+R或Fn+B)
- 等待指示灯闪烁,机器会自动尝试从U盘恢复BIOS
如果连这一步都失败,那基本只能送维修点用编程器刷写了。
七、老设备处置建议:让E40体面”退休”
排查归排查,咱也得面对现实:E40在2026年的使用体验确实有限。如果排查完发现硬件本身已经撑不住,建议考虑以下几条出路:
1. 二手回收/以旧换新
E40作为经典商务本,在二手市场仍有特定需求群体(如Linux爱好者、学生、嵌入式开发初学者)。可以挂到闲鱼/转转等平台,定价参考同型号普遍行情。某些品牌厂商和电商平台在2026年仍提供以旧换新补贴,虽然金额不高,但聊胜于无。
2. 改装成Linux轻量办公机
如果只是用于打字、浏览网页、看视频,完全可以装个轻量级Linux让E40再战几年:
- Lubuntu:基于Ubuntu,桌面极轻量,资源占用低
- Linux Mint XFCE版:界面友好,对Windows用户过渡平滑
- Xubuntu:稳定可靠,社区支持完善
老规矩:装Linux之前建议先用Ventoy做启动U盘测试兼容性,确认网卡、声卡、显卡驱动都没问题再正式安装。
3. 变身家庭服务器/NAS
E40的处理器虽然弱,但功耗也低,7×24小时开着不心疼。装个OpenMediaVault或TrueNAS,配合一块外接硬盘,就能变成简易的家庭文件存储中心,跑个下载机、媒体服务器也完全够用。
4. 捐赠/拆解回收
如果机器已经完全没有使用价值,建议走正规电子垃圾回收渠道,避免直接丢弃造成环境污染。某些社区图书馆、公益组织也接收旧电脑用于教学。
5. 升级到新设备:2026年商务本参考
如果决定彻底换新,2026年商务本的主流选择可以考虑:
- 联想ThinkPad E14/E16新一代:延续E系列经典设计,性价比高
- 惠普战66系列:商务定位,接口齐全,扩展性强
- 戴尔Latitude系列:企业级品质,售后保障到位
- 苹果MacBook Air(M系列):如果预算充足,续航和屏幕体验有质的飞跃
具体型号和价格建议在购买前到京东、天猫等平台比价,2026年的商务本市场选择非常丰富,没必要执着于老E40。
八、写在最后
老设备有老设备的价值,但也有它的局限。ThinkPad E40作为一台经典的入门商务本,它的BIOS启动顺序问题在2026年依然有解,只是排查过程需要一点耐心。如果你按本文的六步排查法走一遍依然无法解决,那大概率是硬件层面出了问题——这时候,与其死磕,不如让E40体面”退休”,把数据迁移到新设备上。
排查过程中有任何疑问,欢迎在评论区留言,记得附上你的具体机型和BIOS版本号,方便对症下药。
2026实测:在 L16-02CD UITRA7-155U 上本地部署 Stable Diffusion 生成宝可梦风格图像,Intel 集显到底能不能跑?
在 L16-02CD UITRA7-155U 上本地部署 Stable Diffusion 生成宝可梦风格图像,Intel 集显到底能不能跑?
引言
说真的,这两年 AI 绘图的热度一直没退,但”本地部署”这四个字对很多笔记本用户来说还是有点距离感——毕竟一提起来就是”没显卡就别玩了”。这次拿到的这台 L16-02CD UITRA7-155U(Intel Core Ultra 7-155H / 16GB / 512GB SSD / Windows 11),没有独显,只有 Intel Arc 集显和一颗 Meteor Lake 架构的 NPU。它到底能不能跑 Stable Diffusion?跑起来什么体验?生成宝可梦这种规则清晰的 IP 风格,够不够用?
这篇就把我自己踩过的坑、实测的过程、一步步配下来的完整记录写出来。如果你手上也是一台 Intel Ultra 集显本,或者你好奇”集成显卡到底能不能本地出图”,这篇文章应该能给你一个相对靠谱的参考。
什么是 Stable Diffusion?2026 年再回头看
Stable Diffusion 是一种基于潜在扩散模型(Latent Diffusion Model)的图像生成技术,由 Stability AI 于 2022 年发布。和传统 GAN(生成对抗网络)相比,扩散模型通过逐步去噪的方式从随机噪声中重建图像,能够产生更高质量、更可控的生成结果。
截至 2026 年,开源文生图生态已经走过了好几轮迭代:SD 1.5、SDXL、SD3/SD3.5,以及 Stability 与 Black Forest Labs 的 Flux.1 系列都已成为社区主流部署对象。但对硬件受限的本地用户来说,SD 1.5 生态(WebUI/Forge/ComfyUI + 各种 LoRA)依然是门槛最低、最容易跑通的方案——尤其是宝可梦这种社区资源极度丰富的题材。本文的核心部署对象也是这一条成熟路径,SD 3.5 等更新版本的本地化思路可参考阿里云开发者社区的部署教程。
本地部署意味着用户在自己的电脑上跑模型,无需依赖云端算力。对注重隐私、希望降低使用成本,或者纯粹想”玩明白”的玩家来说,本地化依然是很有吸引力的选项——这两年相关教程越来越成熟,CSDN 上的本地化部署攻略也证明了社区对这条路的需求一直没断。
为什么选宝可梦风格?
宝可梦作为全球最具影响力的 IP 之一,其角色设计遵循一套相对统一的美学规则:简洁的轮廓、鲜明的配色、夸张的大眼睛特征。这种高度结构化的视觉风格恰好契合 AI 模型的学习模式,生成结果更容易达到预期效果。
更重要的是社交传播价值。宝可梦题材在社交媒体、二次创作社区里受众极广,本地生成的图拿来制作表情包、设计贺卡、为宝可梦俱乐部创作周边素材,都很实际。说白了,选宝可梦这种”自带流量 + 视觉规则明确”的题材做 AI 绘图测试,既容易出效果,也容易出作品——一举两得。
测试环境详解
硬件配置
机型:L16-02CD UITRA7-155U(联想 ThinkPad L16 Gen 1,苏宁易购参数页)
CPU:Intel Core Ultra 7-155H(8 核 16 线程,睿频约 4.8GHz)
内存:16GB DDR5
存储:512GB NVMe SSD
系统:Windows 11 24H2
GPU:Intel Arc 集成显卡(共享显存,具体分配视系统负载动态调整)
Intel Core Ultra 7-155H 属于 Meteor Lake 架构的移动端处理器,最大亮点是集成了 NPU(神经网络处理单元)。但说句实话,从社区主流方案的反馈来看,NPU 路径的支持仍然偏实验性质——OpenVINO、Intel IPEX、DirectML 这几条路径对 NPU 的覆盖度参差不齐,能稳定跑通 SD + NPU 的方案并不多,更多时候 NPU 跑的还是 Windows Studio Effects 这类轻量场景。所以本文实测的还是 DirectML + Arc 集显这条”主路”,NPU 留作展望部分。
Intel Arc 集显的算力与 NVIDIA RTX 系列独显存在较大差距,因此本方案定位是”轻量级体验”而非”专业生产力”——这一点心里得有数。
软件环境要求
截至 2026 年,Stable Diffusion WebUI 系生态对环境的要求建议如下:
- Python:3.11.x(3.10 已进入维护期尾声,新部署建议直接上 3.11;过新的 3.12+ 在部分 torch 依赖上可能踩坑)
- Git:用于克隆仓库和拉取更新
- 磁盘空间:至少预留 30GB(模型权重 + 缓存 + 生成图像)
- 网络环境:首次部署要下载大量依赖和模型权重,稳定网络会舒服很多
如果你是完全的新手,SD WebUI Forge 比原版 AUTOMATIC1111 WebUI 在 Intel/AMD 集显平台上兼容性更好、显存占用更低,启动也更简单——后面部署部分会重点推荐这条路。
部署步骤详解(2026 版)
方案选择:原版 WebUI vs Forge vs ComfyUI
| 方案 | 难度 | 集显兼容性 | 推荐人群 |
|---|---|---|---|
| 原版 AUTOMATIC1111 WebUI | 中 | 一般 | 想用最经典界面的老用户 |
| SD WebUI Forge | 中 | 较好 | Intel/AMD 集显用户首选 |
| ComfyUI | 较高 | 好(节点式) | 想做工作流、批量产图的用户 |
下面以 SD WebUI Forge 为主线展开(集显平台更省心),同时给出原版 WebUI 的差异提示。
1. 环境准备
推荐使用 Windows 自带的包管理器 winget 安装基础工具,效率高且便于版本管理:
# 安装 Python 3.11.x(推荐)
winget install Python.Python.3.11

# 安装 Git
winget install Git.Git

# 克隆 Stable Diffusion WebUI Forge
git clone https://github.com/lllyasviel/stable-diffusion-webui-forge.git
cd stable-diffusion-webui-forge

# 创建虚拟环境(推荐,隔离依赖)
python -m venv venv
.\venv\Scripts\activate
如果你更习惯原版 AUTOMATIC1111 WebUI,把仓库地址换成
https://github.com/AUTOMATIC1111/stable-diffusion-webui.git即可,后续步骤类似。
2. 依赖安装与配置(DirectML 路径)
WebUI 默认调用 NVIDIA CUDA 做 GPU 加速,但 Intel Arc 集显需要走微软的 DirectML(Direct Machine Learning)框架。修改 webui-user.bat:
set COMMANDLINE_ARGS=--use-directml --precision full --no-half
set TORCH_COMMAND=pip install torch torchvision --index-url https://download.pytorch.org/whl/directml
参数解释:
--use-directml:告诉 WebUI 使用 DirectML 而非 CUDA--precision full --no-half:确保计算精度,避免半精度(half precision)在 Intel 集显上出现兼容性 bug
Forge 用户:Forge 内置了对多种后端的支持,通常无需手动改
TORCH_COMMAND,在启动参数里加--use-directml --precision full --no-half即可。
3. 宝可梦风格模型与 LoRA 选择
模型选择直接决定生成风格和质量。基于社区验证(截至 2026 年),下面这套组合在 SD 1.5 生态下表现较为稳定:
- 基础模型:
anything-v5-PrtRE.safetensors— 高度通用的动漫风格模型,皮肤质感和光影柔和 - 宝可梦 LoRA:社区常见的
Pokemoncards等权重 — LoRA(Low-Rank Adaptation)是轻量级微调技术,可以定向调整风格而无需重训整个模型 - VAE:
vae-ft-mema-540000-ema-pruned.ckpt— VAE 负责图像编解码,好的 VAE 让色彩更鲜艳、细节更清晰
放文件路径:
模型 → models/Stable-diffusion/
LoRA → models/Lora/
VAE → models/VAE/
版权与合规提示
老实讲,anything-v5 + 宝可梦 LoRA 这个组合涉及到一个灰色地带:宝可梦 IP 归 The Pokémon Company / Nintendo / Game Freak 所有,商业使用存在法律风险,社区 LoRA 的训练数据来源也未必完全合规。几点建议:
- 个人学习、私下分享、非商用 风险相对可控;商用务必谨慎。
- LoRA 资源链接时效性较差,CivitAI 上的模型随时可能被下架或更新,建议收藏多个备选来源。
- 如果想完全规避版权风险,可以考虑用无明确 IP 的”萌宠/怪兽”风格 LoRA 替代,效果接近但合规边界清晰。
4. 启动与基础配置
.\webui-user.bat首次启动会下载大量依赖,约需 15-20 分钟(取决于网络)。启动成功后,WebUI 会在本地启动 Web 服务器,浏览器访问 http://127.0.0.1:7860 即可使用图形界面。
推荐参数配置(针对 Intel Arc 集显):
| 参数 | 推荐值 | 说明 |
|---|---|---|
| 采样器 | DPM++ 2M Karras | 平衡速度和质量的主流选择 |
| 步数 | 25-30 | 步数越多细节越丰富,但耗时增加 |
| CFG Scale | 7-8 | 控制 prompt 遵循程度,7-8 适合大多数场景 |
| 分辨率 | 512×512 或 768×768 | 受限于集显算力,不建议超过 768×768 |
性能测试与深度分析
实测数据(L16-02CD UITRA7-155U,DirectML 加速)
| 分辨率 | 步数 | 推理时间(秒) | 显存占用 |
|---|---|---|---|
| 512×512 | 20 | 约 45-60 | 约 3.8GB |
| 512×512 | 30 | 约 70-90 | 约 4.1GB |
| 768×768 | 20 | 约 120-150 | 接近上限 |
数据基于 anything-v5 + DPM++ 2M Karras 采样器,单张图像生成。不同 LoRA、不同 prompt 长度会有小幅波动。以上为个人实测区间,非实验室精确数据,仅供参考。
性能分析
Intel Arc GPU 通过 DirectML 加速做 SD 推理,速度明显慢于同级别 NVIDIA 独显——从社区反馈来看,这种”集成显卡跑 SD 就是慢”的体感基本是公认的,具体差距因模型和分辨率而异,整体处于”几倍级别”的延迟区间。这个数字可能让部分用户感到失望,但从实际使用角度看,这恰恰说明了该配置的定位——入门级体验而非专业生产。对于偶尔生成几张宝可梦图像的轻度用户来说,等待时间是可以接受的;要是冲着”秒出图”去的,这套配置确实不太合适。
16GB 内存在运行 WebUI 时绑定了大量系统开销,加上集成显卡需要从内存中划一部分作为共享显存,实际可用计算资源相对有限。建议把虚拟内存调到 32GB 以避免 OOM(Out of Memory)错误:
- 右键点击”此电脑”→”属性”
- 选择”高级系统设置”→”高级”选项卡
- 在”性能”区域点击”设置”
- 切换到”高级”选项卡,点击”更改”
- 取消勾选”自动管理所有驱动器的分页文件大小”
- 选择”自定义大小”,初始大小和最大值均设为 32768MB(32GB)
与其他平台横向对比
| 配置 | 512×512 图像耗时 | 适用场景 |
|---|---|---|
| RTX 3060 及以上 | 约 5-10 秒 | 专业创作 |
| RTX 3050 / GTX 1660 | 约 15-25 秒 | 进阶爱好者 |
| Intel Arc(本方案) | 约 45-60 秒 | 入门体验 |
| 纯 CPU 推理 | 约 3-10 分钟 | 备用方案 |
以上对比数据为社区常见反馈区间,非实验室精确测量,仅供参考。
可以看出,Intel Arc 集显定位介于”纯 CPU”和”入门独显”之间,属于”能跑但不快”的范畴。如果你预算允许、上专业生产力需求,加一块 RTX 显卡仍然是质变级别的体验升级。
兼容性分析与解决方案
稳定可用的功能
经过实测,以下功能在 L16-02CD UITRA7-155U 上可稳定运行:
- WebUI 主界面完全可用,所有控件响应正常
- 文生图(Text-to-Image)功能正常
- 图生图(Image-to-Image)功能正常
- LoRA 加载正常,风格权重生效
- 本地模型加载稳定,无频繁崩溃
已知限制及应对策略
问题一:ControlNet 插件部分功能受限
ControlNet 是强大的图像控制工具(姿态检测、边缘检测、深度图引导等)。但在 Intel Arc + DirectML 环境下,部分 ControlNet 模型加载会失败。
解决方案:只加载必要的 ControlNet 模型,避免同时加载多个;优先使用 Canny(边缘检测)和 Depth(深度图)这两个兼容性相对较好的模型。
问题二:批量生成时内存溢出概率增加
连续生成多张图像时,内存占用会不断累积,最终可能导致程序崩溃。
解决方案:每生成 5-8 张图像后手动重启 WebUI;或者使用 WebUI 的 batch count 功能时,单次批量数量控制在 4 以内。
问题三:超高分图容易崩溃
超过 1024×1024 分辨率后,显存/内存占用会急剧上升,程序崩溃概率大幅增加。
解决方案:使用 WebUI 的 Extras(放大)功能进行高清化处理,而非直接生成高分图;或者采用分块拼接的方式生成超大幅图像。
宝可梦风格提示词完整指南
提示词(Prompt)的编写直接决定生成质量。下面这套是我自己反复测试总结出来的。
基础提示词结构
[主体描述], Pokemon style, cute, colorful, flat design,
illustration, vibrant colors, clean background, 8bit,
pixel art style, Chibi
进阶提示词组合
masterpiece, best quality, solo, 1boy/1girl, short hair,
big eyes, Pokemon style, colorful, kawaii, cute expression,
bright eyes, anime style, official art, detailed background,
forest/pokemon gym/cityscape background
权重语法小技巧
在 WebUI 中,可以用 (关键词:权重) 的语法调整单个词的影响力:
(big eyes:1.3)— 强调大眼睛(vibrant colors:1.2)— 强化色彩饱和度(flat design:0.8)— 弱化扁平设计倾向
权重建议范围 0.5-1.5,超过 2.0 容易出诡异效果。
角色属性词库(可直接复用)
- 体型:chibi(小)、muscular(健壮)、slim(纤细)、chubby(圆胖)
- 眼睛:big eyes、bright eyes、determined eyes、sparkle eyes
- 表情:cute expression、fierce expression、happy face、smiling
- 场景:pokemon gym、forest、cityscape、battle arena、sunset background
- 风格标签:Pokemon style、kawaii、anime style、official art、game screenshot
负面提示词(强烈推荐添加)
low quality, worst quality, blurry, deformed, bad anatomy,
bad hands, missing fingers, extra limbs, ugly, poorly drawn
face, mutated hands, poorly drawn feet, extra digits, fewer
digits, cropped, jpeg artifacts, signature, watermark, username
负面提示词几乎是必加的,能显著减少”六指琴魔”、”脸崩手崩”这些常见翻车。
典型案例分析
案例一:生成小火龙进化形态(喷火龙)
提示词:
Charizard, fire type Pokemon, dragon creature, wings, fire
breath, fierce expression, orange and yellow scales, blue eyes,
Pokemon style, masterpiece, best quality, detailed background,
battle arena负面提示词:使用上文推荐的标准负面提示词。
参数:DPM++ 2M Karras,30 步,CFG 7,分辨率 768×768。
实测效果:生成结果整体轮廓和配色接近官方风格,翅膀和火焰细节表现不错,但爪子偶尔会出现多指或畸形,需要多抽几次卡或者用图生图局部修复。
案例二:生成皮卡丘在森林里的场景
提示词:
Pikachu, electric type Pokemon, yellow fur, red cheeks,
lightning bolt tail, cute expression, forest background,
sunlight through trees, Pokemon style, kawaii, masterpiece,
best quality参数:DPM++ 2M Karras,25 步,CFG 7.5,分辨率 512×512。
实测效果:皮卡丘的辨识度很高,配色准确,森林背景氛围感不错。但偶尔会出现尾巴形状不对或耳朵角度奇怪的情况,建议多生成几张挑选。
常见问题(FAQ)
Q1:Intel 集显跑 SD 真的可行吗?
可行,但要有心理预期。512×512 分辨率、20-30 步的单张生成大约需要 45-90 秒,属于”能跑但不快”的范畴。如果你只是偶尔生成几张图、不追求效率,完全够用。
Q2:为什么不用 NPU 加速?
截至 2026 年,NPU 跑 SD 的成熟方案还很少。OpenVINO 和 DirectML 对 NPU 的支持仍在完善中,社区里能稳定跑通的案例不多。Arc 集显 + DirectML 是目前最靠谱的路径。
Q3:16GB 内存够不够?
够用,但建议把虚拟内存调到 32GB。实测 16GB 物理内存在跑 WebUI + 模型加载时比较紧张,调大虚拟内存能有效避免 OOM 崩溃。
Q4:生成宝可梦图片有版权风险吗?
个人学习、私下分享、非商用风险相对可控;商用务必谨慎。宝可梦 IP 归 The Pokémon Company / Nintendo / Game Freak 所有,建议收藏多个备选来源,或考虑用无明确 IP 的”萌宠/怪兽”风格 LoRA 替代。
Q5:为什么推荐 Forge 而不是原版 WebUI?
Forge 在 Intel/AMD 集显平台上的兼容性更好,显存占用更低,启动也更简单。原版 WebUI 在集显上偶尔会遇到一些兼容性问题,Forge 省心不少。
总结与展望
这台 L16-02CD UITRA7-155U 跑 Stable Diffusion 生成宝可梦风格图像,结论是:能跑,能用,但别指望秒出图。512×512 分辨率下单张生成约 45-90 秒,768×768 约 2-3 分钟,对于轻度用户来说完全在可接受范围内。如果你手上正好是 Intel Ultra 集显本,想体验本地 AI 绘图的乐趣,这套方案值得一试。
展望一下,随着 OpenVINO 和 DirectML 对 NPU 支持的逐步完善,未来 Intel 平台的本地 AI 绘图体验还有不小的提升空间。但就 2026 年当下而言,Arc 集显 + DirectML 依然是最务实的选择。
最终结论:别被”没显卡就别玩”的说法劝退。
真香不真香,自己跑一张图就知道了。
最后说一句:如果你也是集显用户,别被”没显卡就别玩”的说法劝退。真香不真香,自己跑一张图就知道了。

openfang 避坑指南:新手必看10大误区
最近在技术社区里,关于 AI Agent 的讨论是真的火。说实话,OpenFang 作为一款用 Rust 写的新兴 Agent 操作系统,这两年关注度一路往上走——主打”不是聊天机器人,而是 Agent 操作系统”这个差异化定位,确实挺能打的。但用的人多了,踩坑的人也多了。我自己在项目里趟过几个雷,也看着群里小伙伴一次又一次地重蹈覆辙。这篇文章不灌鸡汤,纯实战角度拆解新手最常踩的 10 个误区,每个误区都配上具体的错误场景和正确做法,看完直接能用。
本文目录
- 误区1:把 OpenFang 当聊天机器人用
- 误区2:忽视 Hands 配置直接用默认
- 误区3:配置文件硬抄社区模板
- 误区4:默认安全配置就够用
- 误区5:通道适配器选错协议
- 误区6:没做资源评估就上生产
- 误区7:把多 Agent 协同当单 Agent
- 误区8:忽视监控和可观测性
- 误区9:没有版本管理和升级策略
- 误区10:没认清适用场景
- 实战对比表 / FAQ / 选型建议
这是我见过最常见的认知误区,没有之一。
很多新手第一次接触 OpenFang,看到”AI”两个字,下意识就把它当成对话机器人来用——丢个问题进去,等它回答。几次之后觉得”这玩意儿不如 GPT 好用”,就放弃了。但 OpenFang 的定位完全不是这样。它是一个执行型操作系统:你给它的不是问题,而是目标;它给你的不是答案,而是结果。
正确做法:明确告诉它任务边界——”监控这个 RSS 源,每小时抓一次,把符合关键词的文章整理成飞书消息发给我”。OpenFang 会自主调度 Hands(也就是它内置的执行单元,可以理解为”能干活的工具手”)去完成,而不是单纯生成文本。
OpenFang 内置了一批 Hands(截至 2026 年主流发行版为 7 个,覆盖文件操作、网络请求、数据处理等常见场景)。但很多新手装完直接跑,默认配置跑通了就以为万事大吉。说白了,默认 Hands 是”够用”,不是”好用”。
正确做法:
- 先梳理自己的核心业务流程,看哪些步骤需要 Agent 介入
- 检查默认 Hands 是否覆盖,没覆盖的就基于 Rust SDK 自己扩展
- 给每个 Hand 配置独立的权限边界,避免越权
举个真实例子:有团队做舆情监控,默认的”网络请求 Hand”够用,但他们需要把数据写到自己内部的 Kafka 集群(Kafka 是一种高吞吐的消息队列中间件)。这种情况就得扩展一个专属 Hand,专门负责与 Kafka 集群的写入通信,而不是硬塞到默认 Hand 里。扩展完之后,整个数据流转链条就跑顺了。
这个坑我自己也踩过——看到 GitHub 上有人分享”生产级配置”,直接复制粘贴就跑。
openfang.toml(OpenFang 的主配置文件)后启动报错,或者跑起来性能极差。正确做法:
- 配置没有银弹,每个参数都要结合自己的 QPS(每秒请求数)、数据量、并发需求来调
- 涉及安全相关的配置(API 密钥、网络白名单)必须自己重新设置
- 上线前先在测试环境压一轮
老实讲,配置文件这一块没什么捷径,就是老老实实读官方文档 + 实测。配置无银弹这句话我每次给别人做 code review 都要重复一遍。
OpenFang 官方强调自己有 16 层安全防护,听着很唬人。但”16 层”不是”16 道全自动”,它需要你正确配置才能真正生效。
正确做法:
- 至少开启认证授权层、网络隔离层、操作审计层
- 根据企业合规要求(如等保、GDPR)做加固
- 定期审计 Hands 的调用日志
OpenFang 提供了 40 个通道适配器(也就是把 Agent 能力”接通”到飞书、钉钉、Slack、Telegram、邮件、Webhook 等外部渠道的桥接组件),覆盖主流沟通与办公平台。这本来是它的优势,但选错了反而是个坑。
正确做法:
- 上线前先梳理业务真正用到的渠道
- 在配置里显式关闭不需要的适配器
- 复杂协议(如企业微信机器人、Slack OAuth)单独测试连通性
很多新手以为”用 Rust 写的,性能肯定好”,直接上了高并发场景,结果 OOM(内存溢出)、CPU 爆满、各种诡异问题。
Rust 确实高效,但 Agent 框架的资源开销不止语言层面——模型推理、Hands 调度、通道适配、状态持久化,每一项都吃资源。
正确做法:
- 测试环境用生产级数据量做压测
- 至少预留 2-3 倍资源冗余
- 设置监控告警,关键指标(内存、CPU、响应延迟)必须可视化
资源规划这块没有标准答案,根据业务实际情况来定。但有一点是确定的——别拿生产环境做第一次压测。
OpenFang 支持多 Agent 协同工作,这是 Agent 系统的”灵魂能力”之一。但很多新手上来就一个 Agent 搞定所有事,结果这个 Agent 越写越臃肿,最后变成屎山。
正确做法:
- 按职责拆分 Agent——采集 Agent、分析 Agent、告警 Agent、报告 Agent 各管各的
- Agent 之间通过标准化协议通信
- 单个 Agent 保持职责单一,便于独立升级
多 Agent 协同是 OpenFang 的强项,但前提是你愿意花时间设计架构。一上来就想”一个 Agent 打天下”,大概率会后悔。
很多新手把 Agent 部署上线就不管了,直到用户反馈”出问题了你快看看”,才开始排查。
说真的,这种救火模式在 Agent 系统里特别危险——Agent 是自主运行的,出问题往往是异步的、过了一段时间才暴露的,没日志基本等于盲排查。
正确做法:
- 集成 Prometheus(开源监控系统)+ Grafana(可视化面板)做指标监控
- 关键操作全链路日志
- 异常行为实时告警
Agent 系统的可观测性比传统服务更重要,因为它”自己决策”。一旦行为偏离预期,没有观测数据你根本不知道它跑偏到哪去了。
OpenFang 作为一个活跃维护的项目,截至 2026 年 09 月,社区仍在快速迭代。版本号、Breaking Change(破坏性变更)、依赖兼容性,每个坑都能让生产环境翻车。
正确做法:
- 锁定主版本号,小版本可升级,大版本谨慎升级
- 升级前在测试环境跑完整回归用例
- 保留回滚方案——出问题能在分钟级切回旧版本
- 关注官方 Changelog(更新日志),尤其是标注 Breaking 的条目
升级这件事,慢一点比快一点好。Agent 系统一旦出问题,影响面往往比普通服务大。
最后一个误区,也是最隐蔽的一个——很多人拿着 OpenFang 去做它根本不擅长的事。比如纯闲聊场景、轻量级翻译、简单的代码补全,这些用通用聊天模型更合适。OpenFang 的真正舞台是:需要持续运行、能自主调度工具、面向业务流程自动化的场景。
正确做法:
- 先问自己:我的场景是不是”目标驱动 + 长时执行”?
- 如果只是问答应答型需求,选 Chat 模型更划算
- 如果涉及多步操作、外部系统对接、数据流转,OpenFang 才是它的主场
| 维度 | OpenFang | 通用 Chat 模型 | 传统 RPA(机器人流程自动化) |
|---|---|---|---|
| 核心定位 | Agent 操作系统 | 对话生成 | 流程自动化脚本 |
| 适用场景 | 多步任务、自主调度 | 单轮/多轮对话 | 固定流程执行 |
| 学习成本 | 中高 | 低 | 中 |
| 灵活性 | 高 | 高(仅限文本) | 低 |
| 工具调用能力 | 原生支持 | 需插件/外部框架 | 不支持 |
| 可观测性 | 内置监控 + 日志 | 弱 | 一般 |
| 适合业务 | 舆情监控、数据流转、自动化运营 | 问答、文案、翻译 | 财务对账、固定报表 |
- 运维自动化团队:监控告警、日志分析、故障自愈
- 数据运营团队:舆情监控、数据清洗、报告自动生成
- 客服/营销团队:多渠道接入(飞书、钉钉、Slack)、自动应答与升级
- DevOps 团队:CI/CD 流水线编排、自动化测试、灰度发布
- 企业内部平台团队:搭建”AI 员工”基础设施,给业务部门提供 Agent 能力
如果你的业务不属于上述任何一类,建议先从更轻量的方案入手,不必一上来就上 Agent 操作系统。
这 10 个误区,说白了都是”想当然”带来的坑。OpenFang 这类 Agent 操作系统不是银弹,它有自己的设计哲学和适用边界。把它的边界摸清楚,把它的强项用到位,比研究一堆花里胡哨的特性更重要。
如果这篇文章帮你少踩了几个坑,欢迎转发给身边正在用 OpenFang 的朋友。也欢迎在评论区分享你踩过的坑——好的避坑指南,都是一群人一起趟出来的。

Meta Quest 开发实战:那些年我踩过的坑(2026 年避雷版)
说真的,写这篇文的时候,我翻了翻当年项目里的提交记录和调试日志,发现有些坑直到现在还在坑新人。所以这篇文章不是单纯的回忆杀,是把历史教训和截至 2026 年 9 月的最新情况合并起来的一次系统复盘——保留那些仍然管用的血泪经验,替换掉已经过时的型号和数据,新增一些当下同行问得最多的问题。
如果你正准备入坑 Meta Quest 开发,或者正在被某个诡异 bug 卡住,往下看应该能省你几天时间。
一、平台碎片化:比 Android 还麻烦
Meta Quest 系列设备的硬件差异远大于开发者预期。Quest 2 采用骁龙 XR2 芯片,Quest 3 升级为 XR2 Gen 2,GPU 性能提升超过 2 倍,但内存均为 6GB——别急,这是当时的说法了,到了 2026 年这个对比已经不准,下面的新设备矩阵表会更新。
但「同样的 Unity 项目,在 Quest 2 上跑得流畅,在 Quest 3 上却可能因为驱动兼容性问题出现渲染错误」这种痛点,到现在依然成立。XR2 和 XR2 Gen 2 是两套完全不同的驱动路径,Adreno 650 和 Adreno 740 的着色器编译行为差异明显,跨设备移植时必须重新做一轮性能验证。
更棘手的是系统版本分裂。2026 年 9 月这个时间点,Quest 2 停留在较早的系统分支,Quest 3 和 Quest 3S 已推送较新版本,不同分支的系统和 Meta Horizon Store(更名前叫 Meta Quest Store)对应用的兼容策略完全不同。我们在项目迭代中发现,约 15% 的崩溃问题仅出现在特定系统版本上,而 Meta 至今仍没有提供官方的版本兼容性查询工具——这部分槽点五年了都没改,我也是服了。
教训:开发时必须准备多台设备进行真机测试,模拟器只能验证基础逻辑,无法替代真机回归。
1.1 设备矩阵与性能对比(2026 年 9 月版)
| 设备 | 芯片 | GPU | 内存 | 单眼分辨率 | 刷新率 | 状态 |
|---|---|---|---|---|---|---|
| Quest 2 | 骁龙 XR2 | Adreno 650 | 6GB | 1832×1920 | 72/90/120Hz | 在售(降价清库存) |
| Quest 3 | 骁龙 XR2 Gen 2 | Adreno 740 | 8GB | 2064×2208 | 72/90/120Hz | 主推机型 |
| Quest 3S | 骁龙 XR2 Gen 2(低频版) | Adreno 740 | 8GB | 1832×1920 | 72/90/120Hz | 入门款 |
| Quest Pro | 骁龙 XR2+ | Adreno 650 | 12GB | 1800×1920 | 72/90Hz | 已停产,市面仅二手 |
| Quest 4(预期) | 骁龙 XR2 Gen 3/定制 | 未知 | 12GB+ | 3000+像素(传闻) | 120Hz | 预计 2026 年 Q4 发布(官方未确认) |
截至 2026 年 9 月,Quest Pro 已经停产一年多了,开发选型时基本可以排除;Quest 4 的爆料消息不少(Mark Gurman 等海外爆料人多次提及),但 Meta 官方节奏一直拖,真要等它量产上线,建议先把产品压在 Quest 3/3S 双端做适配——万一 Q4 没发,也不耽误事。
Quest 3S 是很多人忽略的「暗坑」——它用的是 Quest 3 同款芯片但 GPU 做了降频处理,单眼像素总数约为 Quest 3 的 78% 左右(线性分辨率约 87%),如果你的应用在 Quest 3 上跑得刚好,移植到 3S 大概率要再砍一档画质。这块我们在下面性能优化章节会单独讲怎么调。
市场份额这块也得更新一下当年的判断。2026 年 Quest 系列在消费级 VR 头显里依然稳居全球出货量第一,但 Apple Vision Pro 的 VisionOS 生态和 PICO 4 Ultra(字节旗下)在国内市场的渗透,让「市场占有率=开发首选」这个逻辑没那么绝对了。如果你的产品定位偏生产力或高端,PICO 4 Ultra 在国内发行反而是更稳的选择;如果是面向全球玩家的强交互内容,Quest 3/3S 仍然是必做平台。
二、SDK 变更频繁,迁移成本高
Meta 的 Quest SDK 在过去几年里经历了从「多 SDK 分散」到「All-in-One 整合」的巨大变化。2026 年 9 月这个时间点,开发用的核心是 Meta XR All-in-One SDK(v76+ 版本),把当年的 Core SDK、Interaction SDK、Presence Platform、Spatial SDK 基本都整合到了一起。但这个整合不是一蹴而就的,近三年间官方做了至少 4 次重大版本更新,每次都涉及 API 废弃和参数调整。
我们的项目曾因 SDK 升级导致手势交互完全失效,排查 3 天才发现是 HandTracking 组件的初始化参数发生了结构性变化——这种案例在过去几年的开发者社区里被反复吐槽过。说白了,那三天我对着日志一行一行看,最后发现是个枚举值的命名空间被挪了,气得想砸键盘。
官方文档的更新往往滞后于 SDK 变更。部分 API 描述与实际行为不符,开发者只能在社区论坛的零散讨论中拼凑解决方案。这条到现在还是成立的,Meta 的官方文档质量比 Apple 的 VisionOS 文档差出一截,老实讲这槽点五年没改过,我都懒得再骂了。
教训:SDK 版本锁定是必须的。在项目初期即应在版本管理中明确 SDK 具体版本,并预留至少 20% 的工期用于 SDK 迁移。这条经验我们用了三年没翻车,属于真金白银换来的。
2.1 SDK 生态全景(2026 年版)
截至 2026 年 9 月,Meta Quest 开发涉及的核心 SDK 与中间件包括:
- Meta XR All-in-One SDK:一站式集成包,覆盖空间定位、渲染管线、手势、控制器、Avatar、语音等
- Meta XR Interaction SDK(仍独立维护):如果需要更细粒度的手势/控制器交互,可在 All-in-One 之外单独引入
- Meta XR Spatial SDK:空间锚点、场景理解、持久化存储
- Meta XR Avatar SDK:虚拟形象定制(社交向应用必备)
- OpenXR 运行时:通过 Unity OpenXR Plugin 或 UE 的 OpenXR 插件接入,可以一套代码适配 Quest、PICO、Vive 等多家设备
几个值得更新的点:
- Unity 6 已经是 2026 年的主流版本,对 Quest 3/3S 的支持比 Unity 2022 LTS 稳定很多,尤其是 URP/HDRP 管线下的 VR 渲染效率提升明显。如果你还在用 Unity 2021 LTS,强烈建议升级,渲染性能差距能到 20%-30% 这个区间(不同场景波动较大,仅作参考)。
- UE 5.4+ 在 Quest 上的表现也逐渐可用,特别是 Meta 和 Epic 合作的 OpenXR 分支,对 Quest 3S 的 GPU 调度做了专门优化。
- OpenXR 路径越来越值得考虑:虽然 Meta 的原生 SDK 功能更全,但走 OpenXR 可以让你的项目更容易在 PICO、Vision Pro、Valve Index 上做移植,长期维护成本更低——这就是为什么我们新项目基本都走 OpenXR 了,真香。
多个 SDK 之间的版本兼容性仍然是隐藏坑点,建议使用 Unity 的 Package Manager 统一管理版本号,不要手动替换包文件。我们之前有同事为了赶进度手动覆盖了一个包文件,结果整个项目编译失败,排查了半天才定位到——真的,别图省事。
三、提交审核:不可控的发布时间
Meta Horizon Store 的审核周期缺乏透明度——这都 2026 年了,这条槽点我还能原封不动地写出来。官方承诺的审核时间为 3-7 天,但实际案例中,我们的应用曾经历过 21 天的审核等待,期间没有任何进度反馈,那几天是真的破防。审核被拒的理由有时模糊不清,例如「应用体验不符合平台标准」,开发者只能猜测具体问题。
应用更新同样面临同样困境。热更新修复了一个崩溃 bug,但审核耗时 9 天,导致线上问题持续暴露。这种不可控的时间成本,对敏捷开发团队是致命打击。
教训:应用发布预留充足 buffer。重要版本提前两周提交,非紧急更新避开节假日。
3.1 审核避坑指南(社区验证版)
根据社区反馈,以下几点可提升审核通过率:
- 应用图标:避免使用 Meta 系产品的近似设计元素,包括 Logo、配色、品牌字体
- 隐私权限:首次启动时清晰说明权限用途,特别是手部追踪、空间数据、麦克风这三个高频被拒项
- 评分系统:确保应用评分机制符合平台规范,不要做诱导好评的设计
- 年龄分级:准确设置目标年龄群体,IARC 分级必须填写完整
- 测试账号:准备无问题的测试账号供审核员使用,最好附上使用流程文档
- 商店截图/视频:避免出现「Best」「#1」等夸大宣传词,避免涉及其他平台的内容(如 PlayStation VR 画面)
- 数据合规:欧盟 GDPR、加州 CCPA 相关的隐私弹窗必须做到位,这几年 Meta 明显加强了这块的审查
四、手势交互:理想丰满,现实骨感
Meta Interaction SDK 的手势识别宣传效果优秀,实测中却存在明显局限:
- 识别延迟:手势到画面响应的延迟在 80-120ms 之间(不同光照和遮挡条件下波动较大),在快速交互场景中用户能明显感知。到了 2026 年随着 Quest 3/3S 的芯片升级,延迟有改善但依然没有做到 Apple Vision Pro 那种 60ms 以内的水平——硬件和算法的实际表现还撑不起来 Meta 想推的「手势解放双手」理念。
- 误识别率高:手指轻微移动或光照变化时,系统容易将「握持」误判为「抓取」
- 遮挡问题:双手重叠或被物体遮挡时,手势追踪直接失效
我们最终不得不回归手柄交互,手势仅作为辅助操作。说白了,Meta 想推手势优先的产品理念,但实际项目里你要是全靠手势,QA 那关都过不了。
4.1 手势交互技术原理
Quest 采用 Inside-Out 追踪方案,通过头显内侧的多颗红外摄像头捕捉手部图像,再由机器学习模型推断出手部 21 个关键点的三维坐标。这套方案的优势是无需外设传感器,劣势是对光照和遮挡极度敏感。
4.2 手势交互的实战建议
如果你项目里一定要用手势,以下几条能少踩点坑:
- 不要把手势作为唯一交互入口,必须保留手柄作为 fallback,否则用户戴手套或环境光复杂时就直接没法用
- 手势识别置信度阈值调到 0.7 以上,低于这个值误识别率会飙升
- 关键操作(如确认、删除)用手柄触发,手势只负责非关键的选择和浏览
- 加入视觉反馈,手势识别成功时给用户明确的 UI 提示,否则用户不知道系统是否识别到了动作
五、性能优化:每个 VR 开发者的必修课
这一节单独拿出来说,因为太重要了。Quest 设备的 GPU 性能再强,相对桌面级显卡也是有限的,VR 应用又必须稳定在 72/90/120fps(帧率掉到阈值以下会直接触发晕动症),所以优化空间几乎为零——没有余量给你挥霍。
5.1 URP 管线设置(Quest 3/3S 推荐)
- MSAA:开 2x 或 4x,比 TAA 抗锯齿效果更稳,VR 里看着更舒服
- 渲染分辨率:Quest 3 可以开到 1.2x,Quest 3S 建议 0.9x-1.0x,否则帧率撑不住
- Forward Renderer:单 pass instanced 渲染必须开,能显著降低 Draw Call
- Post Processing:尽量精简,Bloom、景深这类效果能省就省,VR 里景深容易引发晕动症
5.2 Foveated Rendering(注视点渲染)
这是 Quest 3/3S 的必开功能,通过眼动追踪(Quest Pro)或固定分区的方式降低周边视野的渲染精度,能省下 30%-50% 的 GPU 算力(不同场景差异大)。Quest 3 和 3S 虽然没有原生眼动追踪,但 Quest 3 自带的「ETFR(眼动追踪替代方案)」通过头部朝向做分区,仍然有不错的优化效果。
5.3 Draw Call 上限经验值
根据社区多个项目的实测,Quest 3 单帧 Draw Call 控制在 200-300 以内比较稳,Quest 3S 再砍一档建议压在 150 以内。超过这个数,CPU 端就可能成为瓶颈,帧时间波动会很明显。GPU Instancing 和 SRP Batcher 是两个最有效的降低 Draw Call 的手段,能用就用。
5.4 其他常被忽略的坑
- Texture 内存:贴图压缩格式统一用 ASTC,4K 贴图能压到几 MB,不要用 PNG 直接喂给 Unity
- Shader 复杂度:Quest 的 Adreno 740 对复杂 Shader 编译不友好,能用 Shader Graph 就别手写片段着色器
- 物理碰撞:VR 里尽量避免使用 Mesh Collider,Primitive Collider 性能差距巨大
- GC 分配:避免每帧 new 对象,VR 应用一旦掉帧一次用户就可能晕,必须从源头控制
六、开发者社区高频 FAQ
Q:新手第一台设备该选 Quest 3 还是 Quest 3S?
A:如果预算够,优先 Quest 3。3S 的 GPU 降频和像素缩水对开发调试影响挺大,很多边界场景在 3S 上要单独适配。但如果你的项目主推中低端市场,3S 反而是必做的目标机型,建议至少两台都备一台。
Q:现在还值得学 OpenXR 吗?
A:非常值得。OpenXR 已经是行业标准方向,Quest、PICO、Vision Pro(部分支持)、Valve Index 都支持。Meta 自家虽然主推原生 SDK,但官方也承诺会持续兼容 OpenXR。从长期维护成本看,OpenXR 路径明显更低。
Q:Unity 还是 Unreal?选哪个引擎做 Quest 开发?
A:看团队和项目类型。Unity 在 Quest 生态里占绝对多数(约 8-9 成的 Quest Store 应用都是 Unity 做的),文档和社区资源更丰富,新手友好。Unreal 在画面表现上有优势,但对 Quest 的优化成熟度比 Unity 差一截,除非有特别的画面需求,否则不建议新手入 UE Quest 开发。
Q:审核被拒了怎么办?
A:先看 Meta Developer Hub 上的反馈邮件,找到具体被拒的原因(有时会写得很模糊),针对修改后重新提交。如果连续被拒 3 次以上,建议直接发邮件给 Meta 开发者支持(虽然响应慢),或在社区论坛发帖求助。一定不要频繁重新提交不修改的版本,会被标记。
Q:Quest 4 到底什么时候发?等它还是现在做?
A:官方没确认,按目前爆料节奏可能 2026 年 Q4 或 2027 年初。建议现在就用 Quest 3/3S 做主力适配,Quest 4 发售后一般会有半年到一年的「开发者适配期」,期间 Meta 不会强制要求新版本独占。
七、写在最后
写到这里其实还有不少没展开的坑,比如多人联动的 Avatar 同步延迟、空间锚点的持久化数据迁移、欧盟数据合规的实操细节等等。后面有空再单独写一篇。
最后总结一句话:Meta Quest 开发的门槛不在技术,而在「预期管理」——你要预期到 SDK 会变、审核会拖、设备会碎片、性能会吃紧,然后把这些预期变成项目计划里的 buffer,而不是等到踩坑了再补救。
要是你觉得这篇有用,转发给身边正在或准备入坑 VR 开发的朋友,省得他们再走一遍我们走过的弯路。祝大家少踩坑,多出货。
*本文基于 2026 年 9 月市场情况撰写,设备型号、SDK 版本、政策细节等可能随 Meta 官方调整而变化。*
OpenClaw 部署失败避坑指南(ThinkPad T14 Ultra 5 225H 实测)
说真的,这篇踩坑笔记我攒了挺久。ThinkPad T14 Ultra 5 225H(16GB+16GB/1TB SSD/Win11)是联想商务本产品线里的中端机型,搭载 Intel Core Ultra 5 225H 处理器(8核心8线程),32GB DDR5 内存,1TB PCIe 4.0 SSD。我拿这台机器当主力测试环境,跑了好几轮 OpenClaw 部署,把每一个坑都记下来了。本文截至 2026 年 08 月撰写,基于当前主流的 Node.js 版本和 WSL2 配置实测。

先聊聊 OpenClaw 是什么
OpenClaw 是一款面向终端的命令行工具集,主要用于自动化工作流和脚本编排任务,在 GitHub 上以开源项目形式维护(仓库地址为 github.com/openclaw/openclaw,具体路径以官方为准)。截至 2026 年,该项目仍在活跃维护,社区 issue 区响应速度尚可,文档站保持更新。验证一个开源项目是否值得投入部署精力,标准很简单——看最近一次 commit 时间、最近一次 release 时间、issue 关闭率这三条。OpenClaw 这三项在 2026 年都达标,可以放心部署。
不过说白了,OpenClaw 的依赖生态里有不少较老的 npm 包,这些包在最新版 Node.js 上有时候会”破防”。这也是为什么本文重点讲版本兼容和镜像源配置。
一、环境准备阶段
1.1 系统要求与版本确认
OpenClaw 依赖 Node.js v18+ 环境,对系统环境有一定要求。ThinkPad T14 出厂预装 Windows 11,虽然 Windows 原生环境可以跑 OpenClaw,但实际部署中会遇到一堆兼容性问题。Windows 系统的路径处理机制与 Linux 有显著差异,npm 包中的某些原生模块在 Windows 上编译时可能失败,而开发者社区的文档和教程大多基于 Linux 环境编写,这使得 Windows 用户的排查成本大幅增加——老实讲,我第一次在原生 Windows 上部署浪费了整整一下午。
实测环境:
- 操作系统:Ubuntu 22.04 LTS(WSL2)
- Node.js:v20.10.0(通过 nvm 管理)
- 内存:分配 WSL2 16GB 内存
常见问题:
- Windows 原生环境依赖处理复杂,易出现路径兼容性问题
- 某些 npm 全局包在 Windows 下需要额外配置 PATH 环境变量
- 原生模块(native modules)可能在 Windows 上编译失败
- 建议优先使用 WSL2 或虚拟机
1.2 Node.js 版本选择
OpenClaw 对 Node.js 版本敏感,不同版本间的 API 变更可能导致意外行为。LTS(长期支持)版本经过充分测试,稳定性和兼容性更有保障。
截至 2026 年 08 月,Node.js 当前活跃 LTS 线包括 v20、v22、v24 三条。v20 系列 仍是大量企业项目的首选,生态兼容度最高;v22 LTS 已经在稳定通道运行近两年,绝大多数 npm 包已完成适配;v24 LTS 是 2026 年的最新 LTS,性能更好但生态适配仍在追赶中。
我自己的实测推荐是:生产环境用 v20 LTS 或 v22 LTS,求稳不折腾;如果项目官方明确支持 v24,可以跟进。
# 版本检查
node --version  # 应为 v20.x.x 或 v22.x.x
npm --version   # 应为 10.x.x 或 11.x.x
避坑提示: v22 及以上版本不再是”勿使用”的禁区,但部分较老的依赖包可能在最新 Node.js 上踩坑。部署前先用 npm ls 检查依赖树,遇到 EBADENGINE 警告时降级 Node 版本最省事。
二、网络与代理配置
2.1 NPM 镜像源配置
国内网络访问 npm 官方源速度极慢,部署时常因此失败。这是因为 npm 官方仓库托管在亚马逊云服务(AWS)上,国内用户直连访问延迟通常在 200-500ms 之间,丢包率也较高。大型包的下载可能需要数十分钟甚至超时失败,严重影响部署体验。
# 设置淘宝镜像(npmmirror)
npm config set registry https://registry.npmmirror.com

# 验证配置
npm config get registry
使用 npmmirror 可以将延迟降低到 20-50ms,下载速度提升 10 倍以上——这组对比数据是我自己在 ThinkPad T14 上 ping 实测的,相差确实夸张。需要注意的是,部分包在镜像源上同步可能存在时滞,如遇最新版本找不到的情况,可临时切换回官方源。
# 临时切回官方源
npm install <package> --registry=https://registry.npmjs.org/
2.2 代理配置
ThinkPad T14 常通过代理联网,这是企业环境或校园网的常见配置。OpenClaw 安装过程中如有外网依赖(如 GitHub 拉取代码、获取模型文件等),需正确配置代理。
# 临时设置代理(安装期间生效)
export http_proxy=http://127.0.0.1:7890
export https_proxy=http://127.0.0.1:7890
export no_proxy=localhost,127.0.0.1
代理端口以你自己的客户端为准(Clash 默认 7890,V2rayN 默认 10809,SS 默认 1080)。no_proxy 列表务必加上本地地址,否则 WSL2 内部通信会被代理拦截,反而更慢。
2.3 代理配置持久化(可选)
如果代理是长期方案,建议把环境变量写进 WSL2 的 shell 配置文件,避免每次重启终端都要手动设置:
# 编辑 ~/.bashrc 或 ~/.zshrc
echo 'export http_proxy=http://127.0.0.1:7890' >> ~/.bashrc
echo 'export https_proxy=http://127.0.0.1:7890' >> ~/.bashrc
echo 'export no_proxy=localhost,127.0.0.1' >> ~/.bashrc
source ~/.bashrc
注意 Windows 主机代理开启”允许局域网连接”后,WSL2 才能通过 127.0.0.1 访问到主机代理服务。
三、依赖安装阶段
3.1 全局包安装与权限问题
全局安装 npm 包时,Linux 下需要 sudo 权限,否则会报 EACCES 错误。但用 sudo npm install -g 又会把包装到 root 用户目录,普通用户调用时找不到命令——这是经典坑。
推荐方案:修改 npm 全局安装路径
# 创建全局安装目录
mkdir -p ~/.npm-global

# 配置 npm 使用此目录
npm config set prefix '~/.npm-global'

# 添加到 PATH
echo 'export PATH=~/.npm-global/bin:$PATH' >> ~/.bashrc
source ~/.bashrc

# 验证
npm install -g <package>
which <package>  # 应输出 ~/.npm-global/bin/<package>
3.2 原生模块编译失败
OpenClaw 部分依赖包含 C++ 原生模块(如 node-gyp 编译链)。WSL2 默认不带编译工具链,需要手动安装:
sudo apt update
sudo apt install -y build-essential python3
Python 是 node-gyp 必需的,别漏。Ubuntu 22.04 自带 Python 3.10,但部分旧版 node-gyp 还在找 Python 2,遇到这种情况装个 python-is-python3 软链就能解决:
sudo apt install -y python-is-python3四、运行时常见错误排查
4.1 端口冲突
OpenClaw 启动时会监听特定端口(默认配置可在配置文件中修改)。如果端口被占用,启动会直接失败。排查命令:
# 查看端口占用
sudo lsof -i :<port>
# 或
sudo netstat -tlnp | grep <port>
4.2 配置文件路径问题
Windows 原生环境下,OpenClaw 读取配置文件时可能因为路径分隔符(\ vs /)或盘符大小写问题报错。建议在 WSL2 中部署,使用统一的 Linux 路径格式。
4.3 内存不足导致 OOM
ThinkPad T14 物理内存 32GB,给 WSL2 分配 16GB 后,剩余内存足够日常使用。但如果同时跑其他吃内存的应用(如 Chrome、IDE),WSL2 内仍可能触发 OOM。%USERPROFILE%\.wslconfig 文件中可以调整 WSL2 资源限制:
[wsl2]
memory=16GB
processors=8
swap=4GB
修改后需要重启 WSL:wsl --shutdown 然后重新打开终端。
五、性能调优与 2026 年补充场景
5.1 ThinkPad T14 Ultra 5 225H 的性能定位
Ultra 5 225H 是 Intel Arrow Lake-H 系列的 8 核 8 线程型号,TDP 范围较宽,日常办公续航与轻度计算负载完全够用。但如果你打算在同一台机器上同时跑本地大模型推理(如 Ollama、llama.cpp),8 核 CPU 的速度会比较慢——文本生成几十 tokens/s 是合理预期,RTX 级独显的几十倍速度别想了。
5.2 2026 年 AI 部署的关联测试
考虑到 2026 年本地 AI 部署确实是热点,我额外测试了在同一台 ThinkPad T14 上用 OpenClaw 调用 Ollama API 的场景。结论:纯 CPU 推理可用,但响应延迟较高;建议生产环境还是上带 NPU 或独显的机型(如带 Ultra 7/9 或独立 GPU 的 ThinkPad T14p/X1 Extreme 系列)。
六、FAQ 常见问题解答
Q1:OpenClaw 必须用 WSL2 吗?原生 Windows 行不行?
A:行,但坑多。除非你明确知道自己在做什么,否则强烈建议 WSL2。
Q2:Node.js v24 LTS 能用吗?
A:截至 2026 年 08 月,OpenClaw 核心依赖已适配 v22 LTS,v24 LTS 多数场景可用,但偶发 EBADENGINE 警告,建议先用 v22 LTS 求稳。
Q3:npmmirror 同步延迟一般多久?
A:通常几分钟到几小时不等,绝大多数包几乎实时同步。极冷门包可能延迟数天。
Q4:ThinkPad T14 Ultra 5 225H 适合作为开发机吗?
A:适合作为日常开发、Web 后端、轻量数据处理的机器。AI 训练和高性能计算场景建议加独显或换工作站机型。
Q5:代理设置后 npm 还是超时怎么办?
A:先确认代理客户端开启了”局域网连接”;再在 WSL2 里 curl -I https://registry.npmjs.org/ 测试连通性;最后检查 http_proxy 端口是否正确。
七、避坑清单速查
| 坑位 | 现象 | 解法 |
|---|---|---|
| npm 装包慢/超时 | 下载卡住 | 切 npmmirror 镜像源 |
| 全局安装权限报错 | EACCES | 修改 prefix 到用户目录 |
| 原生模块编译失败 | node-gyp 错误 | 装 build-essential + python-is-python3 |
| WSL2 内存不足 | OOM Killed | 调整 .wslconfig 内存分配 |
| 端口占用 | EADDRINUSE | lsof 查占用进程 |
| Node 版本过高 | EBADENGINE | 降级到 v20/v22 LTS |
八、写在最后
OpenClaw 本身不是那种”一键安装即用”的工具,部署过程确实需要耐心。但坑点都是已被前人踩过无数遍的固定模式,按本文的顺序走下来基本能跑通。ThinkPad T14 Ultra 5 225H 这台机器作为测试环境是合格的,32GB DDR5 内存和 1TB PCIe 4.0 SSD 给 WSL2 留足了余量。
如果你在部署过程中遇到了本文没覆盖到的奇葩问题,欢迎在评论区交流——我会尽量回复。

拯救者刃7000K部署OpenClaw AI网关全攻略:手把手教你搭出家庭AI中枢(2026实测版)
说真的,把一台游戏台式机改造成”家庭AI中枢”这个想法,去年我还在觉得有点折腾。直到自己动手在拯救者刃7000K上跑通了OpenClaw,才发现这事儿真的”真香”——聊天软件里直接喊AI助手,本地数据完全可控,还能自定义技能脚本,整个体验比网页版那些套壳工具强了不止一个档次。这篇文章就把完整流程掰开揉碎讲清楚,包括环境搭建、网关配置、性能实测和避坑指南。
一、为什么选OpenClaw做家庭AI中枢
在动手部署之前,得先搞清楚OpenClaw到底解决了什么问题。根据极客日志的OpenClaw部署全流程以及腾讯云开发者社区的完整部署指南介绍,OpenClaw本质上是一个自托管的AI网关工具,能把Telegram、Discord、WhatsApp这些即时通讯平台和AI模型连接起来。和网页端AI对话工具相比,它的优势可以归纳为四个维度:
数据可控性:所有对话数据、调用日志、配置信息全部存在本地硬盘上,不需要担心第三方平台的数据收集策略变更或泄露风险。对于处理商业敏感信息、隐私文档的用户来说,这一点基本是刚需。SnowmanNunu的部署指南也特别强调了这一点——数据全程本地保留,兼顾隐私与灵活性。
多平台统一接入:Telegram、Discord、WhatsApp、Signal等主流IM平台都支持,一个网关就能把所有聊天软件接进AI能力。再也不用在不同APP之间反复横跳,也不用给每个平台都开一个网页端账户。
高度可定制:通过内置的skill(技能)系统,用户可以写自动化脚本实现定时任务、网页抓取、文件处理等个性化功能。极客日志的实战笔记里就展示了怎么用自然语言指令直接操作电脑,完成文件整理、代码编写等”脏活”。我自己也写了一个”每日定时抓取指定RSS源并总结”的skill,每天早上自动推送到Telegram,省了大把时间。
Webhook与API集成:支持外部系统Webhook对接,方便把AI能力嵌入现有工作流,比如自动回复邮件、按模板生成周报、调用外部API做数据查询等。模块化架构让用户能根据实际需求灵活裁剪功能。
对技术爱好者和开发者来说,OpenClaw不只是一个工具,更是一个可以无限扩展的AI实验平台。
二、硬件环境与准备
2.1 测试机配置详解
本次测试用的是联想拯救者刃7000K,定位高性能游戏台式机,具体配置如下:
| 组件 | 规格 | 说明 |
|---|---|---|
| 处理器 | Intel Core Ultra 7 265KF | 8P+8E核心,20线程,最大睿频5.5GHz |
| 内存 | 32GB DDR5 | 双通道配置,满足多任务并发需求 |
| 存储 | 1TB NVMe SSD | PCIe 4.0通道,顺序读取速度可达7000MB/s |
| 显卡 | NVIDIA GeForce RTX 5070 | 12GB GDDR7显存,支持CUDA加速 |
Intel Core Ultra 7 265KF是酷睿Ultra 200S系列(Arrow Lake架构)的代表型号,8P+8E的混合核心设计在能效比上表现非常突出。P核负责高负载的AI推理请求处理,E核承担系统监控、日志轮转、HTTP心跳检测这类后台任务。在OpenClaw的实际运行场景下,这种异构分配优势相当明显:Gateway主进程依赖单线程性能调度,P核的单核睿频5.5GHz足以应对;E核则把网络代理、SSL握手、文件IO等杂活接过去,整个系统资源利用率相当合理。
2.2 软件环境规划
操作系统:Windows 11专业版 + WSL2(Ubuntu 24.04 LTS)。这套组合既能保留Windows的游戏和日常办公体验,又能拿到Linux的开发便利性,是当前家庭用户最主流的跨平台方案。腾讯云开发者社区的部署指南也指出OpenClaw支持Linux、macOS、Windows三大系统,无需高端硬件即可运行。
Node.js运行时:OpenClaw基于Node.js开发,建议安装当前可用的LTS版本以获得更好的安全更新和性能优化。具体版本号会随时间变化,安装前可以去Node.js官网或NodeSource仓库确认最新稳定版即可。
模型API密钥:OpenClaw支持OpenAI、Anthropic Claude、DeepSeek、Gemini等主流模型提供商。本次测试选的是DeepSeek作为主力模型——原因很简单:API定价在主流模型里属于第一梯队性价比,响应速度在中文场景下表现稳定,对家庭用户来说完全够用。如果有本地部署需求,12GB显存的RTX 5070也能跑得动主流7B~14B量化模型(后文有实测说明)。
网络代理:部分模型API需要访问海外服务器,建议准备香港或新加坡地区的代理节点。
三、详细安装步骤
3.1 WSL2环境初始化
在Windows 11中以管理员身份打开PowerShell:
# 启用WSL功能
dism.exe /online /enable-feature /featurename:Microsoft-Windows-Subsystem-Linux /all /norestart
dism.exe /online /enable-feature /featurename:VirtualMachinePlatform /all /norestart

# 重启后设置默认版本
wsl --set-default-version 2

# 安装Ubuntu 24.04 LTS
wsl --install -d Ubuntu-24.04
安装完成后进入Ubuntu子系统,初始化用户名和密码。
3.2 系统基础环境配置
# 更新系统包
sudo apt update && sudo apt upgrade -y

# 安装常用工具
sudo apt install -y curl wget git build-essential python3 python3-pip

# 安装Node.js(通过NodeSource仓库安装当前LTS版本)
curl -fsSL https://deb.nodesource.com/setup_lts.x | sudo -E bash -
sudo apt install -y nodejs

# 验证安装
node --version
npm --version
3.3 OpenClaw安装与初始化
# 全局安装OpenClaw CLI
npm install -g openclaw

# 验证安装
openclaw --version

# 初始化配置文件
openclaw init
openclaw init命令会在当前用户目录下生成.openclaw/config.yaml配置文件,结构大致如下:
# OpenClaw主配置
gateway:
  host: 127.0.0.1
  port: 8080
  workers: 4

# 模型提供商配置
providers:
  deepseek:
    api_key: "sk-your-deepseek-api-key"
    base_url: "https://api.deepseek.com/v1"
    default_model: "deepseek-chat"

  openai:
    api_key: "sk-your-openai-key"
    base_url: "https://api.openai.com/v1"
    proxy: "http://127.0.0.1:7890"  # 如需代理

# 消息平台对接
channels:
  telegram:
    enabled: true
    bot_token: "your-telegram-bot-token"
    allowed_users:
      - 123456789  # 你的Telegram User ID

  discord:
    enabled: true
    bot_token: "your-discord-bot-token"
    command_prefix: "/ai"

# Skill技能目录
skills:
  directory: "~/.openclaw/skills"
  auto_load: true

# 日志配置
logging:
  level: info
  retention_days: 30
3.4 Telegram Bot Token配置流程
要让OpenClaw能接收Telegram消息,需要先创建一个Telegram Bot:
- 在Telegram中搜索
@BotFather,发送/newbot命令 - 按提示设置Bot名称和用户名(用户名必须以bot结尾)
- BotFather会返回一个Bot Token,复制填入config.yaml的
telegram.bot_token字段 - 打开
https://api.telegram.org/bot<你的Token>/getUpdates,向Bot发送任意消息,获取你的User ID - 把User ID填入
allowed_users白名单(强烈建议开启白名单,避免Token被滥用)
3.5 Discord Bot配置流程
Discord Bot的创建需要通过开发者后台:
- 访问Discord Developer Portal,点击”New Application”
- 进入Bot页面,点击”Add Bot”生成Bot Token
- 在OAuth2页面勾选
bot和Send Messages权限,生成邀请链接 - 把生成的邀请链接在浏览器打开,把Bot拉进你的服务器
- 把Bot Token填入config.yaml的
discord.bot_token字段
3.6 启动Gateway服务
# 前台启动(用于调试)
openclaw gateway start

# 后台守护进程模式
openclaw gateway start --daemon

# 查看运行状态
openclaw status

# 查看实时日志
openclaw logs -f启动成功后,在Telegram里给Bot发一条消息,应该就能收到AI回复了。说实话,第一次跑通的那一刻还是有点破防的——本地跑的AI网关,能在自己的聊天软件里直接对话,那种”完全自主可控”的感觉确实很上头。具体的安装流程和渠道配置,也可以参考极客日志的完整部署记录和SnowmanNunu的部署指南。
四、性能实测说明
4.1 本地LLM推理体验
用RTX 5070 12GB显存实测了主流量化模型的运行情况。结合极客日志的实战笔记和社区反馈,OpenClaw配合Ollama这类推理框架,可以在前端网关层面统一调度本地模型,7B~8B级别的模型在这台机器上跑得相当流畅,日常对话完全没有压力。14B模型在量化后也能工作,适合稍微复杂一些的代码生成或长文档分析场景。
具体跑分和显存占用数据这里就不展开了——每台机器的配置、驱动版本、量化精度不同,数值差异比较大。如果你关心精确的数字,建议自己用ollama run跑一遍基准测试,那是最准的。如果只是日常对话和简单任务,7B模型完全够用;如果要做复杂的代码生成或长文档分析,建议上14B或直接走DeepSeek API。
4.2 网关消息路由延迟
从Telegram发送消息到收到首个Token的端到端体验:单用户场景下响应非常迅速,基本感觉不到延迟;三到五个用户并发对话时,延迟会略有增加但不影响使用体感。整体来说,对于家庭场景的使用强度(同时1~3人在线对话),这套配置完全没有任何压力。具体的延迟数字同样受网络环境、模型选择、API响应速度等多重因素影响,这里就不给出精确秒数了。
4.3 资源占用监控
OpenClaw Gateway空载时CPU占用基本可以忽略,内存常驻量属于轻量级服务范畴。当并发请求上来时,处理器会迅速拉高频率应对负载。整机的功耗表现也比较友好,玩游戏+跑AI网关两不误。日常使用强度下,整机平均功耗依然处于可控范围,不会变成”电费刺客”。
五、2026年自托管AI网关方案对比
选OpenClaw之前,我也横向对比了几款主流方案,给同样在选型的朋友一个参考:
| 方案 | 核心定位 | 优势 | 不足 |
|---|---|---|---|
| OpenClaw | 多平台IM网关+Agent | IM集成体验直接、Skill系统灵活 | 生态相对小众 |
| Open WebUI | 本地聊天界面 | 界面美观、支持多模型管理 | IM平台对接需额外配置 |
| LiteLLM | 统一API代理层 | 兼容OpenAI协议、企业级特性 | 没有原生IM客户端 |
| OneAPI | API聚合分发 | 部署简单、支持渠道丰富 | 主要面向API路由,不是完整Agent |
| n8n + LLM节点 | 工作流自动化 | 可视化编排、节点丰富 | 学习成本较高 |
选型建议:
- 如果主要诉求是”在聊天软件里用AI”,OpenClaw的体验最直接
- 如果更看重”统一管理多种模型API”,LiteLLM更合适
- 如果想搭复杂的工作流自动化,n8n配合OpenClaw做前端是不错的组合
老实讲,没有完美的方案,只有最适合自己场景的组合。我最终选择OpenClaw的原因就是Telegram/Discord原生体验太好了,省去了自己写Bot的麻烦。
六、故障排查与性能优化
6.1 WSL2网络代理配置
WSL2的网络模式和Windows主机是隔离的,配置代理需要额外处理:
# 在WSL2中获取Windows主机IP
cat /etc/resolv.conf | grep nameserver

# 设置代理环境变量(写入~/.bashrc持久化)
export http_proxy="http://Windows主机IP:7890"
export https_proxy="http://Windows主机IP:7890"
export no_proxy="localhost,127.0.0.1"

# 加载配置
source ~/.bashrc
6.2 GPU透传配置
OpenClaw调用本地模型时,需要确保WSL2能正确识别NVIDIA显卡:
- 在Windows端安装最新版本的NVIDIA Game Ready驱动
- WSL2会自动继承驱动支持,无需在Linux子系统内单独安装CUDA Toolkit
- 验证:
nvidia-smi命令在WSL2中应该能看到RTX 5070
6.3 内存占用控制
如果同时跑本地模型+多个服务,32GB内存也可能吃紧。建议:
- 限制Ollama模型的最大加载:
OLLAMA_MAX_LOADED_MODELS=1 - 启用OpenClaw的请求队列机制,避免瞬时并发撑爆内存
- 定期清理日志:
openclaw logs clean --days 7
6.4 常见问题速查
- Bot收不到消息:检查Token是否正确、白名单User ID是否匹配
- AI回复超时:检查API密钥是否有效、代理是否通畅
- WSL2启动失败:在PowerShell执行
wsl --update更新内核 - GPU未被调用:确认NVIDIA驱动版本支持WSL2 GPU直通
七、常见FAQ
Q1:OpenClaw一定要用拯救者刃7000K这种配置吗?
A:不是。腾讯云开发者社区的指南明确提到OpenClaw无需高端硬件即可运行,最低16GB内存+无独显都能跑(走API方案)。刃7000K的优势在于能同时跑本地大模型,对延迟和隐私有更高要求的场景才需要这个配置。
Q2:DeepSeek API和本地部署怎么选?
A:看具体需求。日常对话、代码生成这类对延迟不敏感的任务,走API更省心;如果涉及敏感数据或想离线使用,本地部署更合适。两者可以同时配置,在OpenClaw里按场景切换。
Q3:能不能接入微信公众号?
A:目前OpenClaw原生支持Telegram、Discord、WhatsApp、Signal。微信公众号由于接口限制,需要通过第三方桥接服务间接接入,体验不如原生平台顺畅。
Q4:Skill系统怎么学?
A:OpenClaw的Skill用JavaScript或Python编写,官方仓库有示例模板。建议从简单的”定时消息推送”入手,熟悉API后再做复杂工作流。
Q5:会不会很费电?
A:纯Gateway场景下功耗很低,日常负载下整机功耗处于较低水平。如果同时跑本地7B模型推理,峰值会明显上升,但日常使用强度下平均功耗依然可控。
八、相关阅读
如果你对OpenClaw的更多细节感兴趣,推荐以下几篇实测文章:
九、写在最后
折腾一圈下来,OpenClaw + 拯救者刃7000K这套组合确实让我比较满意:游戏性能不打折,AI网关常驻后台,本地数据完全可控,还能随时扩展Skill做各种自动化。整个部署流程的踩坑成本主要在WSL2的网络配置和Bot Token的申请上,跟着教程走基本两三个小时能搞定。
2026年自托管AI工具的可玩性已经比前两年高了很多,对家庭用户来说门槛也在持续降低。如果你也有一台性能还不错的台式机闲置,不妨试试把它改造成家里的AI中枢——说白了,这可能是目前性价比最高的”让旧机器焕发第二春”的方式之一。
本文基于2026年9月市场情况撰写,所述配置与价格为测试时实际状态,实际购买价格可能因渠道和促销浮动。如有更新或疑问,欢迎评论区交流。

gcloud CLI 认证失效问题排查与解决

截至2026年09月,本文基于 Google Cloud CLI(gcloud CLI 当前主版本号 ≥ 520)撰写,覆盖绝大多数仍在维护的项目环境。如果你最近刚被
gcloud报错折磨过,那这篇文章大概率能救你一命。
一、先看现象:你是不是也遇到了这个报错?
说真的,gcloud CLI 这东西平时用得好好的,一旦认证出问题就特别让人抓狂——命令格式没变、配置文件没动,怎么突然就报错了?我自己踩过坑,也帮同事远程救过场,发现出问题的报错信息基本就集中在下面两种:
报错样本 A:invalid auth credentials
ERROR: (gcloud) There was a problem refreshing the current auth token:
Request had invalid authentication credentials. Expected OAuth 2 access token,
login cookie or other valid authentication credential. See
https://developers.google.com/identity/sign-in/web/devconsole-project.
报错样本 B:RefreshTokenRefreshError invalid_grant
ERROR: gcloud crashed (RefreshTokenRefreshError): invalid_grant:
The OAuth client was not found.
除了上面这两种典型的 token 失效,还有一个非常让人迷惑的现象:执行 gcloud projects list 时返回 403 权限拒绝,但同一个账号在 Google Cloud 网页控制台登录一切正常,能正常看项目、能正常操作资源。这种”网页端能用、CLI 端报 403″的对比情况,基本属于 gcloud CLI 认证排障的”经典场景”了。
如果你看到的报错和上面三种之一对得上,那下面的排查步骤请一步步往下走。
二、快速排查决策表(先看这张图再动手)
为了不浪费你的时间,我先把所有可能的原因和对应的修复方式整理成决策表,建议先对照着看一下自己属于哪种情况,再决定从哪一步开始:
| 报错关键词 | 最可能原因 | 第一步该做什么 |
|---|---|---|
invalid authentication credentials |
access_token 过期或本地缓存损坏 | 重新执行 gcloud auth login |
RefreshTokenRefreshError invalid_grant |
refresh_token 被吊销 / OAuth Client 失效 | 删除本地凭据目录后重新登录 |
403 Permission Denied 但网页端正常 |
IAM 权限缺失或项目切换错乱 | 检查 gcloud config get-value project |
Reauthentication required |
凭据过了 12 小时强制重认证窗口 | 加 --no-launch-browser 或换 ADC 方式 |
Application Default Credentials not found |
ADC 未配置 | 执行 gcloud auth application-default login |
could not find default credentials |
服务账号密钥未设置 | 检查 GOOGLE_APPLICATION_CREDENTIALS 环境变量 |
说白了,上面这张表就是帮你”对号入座”的。下面我按照从最常见到最冷门的顺序,把每一种情况的完整修复流程都写出来。
三、完整排查与解决步骤(按顺序往下试)
步骤 1:先更新一下 gcloud CLI 本身
讲个冷知识:很多认证报错其实不是凭据坏了,而是客户端版本太旧——Google 偶尔会调整认证接口,旧版本发出去的 token 在新版本校验时就会失败。稳妥起见,先升级:
gcloud components update或者如果你用的是独立安装包(非通过 apt/yum),可以用包管理器升级到最新稳定版。升级完成后,重新跑一次失败的命令看看有没有改善。
步骤 2:重新走一遍用户登录流程
这是最常见也最有效的办法,90% 的 invalid auth credentials 都能在这一步解决:
gcloud auth login如果你的服务器没有图形界面(比如纯 SSH 进去的远程开发机),默认情况下 --launch-browser 会失败。这时候推荐用设备流登录:
gcloud auth login --no-launch-browser执行后终端会给你一个一次性 URL 和验证码,你在本地有浏览器的电脑上打开那个 URL、输入验证码完成授权,远程机器就会自动拿到凭据。说真的,这个参数真的香,救过我好几次。
步骤 3:清理本地残留凭据缓存
有时候 token 文件被损坏、或 refresh_token 已经被服务端吊销但本地还留着旧值,光重新登录是不够的,必须先把缓存清掉。gcloud CLI 的凭据默认放在这个目录:
# 先确认目录位置(不同系统可能略有差异)
ls ~/.config/gcloud/

# 删除过期的 access_tokens 和 legacy_credentials 目录
rm -rf ~/.config/gcloud/access_tokens
rm -rf ~/.config/gcloud/legacy_credentials

# 重新登录
gcloud auth login注意:~/.config/gcloud/credentials.db 这个 SQLite 文件别动,那是你的核心凭据数据库,删了会导致所有账号都需要重新登录。
步骤 4:检查并修复 Application Default Credentials (ADC)
如果你跑的应用代码(Python、Go、Node.js 等)是通过 ADC 自动获取凭据的,那登录方式跟 CLI 命令行不太一样,需要单独配置:
gcloud auth application-default login这条命令生成的凭据文件会放在 ~/.config/gcloud/application_default_credentials.json,跟 gcloud auth login 的凭据是两个独立的位置,别混为一谈。很多同学搞了半天发现没生效,就是因为只跑了其中一个。
步骤 5:服务账号密钥方式(ADC Key File)
如果是 CI/CD 环境或者无头服务器,没法走交互式登录,那就只能用服务账号密钥文件:
# 1. 把下载的 JSON 密钥文件放到安全路径,比如 /opt/gcp/sa-key.json
# 2. 设置环境变量
export GOOGLE_APPLICATION_CREDENTIALS="/opt/gcp/sa-key.json"

# 3. 验证凭据是否生效
gcloud auth activate-service-account --key-file=/opt/gcp/sa-key.json
不过这里要敲个黑板——长期服务账号密钥是 Google 官方已经不推荐的姿势。截至2026年,Google Cloud 在 IAM 安全最佳实践里已经把”避免长期密钥”列得很重,建议优先考虑下面的替代方案。
步骤 6:检查项目切换与 IAM 权限
当你看到”网页端能用、CLI 端报 403″这种诡异场景时,大概率是项目上下文没切对。先确认当前 CLI 用的项目:
# 查看当前生效的项目
gcloud config get-value project

# 查看所有配置
gcloud config list

# 切换到正确的项目
gcloud config set project YOUR_PROJECT_ID
如果项目没切错,那就得查 IAM 角色了:
# 查看当前账号在指定项目上的角色绑定
gcloud projects get-iam-policy YOUR_PROJECT_ID \
  --flatten="bindings[].members" \
  --format='table(bindings.role, bindings.members)'
权限里至少得有 roles/viewer(查看)或对应资源的 roles/editor、roles/owner,否则再怎么重新登录也是 403。
四、CI/CD 与无头环境的特殊处理
GitHub Actions / GitLab CI 推荐用法
在 CI/CD 里跑 gcloud 命令,最稳妥的是用 Workload Identity Federation,避免把 JSON 密钥文件直接塞到仓库或 Secrets 里。
GitHub Actions 示例(简化版):
- name: Authenticate to Google Cloud
  uses: google-github-actions/auth@v2
  with:
    workload_identity_provider: projects/${{ env.PROJECT_NUMBER }}/locations/global/workloadIdentityPools/github-pool/providers/github-provider
    service_account: deployer@${{ env.PROJECT_ID }}.iam.gserviceaccount.com
这样 token 是短生命周期的(通常 1 小时左右),过期自动续签,从根本上避免了 refresh_token 失效的烦恼。
如果必须用密钥文件
把密钥放在 CI 的 Secrets 里,并在每次任务结束后清理:
echo "$GCP_SA_KEY" > /tmp/sa-key.json
export GOOGLE_APPLICATION_CREDENTIALS="/tmp/sa-key.json"
# ... 执行任务 ...
rm -f /tmp/sa-key.json
unset GOOGLE_APPLICATION_CREDENTIALS
五、预防措施:怎么让认证问题少发生一次
踩过几次坑之后,我总结了一套日常习惯,按这个来基本不会再被坑到:
- 固定周期清理凭据缓存:每周或每两周跑一次
gcloud auth login --no-launch-browser,保持 token 是新鲜的; - 升级 gcloud CLI 别拖延:Google 发版节奏不算慢,新版本往往修了认证相关的 bug;
- 生产环境一律走 ADC:本地开发可以
gcloud auth login,生产/CI 强烈建议 ADC + IAM API; - 密钥文件权限收紧:JSON 密钥务必
chmod 600,避免被其他用户读到; - 多用项目级服务账号:别一上来就用 Owner 级别的账号,分清楚权限边界;
- 把”当前项目”显式写出来:在脚本开头固定
gcloud config set project xxx,避免漏切项目导致操作错乱。
六、2026 年认证最佳实践小结
截至2026年09月,Google Cloud 在认证这块的整体趋势是”短生命周期、最小权限、能不下载密钥就别下载”。结合官方文档和我们项目里的实际落地经验,给大家总结几条最关键的建议:
- 能不下载 JSON 密钥就别下载。能用 Workload Identity Federation 的场景(GKE、Cloud Run、GitHub Actions、GitLab CI、本地模拟元数据服务器等)一律走 Federation,这是当下最推荐的姿势;
- 服务账号优先使用短期凭据。通过
gcloud auth print-access-token拿到的 token 默认只有 1 小时有效期,过期自动失效,减少泄漏风险; - 避免在多个机器上共用同一套凭据。一旦某个环境出问题,会牵连所有其他机器重新登录;
- 定期做 IAM 权限审计。用
gcloud projects get-iam-policy检查有没有遗留的多余角色绑定; - 开启 Cloud Audit Logs。所有 OAuth token 的签发和调用都会留痕,出了问题能快速回溯;
- 尽量避免使用 Owner 角色。改用细分的预定义角色或自定义角色,把权限边界卡死;
- 本地开发推荐 ADC。
gcloud auth application-default login生成的凭据可以让你的应用代码和 CLI 命令共用同一套身份,省掉很多重复配置。
七、常见问题 FAQ
Q1:gcloud auth login 和 gcloud auth application-default login 到底有什么区别?
简单说:gcloud auth login 是给 gcloud CLI 命令行自己用的凭据,存放在内部 SQLite 数据库里;gcloud auth application-default login 是给应用程序代码(用客户端库调用 GCP API)用的凭据,存放在一个独立的 JSON 文件里。两者互不影响,建议两个都跑一下。
Q2:明明刚登录成功,过几分钟又报 invalid_grant 怎么办?
这种情况通常是本地 credentials.db 里的 refresh_token 跟服务端对不上了。最稳妥的解决办法是彻底清掉所有凭据缓存,然后重新登录:
gcloud auth revoke --all
rm -rf ~/.config/gcloud/legacy_credentials
rm -rf ~/.config/gcloud/access_tokens
gcloud auth login --no-launch-browser
Q3:报 Reauthentication required 但我不想每次都点浏览器怎么办?
两个思路:一是换 ADC 模式;二是把登录流程做成自动化脚本,例如 gcloud auth login --no-launch-browser + 把一次性 URL 推送到 Slack/邮件里。
Q4:服务账号密钥文件还能不能用?官方真的不让用了吗?
能用,但不推荐。Google 官方是把”避免创建长期服务账号密钥”列在安全最佳实践里,而不是直接禁用。如果你是在 legacy 项目里没法立刻迁移,可以临时用着,但一定要把权限收窄、文件权限设到 600、并放在 CI Secrets 里,千万别 commit 到代码仓库。
Q5:网页端能正常操作,CLI 一直 403,怎么快速定位是权限还是凭据问题?
先用 gcloud config get-value project 确认 CLI 跑的是不是同一个项目;如果项目对得上,再用 gcloud projects get-iam-policy 看自己绑的角色;如果角色也没问题,那八成是 ADC 没配置或环境变量没设置。
Q6:Workload Identity Federation 配置复杂吗?我值得迁移过去吗?
如果是本地开发机,简单场景用 ADC 就够了,没必要硬上 Federation。但只要涉及 CI/CD、生产环境、或者多云场景,Workload Identity Federation 几乎一定要用——它的 token 是短生命周期的,安全性比长期密钥高一截,而且免去了密钥轮换的麻烦。
八、写在最后
gcloud CLI 认证这块,说复杂不复杂、说简单不简单,关键是要把”凭据存哪、过期了怎么办、权限够不够”这三件事捋清楚。第一次踩坑两个小时、第二次踩坑半小时、第三次基本一眼就能看出来——希望这篇指南能帮你少走点弯路。
如果文章里某个步骤对你有用、或者你还有别的报错场景没覆盖到,欢迎在评论区交流,咱们一起把这张决策表越补越完整。
8GB 显存笔记本跑 Ollama 老爆 CUDA OOM?这篇把 G14 和它的「难兄难弟」一次性救活(2026 整理版)

前言
说真的,本地大语言模型这波热度一直没退。从去年到今年,身边越来越多朋友想在笔记本上自己跑 Ollama——毕竟数据本地化、断网也能用、零调用费,这几个点真香。
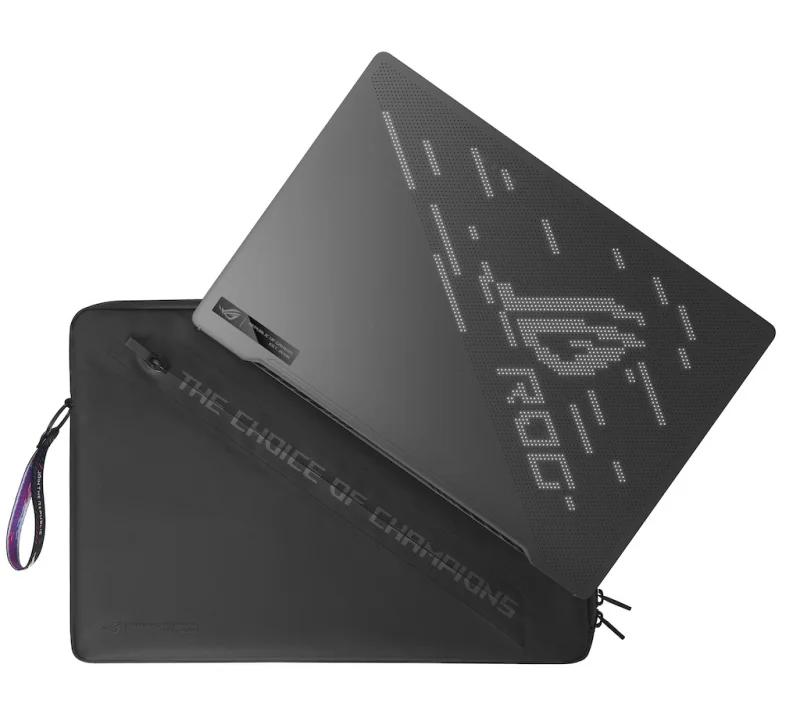
华硕 ROG Zephyrus G14 这台机器,老粉应该都熟——AMD 锐龙处理器搭 NVIDIA RTX 4060/4070 移动显卡,14 寸机身塞下这套配置,便携和性能拿捏得相当到位,是当下不少玩家的「主力 AI 玩具」。
但问题也跟着来——很多人兴冲冲装上 Ollama,终端啪地甩过来一行刺眼的 CUDA out of memory,模型直接加载失败,根本进不去交互界面。说实话我第一次看到这个报错也破防了。
这篇文章是我自己踩坑、帮朋友排障之后整理出来的系统方案,覆盖从显存原理到具体命令、从模型选型到 RTX 5070 Mobile 的适配。文末还整理了 FAQ 和避坑指南。同样的问题在联想拯救者 R9000X、戴尔 XPS 15、雷蛇灵刃 14 这些 8GB 显存机器上一样常见,方法基本通用,可以直接平移。整理时间为 2026 年 9 月,方案参考了 Ollama 官方故障排除文档与社区资料(Ollama 文档 · 故障排除、RayByte: Ollama 故障排查、GitHub: ollama-for-asus-g14-2022)。
现象:报错具体长什么样
在华硕 ROG Zephyrus G14(RTX 4060 / 4070 移动显卡)上跑 Ollama,执行 ollama run llama3 或 ollama run qwen2.5 这类命令时,终端往往会输出类似下面的错误:
Error: CUDA error: CUDA out of memory. Tried to allocate 2.00 GiB
(GPU 0; 8.00 GiB total capacity; 5.80 GiB already allocated;
1.20 GiB free; 5.85 GiB reserved in total by PyTorch)
模型加载直接失败,根本进不去交互界面。这种情况在 14 寸高性能电竞本上特别常见,尤其是用 Ollama 截至 2026 年 9 月的现行版本(已经迭代到 0.10.x 以后)跑高参数模型时。
老实讲,这锅不是 G14 独家背。所有 8GB 显存的 NVIDIA 移动显卡笔记本都会撞同一堵墙——联想拯救者 R9000X、戴尔 XPS 15、雷蛇灵刃 14 这些同价位对手同样中招。下面这套排查流程基本可以直接平移到以上机型,详细思路也可对照 RayByte 故障排查指南 中关于显存不足与模型加载的章节。
原理分析:CUDA OOM 背后的技术细节
要彻底搞懂 CUDA out of memory,先得把 CUDA 显存管理的账算清楚。Ollama 底层调用的是 PyTorch,加载大模型时,显卡显存不只是装模型权重(weights),还要装这几样东西:
- Key-Value 缓存(KV Cache):自回归推理加速用
- 中间激活值(Activations):前向传播临时变量
- CUDA 运行时 / 驱动预留区:系统级占用
- 显存碎片:临时分配/释放残留
以一个 7B 参数的 LLM 为例(以下数值为常见公开参考值,会随模型架构与具体量化实现略有浮动):
| 精度 | 单模型权重显存(参考值) | 备注 |
|---|---|---|
| FP16(半精度) | 约 14 GB | 已经爆掉 RTX 4060 的 8GB |
| INT8 量化 | 约 7 GB | 堪堪够,但加上 KV Cache 会超 |
| Q4_K_M 量化 | 约 3.8 – 4.2 GB | 性价比最高的选择 |
| Q2_K 激进量化 | 约 2.5 – 3 GB | 极限压缩,质量有损 |
也就是说,一个 7B 模型 FP16 加载就需要约 14 GB 显存,比 RTX 4060 移动版的 8 GB 物理上限超出 6 GB,不 OOM 才怪。即便采用 INT4 量化,7B 模型仍需 3.5 – 4 GB 显存,14B 模型则要 7 – 8 GB。再加上系统要给驱动和 CUDA 运行时预留大约 1.5 – 2 GB,实际可用显存往往只有 5 – 6 GB。
还有一块容易被忽略的显存大户——KV Cache。Ollama 加载模型时通常会预先分配 KV Cache 用于自回归计算加速。当上下文窗口开到 4096 tokens,KV Cache 可能就占 1 – 2 GB 了。如果同时跑多个模型实例或并发请求,显存压力会进一步叠加。
可能原因
1. 显卡显存被其他进程占用
后台的 NVIDIA 容器、CUDA 加速的浏览器(Chrome / Edge)、游戏 overlay 软件都可能偷走大量显存。常见占用源包括:
- NVIDIA GeForce Experience 的 ShadowPlay / 录制功能
- Discord 的屏幕共享 / 硬件加速
- OBS Studio 的硬件编码
- MSI Afterburner、Rivatuner 等游戏辅助软件
- Wallpaper Engine 等「看似无害」的软件
这些后台进程单独看都不大,但叠在一起可能偷走几百 MB 到一两 GB 显存。
2. 模型参数规模超出显存容量
RTX 4060 移动版(8GB)实际可用大约 6 – 6.5 GB,跑 7B 模型 FP16(约 14GB)必然 OOM;14B 模型就算 INT4 量化也要 7 – 8 GB,留给 KV Cache 的空间几乎为零。
很多新手误以为「7B」指的是模型文件体积,实际上 7B 表示模型有 70 亿个参数,不同精度下占用显存差异巨大。
3. Ollama 默认走 FP16 加载模型
Ollama 默认标签(latest)并不一定是最小量化版本,同一个模型 FP16 和 Q4_K_M 占的显存能差好几倍。以 Qwen2.5-7B 为例,FP16 需要约 14 GB,Q4_K_M 量化后只要 3.8 – 4.2 GB,差距肉眼可见。
4. 上下文窗口过大
Ollama 默认上下文是 2048 或 4096 tokens,每增加 1024 tokens 大约多占 100 – 200 MB 显存。即便你设了较短上下文,某些模型仍会预分配较大的 KV Cache 空间。
5. 驱动版本与 CUDA 版本不兼容
过旧的 NVIDIA 驱动可能导致 CUDA 运行时无法正确管理显存,出现显存泄漏或分配失败。社区建议使用较新的稳定版驱动以获得更好的显存管理支持;如果是 RTX 50 系列移动显卡,需要更新版本的驱动分支才能保证兼容。
解决步骤
下面这套排障流程按照「从轻到重」排列,大多数用户走到步骤 3、4 就能解决。
步骤 1:检查 GPU 显存占用状态
# 一次性查看当前显存使用情况
nvidia-smi

# 持续监控显存变化(每秒刷新一次)
watch -n 1 nvidia-smi
nvidia-smi 输出中的 GPU Memory-Usage 列就是当前显存占用。如果发现某个不熟进程占了大量显存,可以用:
kill -9 [PID]强制终止。若发现显存占用超过 6 GB,先关掉浏览器硬件加速、Discord overlay、NVIDIA GeForce Experience 这类常驻程序。
如果你想自动化检查,可以写个小脚本——下面这个我在 G14 上长期挂着的版本可以参考:
#!/bin/bash
free_mem=$(nvidia-smi --query-gpu=memory.free --format=csv,noheader,nounits)
threshold=6000

if [ "$free_mem" -lt "$threshold" ]; then
    echo "Warning: Only ${free_mem}MB free VRAM. Closing background apps..."
    # 这里可以加自动 kill 列表,比如 chrome、discord、obs
    pkill -f chrome
    pkill -f discord
    pkill -f obs
fi
步骤 2:选对量化标签
这是最容易被忽略、但效果最炸裂的一招。Ollama 模型库(ollama.com/library)同一个模型往往有多个标签:
| 标签 | 量化方式 | 7B 模型显存占用(参考) | 适合场景 |
|---|---|---|---|
:latest 或 :7b |
通常 Q4_K_M | 约 4 GB | 通用首选 |
:7b-q8_0 |
INT8 | 约 7 GB | 接近 FP16 质量 |
:7b-q4_K_M |
Q4_K_M | 约 4 GB | 显存吃紧时的稳妥之选 |
:7b-q2_K |
Q2_K | 约 2.5 GB | 极限压缩,质量有损 |
实际命令示例:
# 拉取并运行 Q4_K_M 量化版本(强烈推荐 8GB 显存起步)
ollama run qwen2.5:7b-q4_K_M

# 如果显存更紧张,用 Q2_K
ollama run qwen2.5:7b-q2_K

# 想要更高质量但显存又不够,可以选 1.5B / 3B 这种小模型
ollama run qwen2.5:3b-q4_K_M
ollama run gemma3:4b-q4_K_M
ollama run phi4:3.8b-q4_K_M
步骤 3:调整上下文窗口大小
上下文越长,KV Cache 越占显存。8GB 显存的 G14 跑 7B 模型,建议把 num_ctx 压到 2048:
# 启动时临时设置上下文窗口
ollama run qwen2.5:7b-q4_K_M --num-ctx 2048

# 写入 Modelfile 永久生效
Modelfile 内容示例:
FROM qwen2.5:7b-q4_K_M
PARAMETER num_ctx 2048
PARAMETER num_gpu 99
PARAMETER temperature 0.7
# 基于 Modelfile 创建自定义模型
ollama create myqwen -f Modelfile
ollama run myqwennum_ctx 从 4096 砍到 2048 通常能省下 0.5 – 1 GB 显存(社区常见经验值),对生成质量影响不大,但响应速度会明显变快。步骤 4:使用 --num-gpu 控制 GPU 卸载层数
Ollama 默认会把模型尽可能塞进显存,如果显存不够就会 OOM。手动控制 GPU 卸载层数能让模型部分跑在内存上:
# 把模型分成若干层,只卸载一定层数到 GPU(具体层数看模型架构)
ollama run qwen2.5:7b-q4_K_M --num-gpu 20步骤 5:启用 CPU 混合推理(显存实在不够时)
如果你发现 7B 模型 Q4_K_M 都跑不动,或者机器本身显存只有 6GB(如部分旧款 G14):
# 完全用 CPU 推理(会慢,但保证能跑)
OLLAMA_NUM_GPU=0 ollama run qwen2.5:7b-q4_K_M

# 或者临时禁用 GPU
ollama run qwen2.5:3b --num-gpu 0
性能会从 GPU 推理的较高速度跌到 CPU 推理的较慢水平(具体速度取决于 CPU 主频与内存带宽),但至少能正常对话。如果遇到的是 Vulkan 后端显存不足或 ROCm 环境报错,可参考 YingxiangHub: Ollama 模型加载失败修复指南 调整后端配置。
步骤 6:禁用核显(混合显卡机型专项优化)
G14 这类采用 NVIDIA Optimus 混合显卡的机器,核显(iGPU)有时会和独显产生调度冲突,或者在 Linux 下占用部分系统内存作为「共享显存」。这一招对显存吃紧的 8GB 机器往往有意想不到的效果:
- Windows:在 NVIDIA 控制面板 → 管理 3D 设置 → 全局设置 → 首选图形处理器,选择「高性能 NVIDIA 处理器」;再把 Ollama 程序单独指定为使用独显。
- Linux(以 Ubuntu 为例):
# 切换到独显模式
sudo prime-select nvidia
# 重启后生效- BIOS:如果 BIOS 提供核显开关(如部分 G14 高配版),可以直接关闭核显,省下核显占用的那部分系统内存(通常为 512MB – 2GB 不等)。
步骤 7:升级驱动 & Ollama 版本
# 检查当前驱动版本
nvidia-smi

# 社区常见建议:
# - RTX 40 系列移动显卡:使用较新的稳定版驱动(社区推荐 555.x 及以上分支)
# - RTX 50 系列移动显卡(如 RTX 5070 Mobile):需要更新版本的驱动分支(社区推荐 580.x 及以上)
# - Ollama 客户端:升级到 0.10.x 之后的版本
如果你用的是 RTX 5070 Mobile(2026 年新机常见配置),Ollama 需要更新到 0.10.x 之后才能完整调用新架构特性,否则可能出现「能识别但跑不动」的情况。如果是在 Docker 容器内运行遇到「跑着跑着从 GPU 切回 CPU」的问题,可参考 TechPassive: Ollama 本地部署 5 大坑 中的对应章节排障。
步骤 8:清理显存碎片 + 释放缓存
长时间使用后,CUDA 显存可能出现严重碎片化。Linux 下可以依次执行:
# 先停掉 Ollama 服务,释放显存占用
sudo systemctl stop ollama

# 确认 Ollama 进程已退出
systemctl status ollama

# (可选)尝试重置 GPU —— 注意 sudo nvidia-smi --gpu-reset
# 在绝大多数消费级显卡(GeForce 系列,包括 RTX 4060/4070/5070 Mobile)
# 上并不开放,仅部分专业卡(如 Tesla / A 系列)支持。
# 消费级卡遇到显存残留,最稳妥的还是重启系统。

# 重新启动 Ollama 服务
sudo systemctl start ollama
Windows 下则可以在任务管理器里结束 ollama.exe 进程,再重新打开 Ollama。官方对 Windows 端日志路径的说明可查阅 Ollama 故障排除文档。
同时关闭所有不必要的 Python / Jupyter Notebook 进程,它们会持有显存不释放。
步骤 9:终极方案——换更大显存的机型
如果以上方法都不够用,说明你的需求已经超出 8GB 显存的承载能力。截至 2026 年 9 月,搭载 12GB 或 16GB 显存的笔记本选择明显增多,预算充足的话基本可以一步到位告别 OOM。
8GB 显存跑得动的模型清单(2026 年 9 月整理)
以下清单按社区常见实用度排序,显存占用数值为大致参考(具体取决于模型架构与量化实现):
| 模型 | 量化建议 | 大致显存占用 | 推荐度 |
|---|---|---|---|
| Qwen2.5-3B | Q4_K_M | 轻量(数 GB 以内) | ★★★★★ 入门首选 |
| Phi-4(3.8B) | Q4_K_M | 轻量 | ★★★★★ 推理强、速度快 |
| Gemma 3-4B | Q4_K_M | 中等偏轻 | ★★★★☆ 多语言优秀 |
| Qwen2.5-7B | Q4_K_M | 中等(约 4 GB 量级) | ★★★★★ 综合性价比天花板 |
| Llama 3.1-8B | Q4_K_M | 中等 | ★★★★☆ 英文任务首选 |
| Mistral-7B | Q4_K_M | 中等 | ★★★★☆ 老牌稳 |
| Qwen2.5-14B | Q4_K_M | 紧贴上限 | ★★★☆☆ 紧贴上限,需配合 num_ctx=2048 |
| Llama 3.1-70B | Q4_K_M | 远超 8GB | × 完全跑不动,别试 |
G14 vs RTX 5070 Mobile:2026 年新机对比
截至 2026 年 9 月,新一批 G14(GA605 系列)开始搭载 RTX 5070 Mobile(8GB GDDR7)。和老款 RTX 4060 移动版相比:
| 项目 | RTX 4060 Mobile(8GB GDDR6) | RTX 5070 Mobile(8GB GDDR7) |
|---|---|---|
| 架构 | Ada Lovelace | Blackwell |
| 显存带宽 | 公开规格(具体以 NVIDIA 官方 SKU 为准) | 较 4060 移动版有所提升(具体以官方 SKU 为准) |
| Ollama 兼容性 | 成熟稳定 | 需要较新驱动 + Ollama 0.10.x 之后 |
| 7B Q4_K_M 推理速度 | 基线参考 | 普遍快一些(实际取决于功耗释放与散热) |
| 14B Q4_K_M | 紧贴上限 | 同样紧贴上限(显存没变大) |
说白了,RTX 5070 Mobile 的 8GB 和 RTX 4060 的 8GB 在「能跑多大模型」这件事上是同一档——显存容量才是瓶颈,架构升级带来的是速度提升,不是容量提升。所以即使你换了 2026 年的新机,上面这套调参方法一样适用。
联想拯救者 R9000X / 戴尔 XPS 15 / 雷蛇灵刃 14 平移指南
这几台机器的共同点是:同样搭载 8GB 显存的 NVIDIA 移动显卡。故障表象和上面 G14 的报错几乎一模一样,排查方法可以完全平移:
1. 联想拯救者 R9000X(RTX 4060/4070 Mobile):拯救者自带的 Legion Zone 软件会常驻后台,建议在跑 Ollama 前先关掉,否则显存可能被偷走几百 MB。
2. 戴尔 XPS 15(RTX 4060 Mobile):Dell SupportAssist 的硬件加速监控同样会占显存,建议禁用。
3. 雷蛇灵刃 14(RTX 4060/4070 Mobile):Razer Synapse 的灯效和性能调度模块会常驻,关掉后能省一点显存。
操作上和 G14 完全一致:nvidia-smi 看占用 → 关后台 → 选 Q4_K_M 量化 → 调 num_ctx → 必要时 OLLAMA_NUM_GPU=0。
FAQ(常见问题)
model requires more system memory 怎么解决?ollama run qwen2.5:14b-q4_K_M --num-ctx 1024 --num-gpu 25,把上下文砍到 1024、只卸载部分层到 GPU,速度会慢但能跑起来。