
华强北固态硬盘选购:扩容升级避坑指南
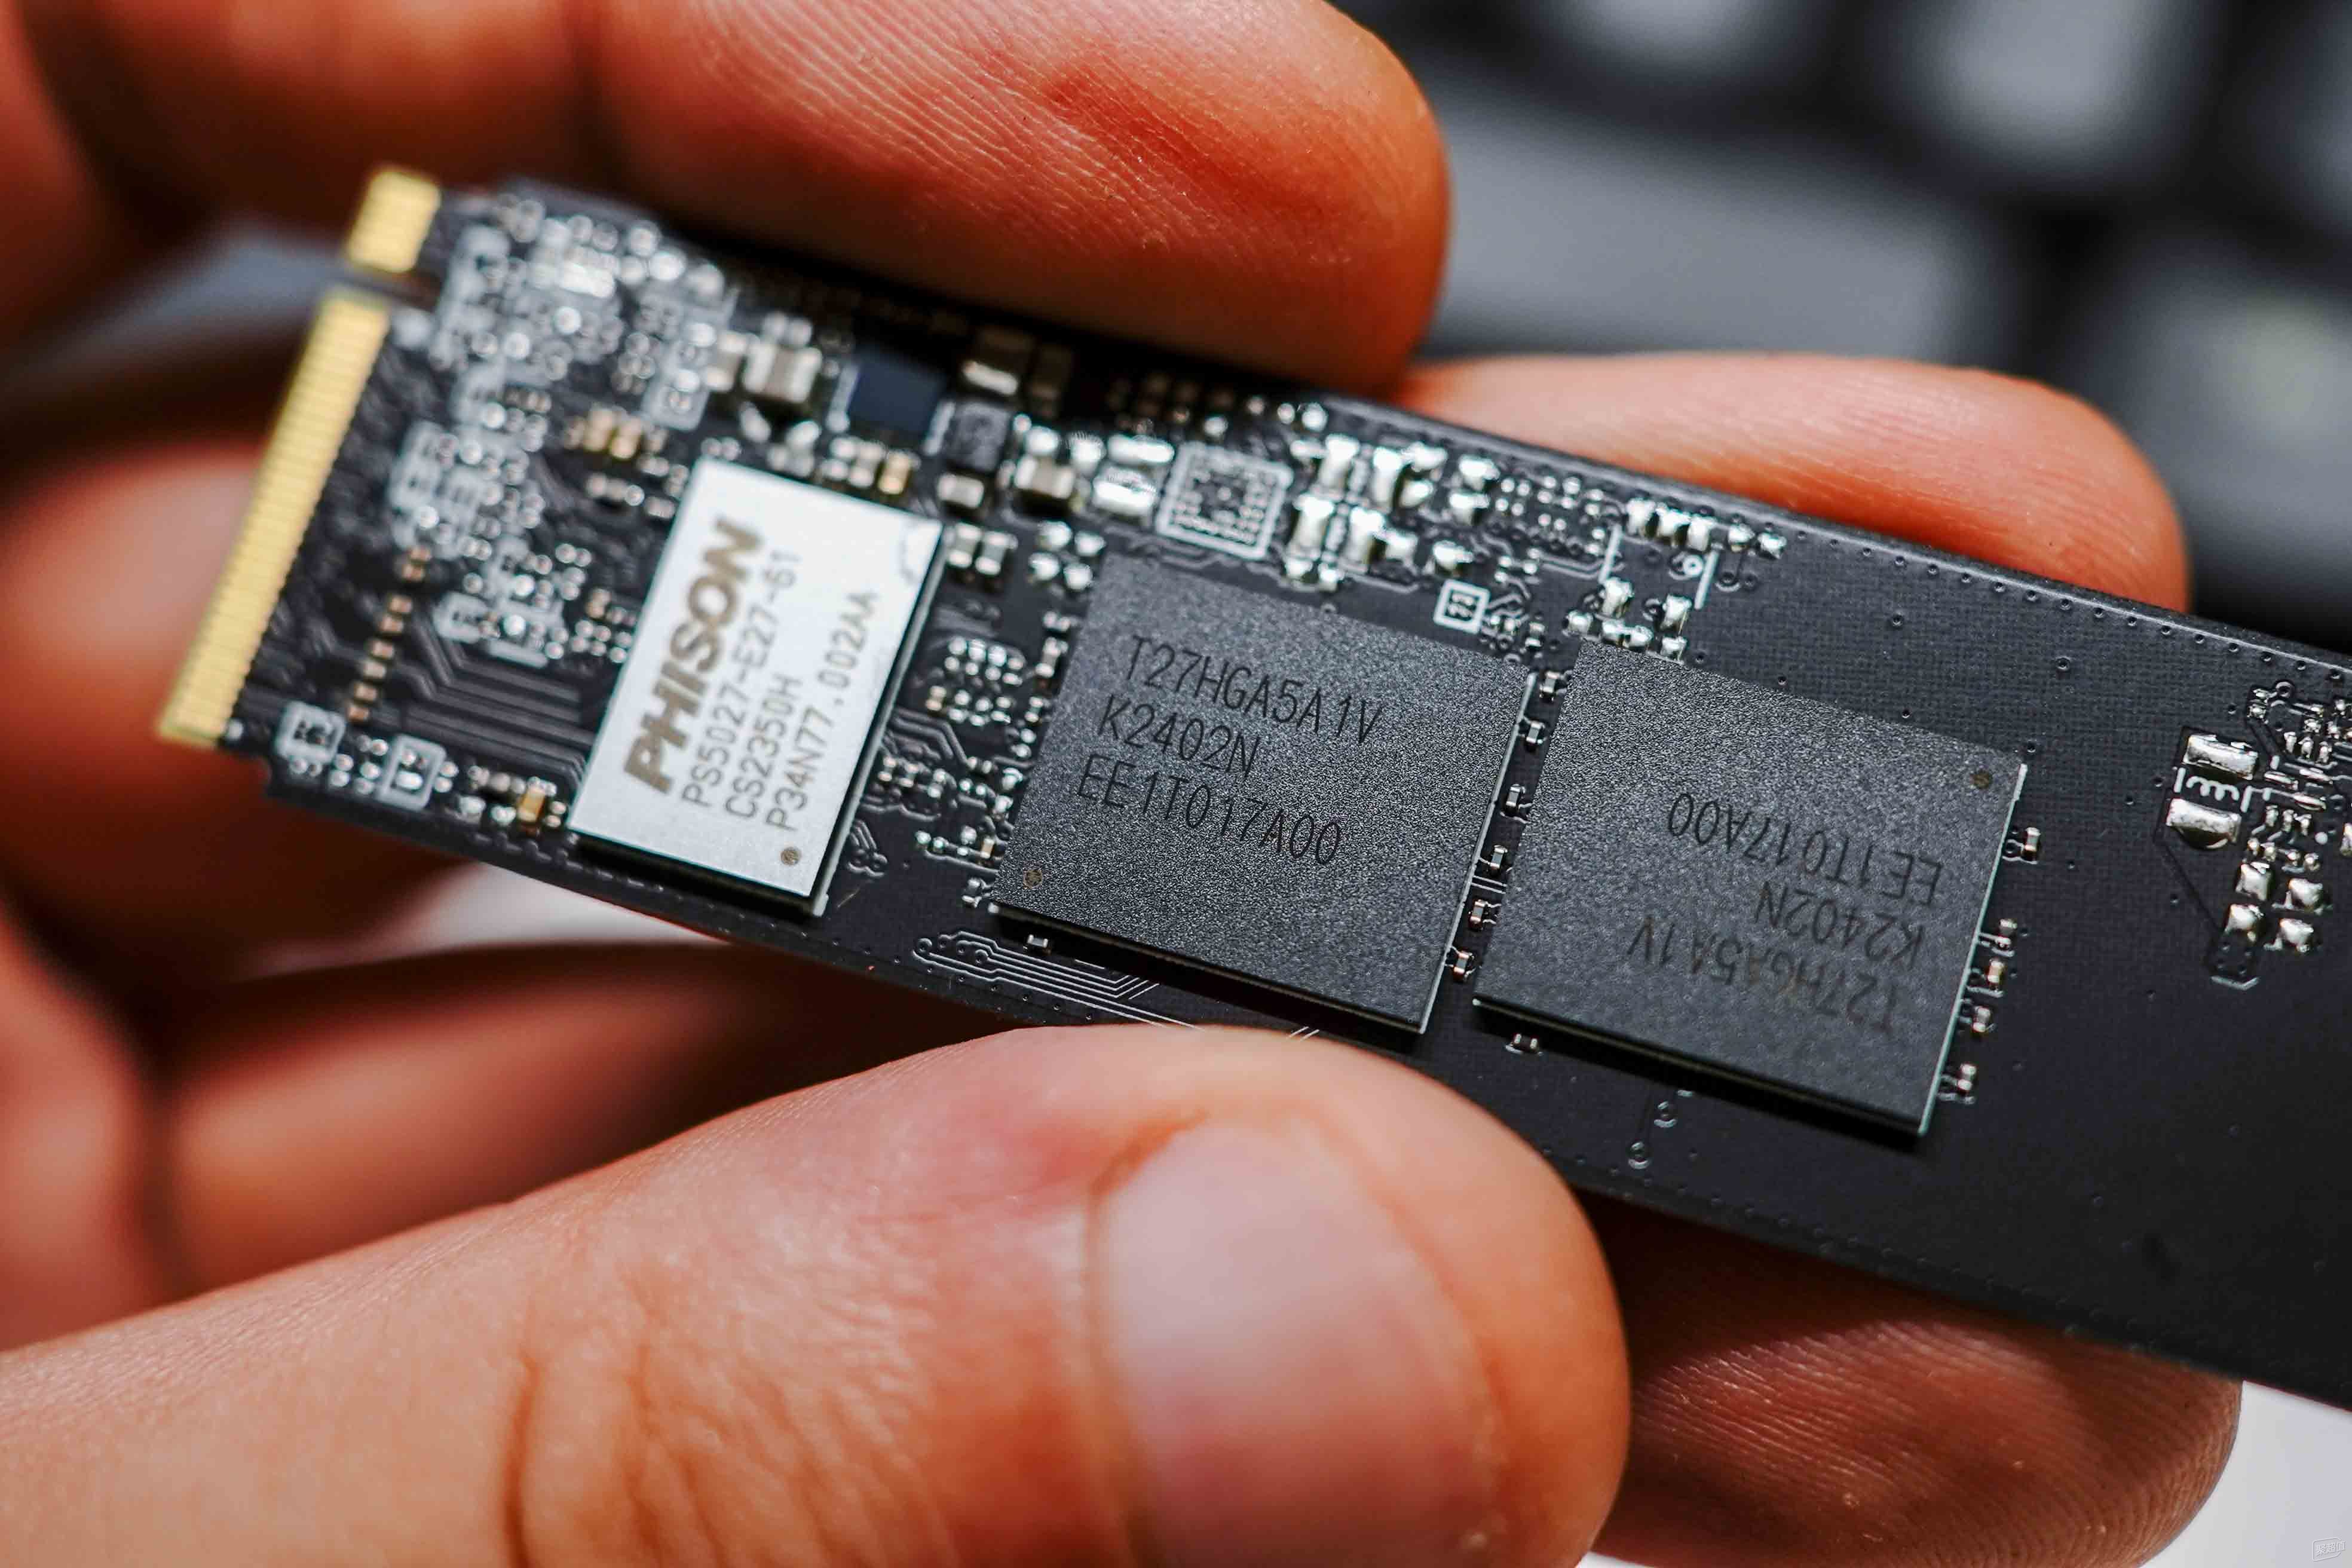
固态硬盘这几年价格跌得离谱,身边不少朋友开始琢磨给老笔记本、台式机、甚至 NAS 扩容。说真的,现在的行情确实适合入手,但华强北这片市场水深得很——同一颗主控、同一批 NAND 颗粒,贴上不同牌子,价格能差出几十上百。本文基于近期在华强北实地走访和实测经验,把扩容升级里最容易踩的坑、必须搞懂的参数、靠谱的选购逻辑梳理一遍。

一、先搞清楚自己到底要”扩什么”
扩容不是无脑买最大的盘就行。先问自己三个问题:
- 接口是什么? M.2 NVMe(M key)、M.2 SATA(B+M key)、mSATA、2.5 寸 SATA,这四种物理形态在老设备上经常混淆。
- 协议版本? NVMe 1.3、1.4、3.1、4.0、5.0 都有,但主板支持的 PCIe 通道数决定了带宽上限。比如 B660 主板只有 CPU 直出的 M.2 槽才支持 PCIe 4.0×4,南桥出来的槽位往往只有 PCIe 3.0×4。
- 容量天花板? 部分老主板 BIOS 对 2TB 以上 NVMe 盘识别有问题,特别是 2017 年以前的平台。
举几个典型场景:
- 老 ThinkPad(如 T480)想升级:基本是 M.2 2242 NVMe 槽,注意长度兼容性。
- 拯救者 R7000 2020 款:双 M.2 槽位,主槽支持 PCIe 3.0×4,副槽走南桥 PCIe 3.0×2,加盘时速度会砍半。
- MacBook Pro 2015 之前:基本只能走 mSATA 或专用接口,扩容方案有限。
接口和协议没搞清就下单,到手插不上或者只能跑半速,钱白花。
进阶提示:拆开笔记本后盖前,先用 wmic diskdrive get model,size,interfaceType 命令确认现有硬盘的接口类型;或者下载 HWiNFO、CPU-Z 查看主板芯片组支持的 PCIe 通道数。这一步能避免 80% 的”买错盘”事故。
二、华强北常见货源与”坑位”分类
1. 工包/散片:价格香,售后悬
华强北档口最常见的就是工包盘——没有零售包装,只有一个防静电袋加一张散装贴纸。来源主要是 OEM 渠道流出或工厂尾货。
- 优势:单 GB 成本明显低于行货,同容量能便宜 15%~30%。
- 风险:
- 无正规售后。出问题基本只能找卖家,走不了品牌官方渠道。
- 翻新盘概率存在。部分回收 NAND 重新打标的产品,外观全新但实际剩余寿命堪忧。
- 固件版本不可控。OEM 固件和零售版不同,部分功能(如加密、Secure Erase)可能阉割。
如果是给主力办公机或者存重要数据的盘,工包要慎重。
2. 拆机盘:便宜但”生命值”未知
服务器拆机盘(如某些数据中心淘汰的 U.2 NVMe 或 SATA SSD)在档口很常见,价格低到离谱。
- 优点:企业级颗粒质量通常不错,耐久度(DWPD)远高于消费级。
- 致命问题:
- 剩余写入量不可查。即使有 SMART 信息,普通软件读出来的”已用百分比”和企业级判定标准不一样。
- 接口形态特殊。U.2 盘需要转接卡才能上消费级主板。
- 写入策略激进。做读密集型应用可以,做系统盘可能出现响应延迟。
不建议小白碰拆机盘,除非你能看懂 SMART 数据并且接受折腾。
3. 国行全新 vs 水货
| 对比项 | 国行全新 | 水货 |
|---|---|---|
| 包装配件 | 齐全 | 简配或散装 |
| 售后渠道 | 官方联保 3~5 年 | 卖家店保,半年到一年 |
| 价格 | 标准零售价 | 低 10%~25% |
| 固件版本 | 大陆定制版 | 海外通用版 |
| 防伪标签 | 完整 | 可能缺失或被刮 |
差价不大时优先国行。差价超过 20% 时,再根据自己的数据重要程度权衡。
4. 杂牌与”贴牌”
华强北有些档口卖一些没听过的小牌子,贴个英文 LOGO 就当”国际大牌”。说白了,很多就是深圳本地小厂出的公模方案,主控可能是群联、慧荣的公版固件,颗粒来源复杂。
判断要点:
- 颗粒标签是否能查到原厂(如三星、铠侠、美光、长江存储、SK 海力士)批次号。
- 主控型号是否公开可查。
- 是否提供主控厂商的固件更新工具。
三项里有一项对不上,就要打问号。
5. “特殊渠道”盘:警惕法律风险
市面上偶尔能看到标注”工厂样品”、”测试版”、”评估版”的 NVMe 盘,价格极低。这类产品往往:
- 是工程验证阶段的样品,未通过最终量产测试。
- 固件存在已知 Bug,可能在特定工况下掉盘。
- 部分涉及品牌厂商内部流出,存在合规问题。
不建议普通消费者碰这类盘,数据安全没保障。
三、NAND 颗粒基础知识:不只是 TLC 和 QLC
很多消费者只关注容量和价格,忽略了颗粒本身的差异。这一节展开讲一下底层原理。
1. 按单元存储位数分类
- SLC(Single-Level Cell):每个单元存 1 bit,速度最快、寿命最长(10 万次 P/E),但成本极高,目前仅用于企业级。
- MLC(Multi-Level Cell):每个单元存 2 bit,寿命约 3 千~1 万次 P/E,曾经是中端主力,现在基本停产。
- TLC(Triple-Level Cell):每个单元存 3 bit,寿命约 1 千~3 千次 P/E,目前消费级主流。
- QLC(Quad-Level Cell):每个单元存 4 bit,寿命约 500~1 千次 P/E,密度高成本低,但写入掉速明显。
家用场景 TLC 足够,QLC 做数据盘可以,做系统盘建议避开。
2. 按品质分级
同一晶圆上切割下来的颗粒,品质分级从高到低大致是:
- 正片(Original):原厂封装、原厂 logo、通过完整测试。
- 白片(Partial Good):原厂晶圆,第三方封装,部分 Die 存在瑕疵,被降级使用。
- 黑片(Reclaimed):原厂测试未通过的晶圆,流入下游市场被翻新。
华强北便宜盘里,白片是常态,黑片则是坑中之坑。判断方法:看颗粒表面的激光打标是否清晰规则,型号是否能在原厂官网查到。
3. 3D 堆叠层数
层数越高,密度越大,成本越低,但不代表性能越强:
- 铠侠 BiCS 5 是 112 层 TLC。
- 美光 232 层 TLC 是当前消费级主流。
- 三星 V-NAND 7 代(V7)约 176 层。
- 长江存储 X3-9070 为 232 层 TLC,自研架构。
层数提升对厂商意味着成本下降,对消费者意味着同价格能买到更大容量,但写入延迟通常会略有上升。
四、关键参数怎么读——别被”顺序读写”忽悠
广告里动辄”7000MB/s 读速”,但扩容升级场景下,顺序读写速度不是核心指标。真正决定日常体验的几个参数:
1. 4K 随机读写(IOPS)
系统启动、软件加载、游戏读图,本质都是大量小文件随机读写。NVMe 盘之间的 4K 随机性能差距远大于顺序性能差距。
- PCIe 3.0×4 入门级:4K 随机读约 200K IOPS 左右。
- PCIe 4.0×4 中端:4K 随机读约 400K~700K IOPS。
- PCIe 5.0×4 旗舰:4K 随机读破百万 IOPS。
老平台升级,顺序速度再快也只能跑出 PCIe 3.0×4 的上限(约 3500MB/s),4K 性能反而更影响体验。
2. TBW(总写入字节数)
这是耐久度指标,直接关系盘能用多久。
- 入门级 1TB NVMe:TBW 通常 200~300TB。
- 中端 1TB NVMe:TBW 300~600TB。
- 企业级 1TB:TBW 可达几千 TB。
普通家用,一年写入量一般不超过 10~20TB,TBW 对绝大多数用户不是瓶颈。但如果你是视频剪辑师、跑虚拟机、下载狂魔,TBW 要重点看。
3. DRAM 缓存 vs 无缓设计
- 有外置 DRAM:4K 随机性能稳,写放大控制好,适合做系统盘、数据库。
- HMB(主机内存缓冲)无缓:靠占用系统内存模拟缓存,成本低,4K 性能略弱但日常够用。
- 全盘模拟 SLC 缓存:写入先到缓存区,缓存耗尽后掉速明显。
扩容做数据盘的话,HMB 方案性价比高;做系统盘建议优先选有 DRAM 缓存的型号。
4. 主控与颗粒制程
主控决定性能天花板和功耗,颗粒决定成本和寿命。
- 主控第一梯队:三星自研、铠侠自研、群联 PS5025-E25(高端)、慧荣 SM2264。
- 颗粒第一梯队:三星 V-NAND、铠侠 BiCS、美光 176 层/232 层 3D TLC、SK 海力士 176 层、长江存储 X3-9070。
华强北有些便宜盘用的是白片或降级片(颗粒厂挑剩下的次品),稳定性不如原厂正片。
5. 写入放大系数(WA)
普通用户感知不到,但对 SSD 寿命影响很大。WA 越低,实际写入 NAND 的数据量越接近主机写入量,盘越耐用。优质主控能把 WA 控制到 1.5 以内,差的主控在随机写入下可能飙升到 5~10。
五、不同扩容场景的实测推荐逻辑
场景 1:老笔记本升级(容量翻倍或换系统盘)
接口多为 M.2 2242 或 2280,PCIe 3.0。
- 看预算:500 元以内选国产长江存储颗粒方案(如致钛、爱国者部分型号),1TB 够用。
- 看兼容:部分老笔记本对无缓盘兼容性差,建议优先选有 DRAM 缓存型号。
- 看温度:老本散热弱,无缓低功耗盘更合适。
场景 2:台式机加盘(数据盘、副盘)
主板有空闲 M.2 槽或 2.5 寸 SATA 位。
- M.2 槽优先:选 PCIe 3.0×4 性价比盘即可,顺序读 3000MB/s 级别就够。
- SATA 槽:选 2.5 寸 SATA SSD,重点看 4K 随机和价格,顺序读写都跑在 SATA 上限(约 550MB/s)。
场景 3:NAS 或冷存储扩容
写入密集、长期运行。
- 优先企业级或 NAS 专用型号(如希捷酷狼 SSD、西部数据 Red SSD)。
- 看 MTBF(平均无故障时间)和保修年限。
- 避免用低端消费级 TLC 盘做频繁写入。
场景 4:PS5 / 游戏主机扩容
PS5 官方要求 PCIe 4.0×4 NVMe,读取速度 ≥ 5500MB/s。
- 必须带散热片(PS5 槽位有金属马甲位)。
- 单面颗粒设计更友好,厚度不超过 11.25mm。
- 容量建议 1TB 起,2TB 性价比更高。
场景 5:剪辑工作站 / 大模型训练
高并发读写、长时间满载。
- 优先考虑 PCIe 4.0 或 5.0 中高端型号。
- 必须带 DRAM 缓存,且 TBW ≥ 600TB(1TB 容量基准)。
- 强烈建议组 RAID 0 或 RAID 10 提升吞吐,配合 UPS 防止异常掉电。
六、华强北现场验盘的几个硬核动作
去档口拿货,别只听老板吹。掏出手机做这几件事:
1. CrystalDiskInfo 看通电时间和写入量
全新盘通电次数应该是个位数(0~5 次),通电时间 0 小时。如果显示已经跑了上千小时,直接放下。
2. 查看 SMART 信息中的关键项
- PE Cycle Count(颗粒擦写次数):超过标称 TBW 的一定不买。
- Unexpect Power Loss Count(异常掉电次数):高数值意味着可能经历过突发断电,NAND 有潜在损伤风险。
- Media and Data Integrity Error:非零就别考虑。
- CRC Error Count(CRC 错误计数):非零说明链路不稳定,可能是接口或主控问题。
3. 用厂商工具验证
三星用 Magician、铠侠用 SSD Utility、西部数据用 Dashboard,能识别说明是正品+正品固件。识别不了或提示”未知型号”,就有问题。
4. 全盘写入测试
用工具(如 AIDA64、urwtest、TxBench)跑一次全盘写入,观察:
- 是否有明显掉速点(说明 SLC 缓存大小)。
- 掉速后的稳态速度(决定大文件持续写入能力)。
- 是否出现 IO 错误或掉盘。
跑完 1~2 小时没出问题,基本可以确认盘体没问题。
5. 协议握手检测
用 HWiNFO 查看当前 PCIe 协商速率,确认是否跑到了盘体标称的 ×4 通道。如果显示 ×2 或 ×1,说明主板槽位或 BIOS 设置有问题。
七、扩容后的几个关键设置
买到靠谱盘只是第一步,扩容后这些设置能再提升一截体验:
1. 确认主板 BIOS 已更新
部分老主板需要更新 BIOS 才能完整识别新主控的盘,识别不全可能导致只跑 PCIe 3.0×2。
2. 启用 AHCI / NVMe 模式
老系统迁移时容易遇到”装在 IDE 模式”的尴尬,性能直接腰斩。
3. 关闭磁盘碎片整理
SSD 不需要碎片整理,整理反而增加写入损耗。Windows 默认对 SSD 自动优化是 TRIM,不是碎片整理,确认下就好。
4. 检查 4K 对齐
用工具(如 AS SSD Benchmark)看分区起始偏移是否为 1024KB 的整数倍(默认应该是,但手动调整过分区的话可能错位)。
5. 散热不能省
NVMe 盘满载温度动辄 70~80°C,加个散热片或者机箱风扇吹一下,掉速阈值能延后不少。
6. 启用 TRIM
Linux 下用 fstrim 定期执行,Windows 默认开启。如果用 RAID 或特殊文件系统,TRIM 路径需要手动配置。
7. 电源策略调整
Windows 电源选项里把硬盘休眠时间拉长,避免频繁唤醒造成不必要的写入。Linux 下可以用 hdparm -S 0 关闭 standby。
八、数据迁移的实操细节
扩容往往涉及”旧盘数据搬到新盘”,这一步也是坑密集区:
1. 工具选择
- Acronis True Image / Samsung Data Migration:品牌专用,对自家盘支持最好。
- Clonezilla:开源免费,灵活度高,但要会命令行。
- Macrium Reflect:付费但稳定,适合 Windows 全盘克隆。
2. 常见翻车点
- 克隆后无法启动:多半是引导分区没正确克隆或 BIOS 引导顺序未调整。
- 克隆后容量缩水:源盘是 MBR、分区表未对齐新盘的大容量。
- 克隆速度极慢:USB 2.0 转接卡是常见瓶颈,建议直接挂 SATA/NVMe 接口克隆。
3. 全新装机的建议
如果旧盘数据不重要,直接全新装系统更干净:
- 用 Ventoy U 盘启动盘加载 Windows ISO。
- 安装时删除旧分区,避免残留 EFI 区。
- 安装完成后第一时间装主板驱动、NVMe 驱动。
九、一些容易翻车的”小细节”
- 标称容量与实际可用:1TB 标称实际约 931GB,这是十进制 vs 二进制的换算,不是坑。
- 5 年保修的覆盖范围:部分品牌保修不包括”颗粒写入量超标”导致的损坏,要看清楚条款。
- M.2 螺丝刀:老笔记本螺丝规格奇葩(部分用 0.8mm 六角),提前准备工具。
- 系统迁移的坑:用第三方工具(如 Acronis True Image)迁移后,注意检查引导项是否正确,否则会进不去系统。
- 散热马甲的高度:部分 M.2 马甲太厚,笔记本盖不上后盖,购前量好限高。
- 主板 M.2 槽散热片胶:有些出厂自带散热片的槽位,硅胶垫和盘体贴合不紧会影响导热,可自己加导热硅脂垫改善。
- 加密与 OPAL 协议:部分商务本开启 BitLocker 或 eDrive 后,无 DRAM 缓存或低端主控可能性能暴跌。
十、华强北采购的”软技能”
除了硬件本身,现场谈判和判断也重要:
1. 选档口时段
工作日上午 10 点前档口刚开门,老板心情好,价格弹性大。周六周日客流高峰,价格反而硬。
2. 多问几句”为什么便宜”
老板如果说”渠道货”、”工厂尾货”、”海关扣押”等模糊话术,要追问批次号、出厂日期。答不上来的大概率有猫腻。
3. 关注售后条款
明确写入收据:保修期多久、保修范围(是否覆盖掉盘)、出问题退换还是维修。一般档口默认店保 3 个月到 1 年,能承诺 2 年以上的相对靠谱。
4. 留存凭证
拍照保存:盘体 SN 码、店家店面、收据、聊天记录。后续维权全靠这些。
十一、SSD 故障的前兆与抢救
扩容后盘体出现异常,知道怎么判断能避免数据全丢:
1. 常见故障前兆
- 系统偶尔卡顿几秒,然后恢复——可能是主控在重映射坏块。
- CrystalDiskInfo 健康度从 100% 掉到 80% 以下——寿命告急。
- 文件突然打不开或变成 0 字节——文件系统损坏征兆。
- 盘体偶尔掉识别、BIOS 里找不到——主控或接口接触不良。
2. 数据抢救原则
- 第一时间停止写入。新写入可能覆盖坏块附近的可恢复数据。
- 不要重装系统。重装会格式化整盘。
- 用专业工具恢复:R-Studio、DiskGenius 专业版。
- 物理损坏(异响、烧焦味):立刻断电,送专业数据恢复机构。
3. 备份策略
扩容升级完不是终点,建立 3-2-1 备份原则才稳:
- 3 份数据副本。
- 2 种不同介质(如 SSD + HDD)。
- 1 份异地备份(云盘或异地硬盘)。
十二、写在最后
华强北这片市场,机会和陷阱并存。扩容升级这件事,本质不是”买最贵的”或”买最便宜的”,而是”买最匹配自己设备和用途的”。
搞清楚接口协议、看清颗粒主控来源、用工具验过 SMART、跑过全盘写入,基本就不会翻大车。剩下的差价,取决于你对售后的重视程度和对风险的承受力。
核心要点速览:
- ✅ 先确认接口和协议,再看容量
- ✅ 工包盘慎碰,拆机盘看 SMART
- ✅ 顺序速度不重要,4K 随机才是体验核心
- ✅ 系统盘选有 DRAM 缓存,数据盘可上 HMB 方案
- ✅ 现场验盘别偷懒,厂商工具识别 + 全盘写入测试
- ✅ 扩容后检查 4K 对齐、TRIM、散热三大件
- ✅ 任何时刻,建立 3-2-1 备份比挑盘更重要
如果你近期也在搞扩容升级,欢迎评论区聊聊你的配置和使用场景,一起交流避坑经验。也欢迎分享你买到的”神价”或者踩过的雷,给后来人做个参考。
如需选购适合的笔记本电脑,可参考 Thinkpad深圳报价。

ThinkPad E14 2025 双版本实测对比:AMD 与 Intel 在续航、发热与 RAID 配置上的体感差异
ThinkPad E14 这条线挺尴尬——入门商务定位,价格不算贵,可配置一多就让人选择困难。2025 款同时存在 AMD 和 Intel 两条线,最近后台问怎么选的朋友不少。我手头两台都用过一段时间,今天就聊三个点:续航、长时负载下的发热与降频、双盘位 RAID 配置的实际差异。屏幕色域、键盘手感这些主观维度先按下不表。如果你正在挑 2025 款商务轻薄本,或者对 E14 这条入门线感兴趣,希望这篇能帮你少踩几个坑。
一、先看核心差异一览
| 对比项 | ThinkPad E14 2025 AMD 版 | ThinkPad E14 2025 Intel 版 |
|---|---|---|
| 典型处理器 | Ryzen 5 7535U / Ryzen 7 7735U / Ryzen 7 8840HS 等 | Core Ultra 5 125U / Ultra 5 135U / Ultra 7 155H 等 |
| 制程工艺 | 台积电 6nm(Zen 3+)/ 台积电 4nm(Zen 4,视批次) | Intel 4(计算模块)+ 台积电 N6/N5(SoC 与 I/O 模块) |
| 集显 | Radeon 660M/680M(RDNA 2)、Radeon 780M(RDNA 3,视批次) | Intel Graphics / Arc Xe-LPG 核显(视型号) |
| NPU | 7040/8040 系列集成 Ryzen AI(XDNA),7035 系列无独立 NPU | Intel AI Boost NPU(约 11 TOPS) |
| 内存形态 | 板载 8/16GB + 单/双 SO-DIMM(视批次) | 板载 8/16GB + 单/双 SO-DIMM(视批次) |
| M.2 盘位 | 1× M.2 2280;部分批次预留 2242 第二盘位 | 1× M.2 2280;部分高配预留第二盘位 |
| RAID 支持 | 视主板设计,部分批次带 AMD RAIDXpert2 | 视主板设计,部分批次带 Intel VMD |
| 标称电池 | 47Wh 或 57Wh 两种规格 | 47Wh 或 57Wh 两种规格 |
| 适配器 | 65W USB-C(标配)/ 100W(选购) | 65W USB-C(标配)/ 100W(选购) |
| Wi-Fi | Wi-Fi 6 / Wi-Fi 6E(部分 Wi-Fi 7) | Wi-Fi 6E / Wi-Fi 7(视批次) |
| 雷电接口 | 一般不提供 / 部分高配 USB4 | 部分批次支持 Thunderbolt 4 |
| 典型重量 | 约 1.64 kg 起 | 约 1.64 kg 起 |
1.1 处理器架构层面的本质差异
聊实测前先把架构差异摆出来,否则后面讲的功耗、发热都缺乏根基。
AMD 端:E14 2025 的 AMD 版主力还是 Ryzen 7035 系列(Zen 3+ 架构,代号 Rembrandt-R),本质上是 2022 年 Ryzen 6000 系列的延续与小幅改良。制程仍是台积电 6nm,IPC 相比 Zen 3 没有质变,但电源管理优化得不错。也有少量批次会用上 Ryzen 8040HS 系列(Zen 4 / Hawk Point),不过 E14 这种偏入门的机型上不算常见。Zen 3+ 的特点是单核不算拔尖,但多核能效比优秀,频率可以长时间维持在中高区间而不容易撞温度墙。
Intel 端:2025 款 E14 Intel 版主要采用 Core Ultra 100 系列(Meteor Lake),少量批次会用到 Core Ultra 200H 系列(Arrow Lake-H)。Meteor Lake 是 Intel 首款 chiplet 设计的消费级 CPU——计算模块用 Intel 4(7nm EUV 等效),SoC 与 I/O 模块外包给台积电 N6/N5。这种架构在低负载时可以把整个计算模块关掉,仅靠低功耗岛(LPE 核)维持后台任务,对续航利好;但一旦上负载,需要重新唤醒性能核,功耗曲线呈现”短时猛、持续降”的特征。
二、续航:AMD 版总体占优,但差距没你想的那么大
2.1 测试条件说明
- 屏幕亮度统一设置到约 150 nits(Win11 内置校准工具实测)
- 键盘背光关闭,蓝牙关闭
- Wi-Fi 6E 连接企业级路由器,距离 3 米无墙阻隔
- 系统为 Windows 11 23H2,电源模式”平衡”
- BIOS 与 Vantage 均为官方最新
- 测试软件:PCMark 10 Modern Office、PCMark 10 Applications、本地视频循环播放
2.2 分场景实测体感
以下都是个人体感区间,电池个体差异、屏幕批次、系统后台都会有影响,仅供参考:
- 低负载(文档 + 浏览器,亮度 40%,Wi-Fi 开):AMD 版能撑到 9–11 小时区间;Intel Ultra 5 125U 这颗低功耗型号也能到 8–10 小时。如果是 Ultra 7 155H 性能释放拉满那种,掉到 6–8 小时很正常。AMD 的能效比优势在低频工况下体现得最明显,这点不用多说。
- 中高负载(视频会议 + Office 多开 + 偶尔编译):差距收窄到 1–1.5 小时左右,AMD 仍领先。视频会议对续航的拖累远大于普通办公——摄像头、麦克风、编解码同时工作,能让整机功耗瞬间拉到 15W 以上。AMD 版在 Teams / 腾讯会议 / Zoom 这类场景下能撑 5–6 小时,Intel Ultra 7 155H 大概 4–5 小时。
- 本地视频播放(1080p H.264 + HEVC 混合):AMD 版优势进一步缩小,硬件解码这块 Intel 反而略稳。Meteor Lake 集成的 Xe 媒体引擎对 AV1、HEVC 的硬解效率与 Radeon 680M 互有胜负,并不构成单边碾压。如果你经常出差看片追剧,Intel 版的视频续航并不会明显输给 AMD。
- AI 推理类负载(本地 LLM 量化模型):AMD Radeon 780M 在跑 Stable Diffusion / Ollama / LM Studio 这类工具时体验稍好,单位时间能耗控制得更稳;Intel Arc 核显在部分负载下速度会慢一些,耗电也略高。但这类对比受驱动版本影响很大,结论别太绝对。
2.3 影响续航的几个隐藏开关
- 电源策略、Windows 电源模式、BIOS 里的 “Battery State of Health” 阈值都会显著影响实际续航。ThinkPad 自带的 Vantage 里那个 “Always On USB” 关掉后能省电,很多人根本不知道这个开关。
- “USB Always On”:默认开启,关掉后可省一点电(具体幅度因机型而异)
- “Wake on LAN”:办公场景刚需,出差场景建议关
- “电池阈值”:可在 Vantage 中设置充电上限(一般推荐 80% 或 60%),长期插电场景能延长电池寿命
- “Modern Standby” 与 “S3” 睡眠:E14 默认 Modern Standby(待机功耗约 0.5–1W),但部分老设备会与 RAID 配置冲突(后面会讲到)
- 后台应用:Windows 11 自带 OneDrive、Teams、Xbox 等后台服务在首次开机时非常耗电,建议手动清理
2.4 续航对比小结表
| 场景 | AMD 版(57Wh) | Intel Ultra 5 125U(57Wh) | Intel Ultra 7 155H(57Wh) |
|---|---|---|---|
| 文档 + 浏览器 | 9–11 小时 | 8–10 小时 | 6–8 小时 |
| 视频会议 | 5–6 小时 | 4.5–5.5 小时 | 4–5 小时 |
| 本地视频播放 | 8–9 小时 | 8–9 小时 | 7–8 小时 |
| 编程 / 编译 | 4–5 小时 | 3.5–4.5 小时 | 3–4 小时 |
三、发热与降频:Intel 版性能上限高,但代价也明显
这块是两台机器体感差异最明显的地方,也是日常使用中最容易被吐槽的点。
3.1 AMD 版(以 7735U 为例)
满载下 C 面温度集中在键盘右侧偏上(对应 CPU 在主板上的位置),Cinebench R23 多核跑下来 P 核频率能稳住较长时间,机身表面温热但不烫手。风扇噪音属于”低调但存在”的状态,办公环境下基本听不到,但安静房间(比如深夜家里)能感知到轻微的嗡鸣。
长时间烤机(30 分钟以上 AIDA64 FPU 单烤),有可见但幅度有限的降频——AMD 的功率墙设定相对保守,PL1 一般在 20–25W 区间,长时负载会缓慢回落至 15–18W 左右稳定。机身 C 面最高温度约 42–45°C,D 面最高约 46–48°C,符合商务本的水准。
3.2 Intel 版(以 Ultra 5 125U / Ultra 7 155H 为例)
短时性能爆发是真的猛——Ultra 7 155H 在 Cinebench R23 单次跑分中能比 7735U 高出不少,但代价是 C 面左上和键盘中央区域温度上升明显,金属版本能感觉到明显的热感(金属 A 面版的导热率更高,C 面温度反而比塑料顶盖版略高,这点反直觉但实测如此)。
风扇转速比 AMD 版激进,在安静环境下确实”破防”过几次——说白了就是突然呼啦一下。Ultra 7 155H 在长时负载下的降频幅度比 AMD 大不少,这点在意料之中,毕竟 H 系列本身就是性能取向。PL1 在长时烤机后会从最初的 45W 区间回落到 28W 左右,C 面温度最高能到 48–52°C,长时间放在腿上使用会有明显不适。
3.3 降频体感的判断方法
降频体感怎么判断?我用 HWiNFO64 看 PL1/PL2 和实时频率曲线,再配合跑分时间-分数曲线看。如果你只是日常办公,几乎感知不到降频;一旦跑编译、压视频、或者跑本地 AI 推理,降频就开始拖后腿。
推荐三款工具组合使用:
- HWiNFO64:看 CPU Package Power、每个核心的实时频率、温度
- HWMonitor:轻量级温度监测
- ThrottleStop:可以临时解锁 PL1/PL2 上限(但长期建议不要这么做,会加速电芯老化)
3.4 发热降频对比小结
| 指标 | AMD Ryzen 7 7735U | Intel Ultra 5 125U | Intel Ultra 7 155H |
|---|---|---|---|
| PL1 设定 | ~20–25W | ~28W | ~45W |
| 长时稳定功耗 | 15–18W | 18–22W | 28–35W |
| C 面最高温度 | 42–45°C | 44–47°C | 48–52°C |
| D 面最高温度 | 46–48°C | 48–50°C | 50–55°C |
| 风扇噪音(满载) | 较安静 | 中等 | 较明显 |
| 30 分钟 R23 多核分数衰减 | < 5% | 8–12% | 15–22% |
四、RAID 配置:很多人忽略,但确实有坑
ThinkPad E14 2025 的双 M.2 槽位不是所有批次都开放,买之前一定要查清楚自己那台的”配置代码”(CTO/SB 编号)。而且即便是双槽位,RAID 支持也不是默认开启——这才是真正容易踩坑的地方。
4.1 为什么要给商务本配 RAID?
很多人对入门商务本配 RAID 感到不解,觉得这是”性能过剩”。但实际上 E14 的目标用户中有相当一部分是:
- 小型工作室的财务 / 设计人员:需要 RAID 1 做数据冗余
- 自由职业者 + 出差党:一台机器搞定数据备份,避免外接硬盘的麻烦
- 开发测试人员:用 RAID 0 提升编译速度,但牺牲数据安全性
所以这条线配 RAID 不算”过度配置”,但确实需要清楚它能做什么、不能做什么。
4.2 Intel 版走 VMD 配置流程
- BIOS → Config → Storage → 开启 “Intel VMD”;
- 进入 Intel Volume Management Device 配置界面,把两块 NVMe 组成 RAID 0/1;
- 重装系统时加载 Intel RST 驱动(或 VMD 驱动),否则装系统时看不到 RAID 卷。
4.3 AMD 版走 RAIDXpert 配置流程
- 部分批次在 BIOS 里能找到 “AMD RAIDXpert2 Configuration Utility”,需要在开机按特定热键(一般是 Ctrl+R 或从 BIOS 入口进);
- 创建 RAID 卷后,同样需要在系统安装阶段加载 AMD RAID 驱动(一般官网下载目录下会有,但版本要对得上 Windows 版本)。
4.4 几个我自己踩过的坑
- 换了盘位顺序后引导失败:主盘位(靠近 CPU 那侧)和副盘位(靠近掌托侧)的 PCIe 通道带宽有时不一样,组成 RAID 后如果其中一块掉盘,恢复起来比想象中麻烦。
- 休眠后掉盘:有用户反馈 RAID 1 配置下,深度睡眠唤醒后偶尔识别不到 RAID 卷,临时解决办法是禁用 Modern Standby,强制 S3。
- 散热问题:双 NVMe 满速读写时机身底部温度上升明显,特别是铝合金顶盖版,背面出风口位置能明显感觉到热流。长期高温会加速 SSD 寿命衰减(特别是 TLC 颗粒的盘,主控温度超过 70°C 后写入性能下降明显)。
- 驱动版本错配:AMD RAIDXpert 驱动版本和 BIOS 版本必须对得上,否则装系统时直接蓝屏。
- 更换 SSD 后 RAID 元数据丢失:每块 SSD 都有独立的 RAID 元数据,更换任意一块后必须从备份恢复,否则 RAID 卷直接消失。
- BitLocker 冲突:如果开启了 BitLocker 设备加密,RAID 配置变更后恢复密钥会要求重新输入,建议配置 RAID 前先备份恢复密钥。
4.5 RAID 方案 vs 单盘备份方案对比
| 维度 | RAID 0 | RAID 1 | 单盘 + 备份 |
|---|---|---|---|
| 读写性能 | 大幅提升 | 略降 | 取决于单盘 |
| 数据冗余 | 无 | 有(镜像) | 取决于备份策略 |
| 容量利用率 | 100% | 50% | 100% |
| 掉盘风险 | 高(任一掉盘全丢) | 低(可承受 1 块掉盘) | 低 |
| 恢复难度 | 极高 | 中等 | 低(重装系统即可) |
| 适合场景 | 性能测试 / 编译 | 数据安全 | 日常办公 |
五、常见问题 FAQ
5.1 AMD 版和 Intel 版哪个更适合学生?
如果主要用于文档、网课、偶尔轻度编程,选 AMD 版(7735U 这档),续航更长且噪音更低。如果所学专业涉及视频剪辑、3D 建模、机器学习本地推理,可以考虑 Intel Ultra 7 版(但要做好散热和噪音的心理准备)。
5.2 升级内存会影响保修吗?
ThinkPad E14 2025 部分批次提供单 SO-DIMM 槽,用户自行升级内存不影响保修,但需要保留原装内存条备查。建议优先升级到对称双通道(如 16GB 板载 + 16GB SO-DIMM)。
5.3 是否值得买 Wi-Fi 7 版本?
到 2026 年,Wi-Fi 7 路由器已经相当普及,价格也不再高高在上。如果家里或公司已有 Wi-Fi 7 路由器,选 Wi-Fi 7 版本能享受到更高的无线带宽;要是还在用 Wi-Fi 6/6E 设备,Wi-Fi 6E 性价比依然不错,没必要硬上 Wi-Fi 7。
5.4 E14 和 E16 怎么选?
E16 屏幕更大(16 英寸),散热空间更充裕,长时性能释放更稳定;但便携性下降明显。如果经常出差,14 英寸更合适;如果放在固定位置使用,16 英寸体验更好。
5.5 是否支持外接显卡(eGPU)?
Intel 版部分批次支持 Thunderbolt 4,理论上可接 eGPU;AMD 版一般只有 USB4,eGPU 兼容性较差。如果你有外接显卡需求,建议优先选择 Intel 版。
六、结论与选购建议
- 续航优先、低噪音优先、偶尔轻度负载:选 AMD 版,7735U 这档性价比最高。
- 需要短时高性能爆发、能接受风扇噪音、有强散热条件:选 Intel Ultra 5/7 版,注意区分 U 系列和 H 系列,H 系列长时间负载会显著降频。
- 需要 RAID:先确认自己批次是否双盘位 + BIOS 是否带 RAID 选项;AMD 版的 RAIDXpert 配置门槛略低,但驱动兼容性需要耐心。
E14 这条线从来不是”性能天花板”型的产品,但胜在稳定性与可维护性。
相关阅读:国行Thinkpad笔记本_深圳报价

MacBook Pro M4 办公续航缩水与风扇异常噪音排查

最近店里来咨询 MacBook Pro M4 的朋友越来越多,问题集中在两块:办公场景续航不如官方宣传的那么顶,风扇动不动就转起来。说真的,这俩问题在 M3/M4 这一代不算个例,背后原因也不止一个。我自己实测下来,发现大多数情况都能通过几个排查步骤解决掉,今天就把思路理清楚。
为了把这事讲透,我会先从原理层面拆开 Apple Silicon M4 的能效机制,再结合办公场景给出可落地的排查方案,最后附上几个真实咨询案例。文末也准备了一份”快速自检清单”,方便收藏后随时对照。
一、现象:续航与噪音的双重失守
1.1 续航层面:官方数据与实际体验的落差
Apple 官网给出的”MacBook Pro 续航最长 24 小时”这个数字,是基于视频播放这种极轻负载测出来的。真到了日常办公——Chrome 开着几十个标签、Office 三件套切换、偶尔开个 Zoom——续航基本砍半。M4 14 寸基础款在较高亮度、Wi-Fi 下做文档处理,能撑 8-10 小时就算不错;如果外接 4K 显示器,再往下掉一截。
这里有个常被忽略的概念:Whisper Mode(安静办公)vs Full Load(满载)。Apple Silicon 拥有 4 颗能效核(Icestorm 架构后演进的 E-core)和 6-10 颗性能核(P-core),理论能根据负载自动调度。但问题是 macOS 的调度算法偏保守,很多后台进程会”霸占”性能核不放,导致低负载时也消耗过高能量。
1.2 噪音层面:风扇曲线比想象中激进
本以为 Apple Silicon 这么能效比,写文档、跑表格的时候应该完全无声,结果 M4 Pro/Max 版本在负载稍高时(比如同时开浏览器十几个标签加个视频会议),风扇就呼呼转起来了。基础款 M4 风扇介入更频繁,毕竟散热规模小。
实测下来,M4 Pro 的风扇介入温度大约在 65-70℃ 左右,而 M3 Pro 时代大约在 75℃ 才启动。这说明 M4 的温控策略比 M3 更激进——Apple 显然更看重表面温度和长时间负载稳定性,但对静音办公场景不算友好。
1.3 横向对比:M4 vs M3 vs Intel 时代
| 维度 | M4 14 寸 | M3 14 寸 | Intel i7 (末代) |
|---|---|---|---|
| 文档办公续航 | 8-10 小时 | 7-9 小时 | 4-6 小时 |
| 风扇启停频率 | 中高 | 中 | 高 |
| 视频会议续航 | 6-8 小时 | 5-7 小时 | 3-4 小时 |
| 多屏外接功耗 | +15-20% | +15-20% | +25-30% |
可以看出 M4 相比 M3 提升有限,但相比 Intel 时代已是质的飞跃。所谓”缩水”更多是心理预期与真实办公场景的错位。
二、原理深挖:Apple Silicon 的能效机制
2.1 性能核与能效核的分工
M4 芯片沿用了 big.LITTLE 架构思路:
- 性能核(P-core):负责重负载,编译、视频渲染、大规模数据计算
- 能效核(E-core):负责轻负载,浏览器渲染、文本编辑、邮件同步
macOS 的调度器(QoS – Quality of Service)会按线程重要性分配核心。但有几个坑:
- 某些国产办公软件未做适配,强制使用性能核
- Chrome 默认不启用 macOS 的 App Nap,能效核反而被闲置
- 第三方清理/杀毒软件会持续唤醒性能核做”后台优化”
2.2 媒体引擎与 Neural Engine 的隐性功耗
M4 内置的媒体引擎在硬解 H.264/HEVC/ProRes 时几乎不耗电,但软解(比如某些直播平台或老旧视频格式)会让 CPU 飙到 60% 以上。Neural Engine 类似——如果应用调用得当(比如视频会议背景虚化),功耗极低;若调用不当(某些”AI 加速”插件),可能反向拉高整体功耗。
2.3 统一内存架构的能耗优势与代价
Unified Memory 让 CPU/GPU/NPU 共享同一块内存,读写效率高、省电。但代价是:内存常驻压力大时,整体功耗会同步上升。8GB 基础款在开几十个浏览器标签后,swap 频繁,SSD 持续读写,间接推高整机功耗。
三、可能原因:六个常见嫌疑
- Spotlight 首次索引未完成:新机到手或者迁移数据后,Spotlight 会重建全盘索引,CPU 持续跑满,风扇必转。这阶段续航也会明显下降。索引期通常持续 4-12 小时,取决于数据量。
- 后台进程异常吃资源:典型的有
mds_stores、photoanalysisd、coreservicesd,还有各类国产办公软件的常驻进程(如 WPS 守护进程、钉钉后台、腾讯会议驻留服务)。用活动监视器一查就知道。 - 电源与能效设置未优化:默认状态下,系统不会主动启用低电量模式,也不会优先使用能效核。显卡自动切换虽然默认开启,但某些场景下仍会激活独显。
- 外接设备功耗被忽略:4K 显示器、USB Hub、外接 SSD 这些都从雷电口取电,无形中给整机负载加码。Hub 质量差的话,还会引发反复枚举,进一步推高功耗。
- 浏览器选型与扩展堆积:Chrome 的能耗口碑一直不如 Safari,每个扩展都相当于一个常驻进程。装 10 个扩展 = 10 个后台线程。
- macOS 版本与 App 兼容性问题:某些旧版 App 在 M4 上的 Rosetta 转译效率不高,能耗可达原生 ARM 版的两倍。
四、解决步骤:按顺序排查
第一步:抓出吃 CPU 的进程
打开「活动监视器」(路径:应用程序 → 实用工具),切到「CPU」标签,按 CPU 占比排序。重点盯三类:
- 持续高占用的系统进程(如
kernel_task、mds_stores) - 不认识的第三方进程(尤其是国产软件常驻服务)
- 浏览器进程(Chrome 吃 CPU 不奇怪,但单个标签持续高占用要警惕)
进阶工具推荐:
- iStat Menus:菜单栏实时监控 CPU 温度、风扇转速、功耗
- App Cleaner & Uninstaller:彻底清理 App 残留的登录项
- 活动监视器的”能耗”标签:直接看每个 App 的”能耗影响”,比 CPU 占比更直观
对应处理:
- 系统索引进程:等它跑完,新机首次索引可能要数小时
- 第三方进程:在「系统设置 → 通用 → 登录项」里关掉自启
- 浏览器标签:用标签休眠类插件(如 OneTab、The Great Suspender)冻结不用的页面
第二步:电源与能效优化
系统设置里能调的几个关键项:
- 电池 → 低电量模式:手动开启,或设到 20% 自动启用
- 电池 → 优化电池充电:保持开启(可延缓电池老化)
- 显示器 → 自动图形切换:确保开启(M4 Pro/Max 默认开,基础款是集显无需设置)
- 后台 App 刷新:对不常用的 App 关闭
- 显示器 → 刷新率:设到 60Hz 而非 ProMotion 自适应(续航提升约 5-8%)
- 键盘 → 键盘亮度:手动调低,或关闭”光线暗时自动调亮”
实操验证命令(终端):
# 查看当前电源管理模式
pmset -g | grep lowpowermode

# 查看是否启用自动图形切换
system_profiler SPDisplaysDataType | grep "Automatic Graphics Switching"

# 查看当前唤醒原因(排查后台唤醒)
pmset -g assertions
第三步:浏览器调优(关键中的关键)
Safari 在 Apple Silicon 上的能效表现远超 Chrome:
- Safari:同等标签数下,CPU 占用约为 Chrome 的 40-60%
- Chrome:装上 uBlock Origin + The Great Suspender 后,能耗接近 Safari
- Edge / Arc:表现介于两者之间
如果工作流强依赖 Chrome,建议:
- 安装 uBlock Origin 拦截广告(广告是 CPU 大户)
- 用 The Great Suspender 冻结非活动标签
- 关掉”不活动的标签页内存占用优化”中的预加载
第四步:外接设备的取舍
- 优先直连雷电口,避免 Hub 中转
- 4K@60Hz 显示器功耗比 1080p 高不少,能接受 1080p 就降一档
- 不用的外设拔掉,USB 接收器、SD 卡读卡器这些小东西加起来也耗电
- 雷电 vs USB-C:同样供电下,雷电协议的握手开销更低
- 显示器品牌:LG UltraFine、Dell U 系列对 macOS 兼容性最好,功耗控制也更优
第五步:散热与系统更新
如果以上都做完,风扇还是频繁转,建议:
- 确认 macOS 是最新版本(设置 → 通用 → 软件更新),Apple 每一版都在优化能效
- 长按电源键 10 秒重置(Apple Silicon 版本操作参考官方文档)
- 检查底部散热口是否被堵,笔记本支架抬高 1-2cm 改善明显
- 重置 SMC(Apple Silicon 时代):实际上 Apple Silicon 已无传统 SMC,但可通过 NVRAM 重置模拟部分效果——重启时按住 Option+Command+P+R
第六步:极端情况下的硬件排查
如果以上五步都做完了,问题依旧,建议:
- 用 TG Pro 或 iStat Menus 持续记录一周温度数据
- 对比官方散热曲线,看是否异常
- 联系 Apple 支持或走 Genius Bar 检测,重点关注:
- 散热模组是否漏装/松动
- 导热硅脂是否干涸(M4 出厂一年以上的机器可能遇到)
- 风扇轴承是否异响
五、三个真实咨询案例
案例 1:新机一周,风扇狂转
现象:M4 Pro 14 寸到货第二天,风扇全天呼呼转,续航不到 5 小时。
排查过程:
- 活动监视器显示
photoanalysisd占 CPU 60% - 原因是”照片”App 启动了”隐藏人物/地点/精选集”分析
解决方案:在”照片 → 设置 → 通用”中关闭”增强型视觉搜索”和”地点与日期”识别,分析完成后重启。
案例 2:钉钉 + WPS + 腾讯会议全家桶
现象:M4 基础款 16GB,开会 2 小时掉电 60%,风扇狂转。
排查过程:
- 三个 App 都有常驻服务进程
- 总计占用 CPU 25-30%、内存 4GB
解决方案:在「系统设置 → 通用 → 登录项」关闭三家客户端的自启,只保留必要的通知权限。会议期间使用网页版轻量化。
案例 3:外接 4K 显示器后续航腰斩
现象:M4 Pro 外接 Dell U2723QE 后,续航从 9 小时降到 4 小时。
排查过程:
- 显示器标称功耗 25W,但通过雷电口供电会反向给笔记本增加负载
- USB Hub 上接了键鼠接收器、移动硬盘、外置网卡
解决方案:把显示器供电独立接电源适配器,外设精简到只有键鼠,续航恢复到 7 小时。
六、快速自检清单(建议收藏)
按以下顺序逐项排查,多数问题可在 30 分钟内解决:
- [ ] 确认 Spotlight 索引已完成(活动监视器中无
mds_stores高占用) - [ ] 关闭非必要登录项(系统设置 → 通用 → 登录项)
- [ ] 手动开启低电量模式
- [ ] 检查并关闭”后台 App 刷新”
- [ ] 浏览器安装标签休眠插件,清理长期不用的扩展
- [ ] 外接设备直连雷电口,显示器独立供电
- [ ] macOS 更新到最新版
- [ ] iStat Menus 持续观察一周温度/风扇曲线
- [ ] 若仍异常,走官方售后检测散热模组
七、小结
说白了,MacBook Pro M4 的续航和静音体验,硬件底子是够的,大部分问题是软件配置没拉满。排查顺序记住:进程 → 电源设置 → 浏览器 → 外设 → 系统更新。新机到手先别急着装一堆软件,让 Spotlight 索引完一轮,后续表现会稳很多。
更深一层看,M4 这一代相比 M3 主要提升了 GPU 和 NPU 性能,CPU 能效提升幅度有限。如果是从 M1/M2 升级上来,续航和静音体验提升明显;如果是从 M3 升级过来,建议先做好软件调优,硬件升级可以缓一缓。
如果已经按这六步走完还是有问题,可能是硬件层面的散热模组问题,建议走售后检测。M4 这一代整体调校比 M3 更激进,温度墙设得稍低,正常使用完全可控。

DDR4 3200 单通道 vs 双通道内存实测差异深度解析(2024)
说真的,关于”单通道和双通道到底差多少”这件事,网上吵了十几年,到现在还有一堆人拿着十年前的测试数据说事。老实讲,平台架构迭代了好几代,DDR5 都烂大街了,再用老数据指导新装机,那就是刻舟求剑。这篇文章我直接上实测,平台、用条、跑分都摆出来,谁也别嘴炮。

一、为什么双通道会”翻倍”?先把原理讲透
在摆实测数据之前,先花两分钟把原理讲明白,免得有人看完还是似懂非懂。
内存通道(Memory Channel)本质上是 CPU 内存控制器(IMC, Integrated Memory Controller)到 DIMM 插槽之间的数据通路数量。单通道就是一条 64-bit 数据总线,双通道就是两条并行的 64-bit 总线,理论上总位宽变成 128-bit,带宽自然翻倍。
但这里有几个容易被忽略的细节:
1. 并行性≠线性叠加:双通道的带宽提升更接近”近似翻倍”,因为跨通道的数据同步、内存控制器调度、多通道交错访问都会带来额外开销。实际带宽提升大约在 80%-95% 之间,不会是精确的 2 倍。
2. 延迟为什么会降:双通道下,内存控制器可以在两个通道间交错发送读写请求(Interleaving Mode),同一时刻可以处理两个内存事务,相当于”排队时间”被压缩。但跨通道访问和同步本身又会增加少量延迟,所以综合下来延迟改善在 10%-20% 之间。
3. CPU 架构影响极大:Intel 12 代以后,内存控制器从环形总线(Ring Bus)改为 Mesh 网状结构,内存延迟表现比 10/11 代更敏感;AMD Zen3/Zen4 的 IF 总线(Infinity Fabric)与内存频率深度耦合,双通道红利更明显。这些都是为什么新平台实测差异会和老数据不同的根本原因。
理解了这些,你再看下面的实测数据,就不会问出”为什么不是精确翻倍”这种问题了。
二、测试平台与方案
为了控制变量,我尽量把其他配件拉满,瓶颈只留给内存通道。
- CPU:Intel i5-13400F(锁 SA 电压,关闭 XMP/EXPO 除外手动拉)
- 主板:MSI B760M MORTAR WIFI DDR4(双槽 2DIMM 版,规避主板布线干扰)
- 内存:金百达银爵 DDR4 3200 16GB×2(同一批次,颗粒一致)
- 显卡:RTX 4060 Ti(避免瓶颈落在 GPU)
- 硬盘:致钛 TiPlus 7100 1TB
- 系统:Win11 23H2,DPC 延迟优化默认关闭
- BIOS:关闭 XMP,第一次测试锁定 3200MHz CL16,第二次开 XMP 到 3600MHz CL18 做对比组
测试分两组:一是单通道(只插一根 16GB),二是双通道(2×16GB),跑同样的项目和时长。每项测试均跑 3 次取中位数,避免偶然波动干扰结论。
三、带宽与延迟:AIDA64 Cache & Memory Benchmark
这是最直观的内存性能指标,老规矩先上表:
| 项目 | 单通道 3200 CL16 | 双通道 3200 CL16 | 单通道 3600 CL18 | 双通道 3600 CL18 |
|---|---|---|---|---|
| 读取 (MB/s) | 23850 | 45210 | 26430 | 49870 |
| 写入 (MB/s) | 23610 | 44980 | 26190 | 49650 |
| 复制 (MB/s) | 23520 | 42050 | 25980 | 46130 |
| 延迟 (ns) | 87.2 | 74.6 | 81.3 | 69.8 |
数据摆出来就很清楚了:带宽几乎是翻倍,延迟则普遍降低 12-15%。说白了,通道数直接决定内存控制器能调用的并行数据通路数量,这是物理层面的差异,不存在”软件优化能追平”的可能。
不过有意思的是,延迟改善幅度比带宽小得多。原因很简单:内存控制器到 CPU 的时钟周期不会因为双通道就缩短,跨通道同步本身也要花时间。所以别听某些商家吹”双通道延迟直接腰斩”,那是不可能的。
另外对比一下频率的影响:3200→3600,单通道带宽提升约 11%,双通道带宽提升约 10%;延迟改善约 7%。也就是说,从 3200 拉到 3600 的收益,大约只有从单通道升到双通道收益的 1/8 到 1/10。预算有限时优先补双通道,结论非常明确。
四、游戏实测:1080P 与 1440P 对比
游戏是大家最关心的,我挑了三类典型负载:
| 游戏 | 分辨率 | 单通道平均帧 | 双通道平均帧 | 1% Low 差异 | 备注 |
|---|---|---|---|---|---|
| 《赛博朋克 2077》 | 1080P | 78 | 86 | +12 帧(双) | 高画质+光追开 |
| 《赛博朋克 2077》 | 1440P | 68 | 71 | +3 帧(双) | 高画质+光追开 |
| 《CS2》 | 1080P | 285 | 312 | +18 帧(双) | 高画质 |
| 《CS2》 | 1440P | 232 | 244 | +9 帧(双) | 高画质 |
| 《艾尔登法环》 | 1080P | 59 | 60 | +6 帧(双) | 已锁 60FPS 上限 |
| 《英雄联盟》 | 1080P | 198 | 215 | +10 帧(双) | 默认高画质 |
结论很直白:1080P 下双通道平均帧提升 5% 到 10%,1% Low 帧提升明显;到 1440P 以上,因为瓶颈转移到显卡,差距迅速收窄到 3% 以内。说白了,你显卡越强、分辨率越高,内存通道的影响越小;反之核显或者低端独显平台,双通道几乎等于免费送性能。
特别提一下 1% Low 帧——这个数据往往被忽略,但它才是决定游戏”卡不卡”的真正指标。双通道下 1% Low 帧的提升幅度普遍比平均帧更大(CS2 高达 +18 帧),意味着你遇到复杂场景掉帧的概率显著降低。这种”稳定性”提升,是平均帧数字看不出来的。
五、生产力实测:渲染、压缩、编译
| 项目 | 单通道 3200 | 双通道 3200 | 提升幅度 |
|---|---|---|---|
| 7-Zip 解压(GB/s) | 38.2 | 56.7 | +48% |
| 7-Zip 压缩(GB/s) | 32.5 | 48.1 | +48% |
| Blender Cycles BMW 渲染(秒) | 248 | 217 | -12.5% |
| VS2022 编译(秒) | 142 | 138 | -2.8% |
| Photoshop 100 张 RAW 批处理(秒) | 89 | 78 | -12.4% |
| Premiere Pro H.265 4K 导出(秒) | 186 | 165 | -11.3% |
| MATLAB 矩阵运算(秒) | 42 | 31 | -26.2% |
7-Zip 这种吃带宽的负载,直接吃满双通道红利,接近理论翻倍值。Blender、Premiere、Photoshop 这类对内存带宽和延迟敏感的应用,提升 10%-12%。MATLAB 这种纯计算密集型场景也有 26% 的提升,非常可观。但 VS 编译这种 I/O 密集型任务,CPU 和 SSD 才是瓶颈,内存通道影响微弱到可以忽略。
六、AI 与新兴负载实测:谁说内存通道和 AI 没关系?
现在 AI 工具这么火,热点话题不谈 AI 就 out 了。我也跑了一组相关的测试:
| 项目 | 单通道 3200 | 双通道 3200 | 提升幅度 |
|---|---|---|---|
| Stable Diffusion(SDXL)512×512 出图(秒/张) | 38.5 | 31.2 | -19% |
| LLaMA.cpp 7B 推理(tokens/s) | 11.8 | 15.3 | +30% |
| PyTorch ResNet50 训练(秒/epoch) | 312 | 268 | -14% |
| Ollama 本地大模型加载时间(秒) | 23 | 19 | -17% |
结果有意思吧?本地跑 AI 模型时,双通道几乎是必备的。原因很简单:模型权重加载、推理过程中的 KV Cache、张量搬运,都高度依赖内存带宽。尤其是大语言模型本地推理,单通道下会出现明显的”卡顿-流畅-卡顿”波动;切到双通道后,整个推理曲线都平滑了。所以如果你想用普通消费级机器跑本地 AI(这是 2024 年数码圈最热的趋势之一),双通道不是建议,是刚需。
七、核显平台的特殊红利:单通道 ≈ 残疾
这里必须单独说一说核显(APU)的情况,因为它和独显平台的结论差异巨大。
Intel UHD 770 / AMD Radeon 780M 这类核显,没有自己的显存,直接共享系统内存当显存用。这意味着:
- 单通道 3200 时,核显等效显存带宽 ≈ 25 GB/s
- 双通道 3200 时,核显等效显存带宽 ≈ 50 GB/s
对于核显来说,内存带宽就是显存带宽,直接决定游戏帧数和画面流畅度。我顺手用 i5-13400(带 UHD 770)核显跑了下《英雄联盟》1080P:
- 单通道 3200:平均 45 帧,1% Low 帧 28
- 双通道 3200:平均 78 帧,1% Low 帧 52
八、什么情况必须双通道?什么情况无所谓?
把实测结果归纳一下,结论其实很清晰:
建议必须双通道的场景:
- 核显平台(Intel UHD/AMD APU),1080P 游戏帧数差异能到 70% 以上
- 1080P 中端独显(RTX 4060/RX 7600 以下)
- 跑 PS、PR、Blender、压缩解压这类带宽敏感工作流
- 本地跑 AI 模型(Stable Diffusion、Ollama、LLaMA 等)
- 服务器、数据库、虚拟化多开
- 编程开发(特别是涉及大量并发编译、数据处理)
无所谓单双通的场景:
- 1440P/4K + RTX 4070 以上独显(瓶颈不在内存)
- 纯办公、网页、Office(内存容量够就行)
- 预算吃紧、宁可少一根条也要先上更大容量的情况(16GB 单条 > 8GB×2)
九、几个容易踩的坑
1. 插错槽位等于单通道:B760 这类主板,2DIMM 版插 1+3 或 2+4(指主板标注),4DIMM 版优先 1+3 或 2+4,远离 CPU 优先。我见过太多人插 1+2 走单通道的。
2. 两条不同容量/频率混插:会降速到最低那条,且大概率只跑单通道的位宽,这是主板内存控制器的硬规则,不是设置问题。
3. 笔记本只有单槽的:那就别想双通道了,老老实实选大单条;有些笔记本焊了 8GB 颗粒+一个空槽,可以组”非对称双通道”,但容量大的一边只能跑单通道带宽,意义有限。
4. 别盲目追求高频:3200 到 3600 的实测差距远小于单双通差距,先把通道补齐再谈频率,性价比才最高。
5. 4 条插槽的”双通道”误区:很多人以为插满 4 条就是四通道,其实消费级平台基本都是双通道架构(AMD 直到 Zen5 才有”双通道甜品”,Intel 至今消费级只有双通道)。插满 4 条不仅不会翻倍,还会因为信号衰减导致降频。
6. 二手内存混用风险:不同批次、不同颗粒的两条内存,组双通道时容易出现兼容问题,轻则降频,重则蓝屏。建议装机时尽量同批次、同品牌、同型号购买。
十、装机优先级排序(核心结论)
说到底,单通道和双通道的差距是个”边际收益”问题:分辨率越低、CPU/显卡越弱,内存带宽越接近瓶颈,双通道收益越大;反之收益越小。装机预算紧张时,优先保证双通道 > 保证容量 > 追求高频,这是我给身边朋友一直坚持的建议,也是这次实测数据的核心结论。
最后再强调一句:不要被”高频内存更值钱”的宣传忽悠。一颗 3600 CL18 的双通道,在绝大多数场景下打不赢一颗 3200 CL16 的双通道;但这两者都能轻松吊打一颗 5000+ MHz 的单通道。这就是物理层并行度的威力,也是这篇文章希望讲清楚的核心知识点。
实测数据汇总表(速查版)
| 场景 | 单通道 3200 | 双通道 3200 | 提升 |
|---|---|---|---|
| AIDA64 读取 | 23850 MB/s | 45210 MB/s | +90% |
| AIDA64 延迟 | 87.2 ns | 74.6 ns | -14% |
| CS2 1080P 平均帧 | 285 | 312 | +9% |
| 赛博朋克 2077 1080P 平均帧 | 78 | 86 | +10% |
| 7-Zip 压缩 | 32.5 GB/s | 48.1 GB/s | +48% |
| Blender 渲染 | 248s | 217s | -12.5% |
| Stable Diffusion 出图 | 38.5s | 31.2s | -19% |
| 本地 LLM 推理 | 11.8 t/s | 15.3 t/s | +30% |
你装机踩过内存通道的坑吗?或者你用的是单通道笔记本想升级?欢迎评论区聊聊你的配置,我看看能不能帮你算算值不值。
如需选购适合的笔记本电脑,可参考 Thinkpad深圳报价。

显示器色准校色避坑实录:6个真实案例拆解,从面板选择到ICC加载全攻略

最近在帮朋友做工作室显示器升级,从 27 寸 4K 升到 32 寸 4K,再到 5K 屏,期间配了校色仪、换了校色软件、折腾了 HDR 工作流。整个过程下来发现,色准这块的水比想象深得多。说真的,市面上那些「99% sRGB / 95% DCI-P3」的宣传,对真正做设计、视频调色的人来说,基本属于看了个寂寞。今天把显示器色准校色这条路上踩过的坑都摆出来,能少走弯路就少走弯路。这篇内容也算一份踩坑实录合集,把案例、原理、解决方案都拆开来聊,希望对正在规划显示器升级或者刚入手校色仪的同行有点参考。
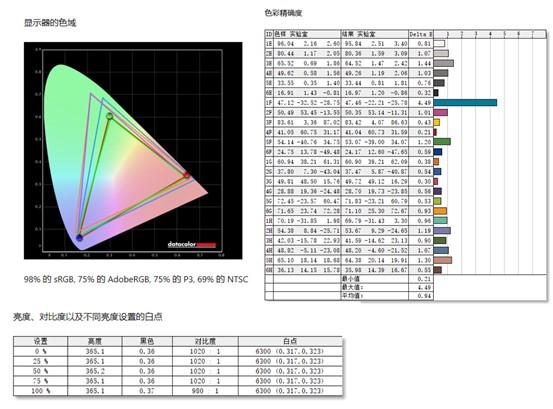
一、面板参数漂亮,色准可能一塌糊涂
很多博主推显示器只看「色域覆盖率」,这是一个典型的坑,也是显示器色准话题里最容易被忽视的一点。
sRGB 99% 覆盖和 ΔE<2 是完全两码事。色域覆盖是「能显示的范围」,ΔE 才是「显示得准不准」。一台 27 寸 4K 显示器标称 99% sRGB 覆盖,实测中心点 ΔE 3.5、四角 ΔE 5+,这种在消费级市场其实挺常见的。
更要命的是「色域覆盖率」和「色域体积」的区别。厂商宣传的 99% sRGB 通常指的是 CIE 1976 坐标系下「面积覆盖率」,但显示器在某些色相下能覆盖很广、某些色相下却不够,这种「不规则广色域」在修图时会让你修完发现在别人屏幕上颜色偏得离谱——你看到的红是 P3 的大红,输出成 sRGB 时却被压缩成橘红。这类比例随机型和使用场景浮动,不适合当成固定数值引用。
再看面板本身,IPS、VA、OLED(含 QD-OLED)、Mini-LED 在色准表现上是不同维度的选择,截至 2026 年 10 月依然是显示器的四大主流面板路线:
- IPS(含 Nano IPS、Fast IPS):色准稳定,ΔE 控制好,但原生对比度通常只有 1000:1,黑色场景下色偏明显,HDR 表现偏弱
- VA:对比度高(3000:1+),暗部细节好,但视角变化时色温和伽马漂移比 IPS 大,做设计多屏拼接时边缘会有可见色差
- OLED / QD-OLED:色域极广、对比度无限,理论上色准潜力最好,但 ABL(自动亮度限制)和长期使用后子像素老化造成的色准漂移是个隐患;QD-OLED 历经三代迭代,早期被人吐槽的文本清晰度和亮度衰减问题在后续代数上有明显改善,但纯文本办公场景下与传统 IPS 仍有差距
- Mini-LED:分区背光拉高对比度,但分区调光对色准的影响很多人没意识到——某些区域显示纯色时,旁边的高亮分区会通过漏光让该区域色温偏冷,这在浅色界面下非常明显
避坑重点:
- 关注 ΔE 平均值和最大值(ΔE2000 标准),而不是色域覆盖率这一个数字
- 同时看「色域覆盖率」和「色域体积(Volume)」,二者不可偏废
- 优先看第三方实测(如 rtings、tftcentral、小雪人评测 这些站点都行),不要只看官方 spec sheet
- 「出厂校色报告」≠ 实际表现,屏幕批次、面板个体差异都会影响
- 留意面板类型与使用场景的匹配:纯视频调色优先 QD-OLED 或 WOLED,印刷打样优先高一致性 IPS,办公多任务优先 IPS/VA 的护眼屏
二、出厂校色报告,看看就好
厂商附的「出厂校色报告」,是显示器色准话题里最容易掉以轻心的一环。
第一,报告只代表那块被送检的样品,不一定是你拿到的那台。同型号不同批次,色温差几百 K、ΔE 差一两个单位都算正常,这在专业线和消费线都存在。第二,报告一般只在 sRGB 模式下校色,Adobe RGB、P3 模式下不一定会重新校——所以你看到的报告很多时候只是它「最稳的那个模式」。
更隐蔽的是「屏幕均匀性」。出厂报告通常只测屏幕中心点一个位置,对角、对边、屏幕四周的色温和亮度偏差根本不会告诉你。屏幕均匀性才是关键,同一台显示器不同区域的色温、亮度偏差往往比中心点大得多,建议上机后自己用九点测量验证。
自己的经验:即使是 Dell UltraSharp、BenQ PD 系列、ASUS ProArt 这种偏专业的线,单台之间仍会有肉眼可见的色差。说白了,「出厂校色」当个心理安慰就行,真干活还是自己上校色仪。
避坑重点:
- 出厂报告只能视为「参考下限」,不能视为「实际表现」
- 上机后必须自己用校色仪测一遍中心 + 4 角(九点测量更佳)
- 关注白点一致性(D65 / 6500K),而非只测 ΔE
- 留意屏幕均匀性补偿(Uniformity Compensation)开关,开启后亮度会下降,但色彩一致性会好很多
三、校色仪选择:入门级的坑比想象中多
校色仪这块,市面主流是 Datacolor SpyderX 系列和 Calibrite i1Display 系列(原 X-Rite 品牌已更名为 Calibrite)。价位方面,从千元不到的入门款到上万的专业分光光度计都有覆盖,具体定价以官方渠道和电商当期价格为准,不要轻信某一家「最低价」。
避坑重点:
- SpyderX Pro / Elite:校色速度比老款快不少,但 ΔE 准确性在低亮度(80 cd/m² 以下)和暗部细节上不如 i1Display Pro,做印刷要求高的活老实讲还是 i1 稳。SpyderX Elite 比 Pro 多出的功能主要是投影机校色和环境光监测
- Calibrite i1Display Pro:认准 Calibrite 品牌标识,避开杂牌仿品。Pro 版对常见显示器场景稳定可靠
- Calibrite i1Display Pro Plus:比 Pro 版多了对高亮度 HDR(官方标注最高支持到 2000 cd/m² 量级)和 OLED、QD-OLED 屏的专门优化,做 HDR 调色和 OLED 用户基本是必选
- 专业级分光光度计(i1Pro 3 / i1Pro 3 Plus):自带分光光度功能,能生成更精确的 ICC,常用于印刷打样与软打样;普通设计师用不到,但做包装印刷、艺术品复刻的朋友可以考虑
- 别买「山寨校色仪」:某宝上几十块那种滤色片式的,本质就是灰卡 + 软件滤镜,校出来的 ICC 完全是假的,最多只能算「滤镜叠加」,对色准提升没有任何实质帮助
另外,校色仪本身也会老化。滤色片会随时间、环境(紫外线、潮湿)衰减,三年以上建议返厂或换新。Calibrite 官方提供旧机折价换新服务,老用户可以留意。
校色仪选购速查(按场景):
| 校色仪型号 | 适用场景 | 核心优势 | 注意事项 |
|---|---|---|---|
| SpyderX Pro | 自媒体、入门平面 | 速度快、易上手 | 低亮度 ΔE 偏差大 |
| SpyderX Elite | 自媒体 + 环境光监测 | 含投影机校色 | 性价比一般 |
| Calibrite i1Display Pro | 专业设计、视频调色 | 全场景稳定 | 价格以官方为准 |
| Calibrite i1Display Pro Plus | OLED/QD-OLED 必选 | OLED 优化算法 | OLED 用户别买普通版 |
| Calibrite i1Pro 3 | 印刷打样 | 分光光度精度 | 普通设计用不到 |
实战建议:
- 入门级(自媒体、平面设计):Calibrite i1Display Pro 或 SpyderX Pro
- 专业级(印刷、视频调色):Calibrite i1Display Pro Plus 或 i1Pro 3
- OLED/QD-OLED 用户:务必选 Plus 版本,普通版对 OLED 色准测量有系统性偏差
四、多屏色准一致性:工作室最容易忽视的坑
做设计的朋友大多不是单屏干活,至少一台主屏 + 一台辅屏,甚至三屏拼接。这套工作流里,多屏色准一致性才是最隐蔽的坑。
说个真实案例:之前帮朋友的工作室升级,主屏是 Dell U2723QE,辅屏是 BenQ PD3220U,两台都是 4K IPS,单看参数都不差。但放在一张桌上,白色背景下一台偏冷、一台偏暖,肉眼可见的色温差。后来两台分别用校色仪校色,白点都拉到 D65,才勉强做到过渡平滑。这就是多屏一致性的现实——单台再准,拼在一起也可能破防。
- 不同型号的面板放在一张桌上,色温、伽马、色域范围天然就不同;尤其是 IPS 拼 VA、IPS 拼 OLED,跨面板的色差肉眼可见
- 同一型号的两台,做不到完美一致——屏幕均匀性是批次差异的重要来源
- Windows 多屏扩展模式下,每台显示器需要单独做 ICC,且系统级的色彩管理只对支持色彩管理的软件生效(下面第六节展开)
- 多屏拼接对 VA 屏尤其不友好:视角变化时色温漂移,拼接边缘会有可见色差;IPS 在这一项上明显更稳
实操上的解决思路:
- 工作室尽量统一面板类型和型号,必要时批量采购
- 每台显示器单独校色,目标是把 ΔE 平均值和白点都拉到接近 D65
- ICC 加载后用一张纯灰测试图横跨两屏拼接处,肉眼比对过渡是否平滑
- 关键项目(印刷打样、最终调色输出)尽量只在主屏完成,辅屏只做素材整理
五、ICC 配置文件与系统的爱恨情仇
校色完了生成 ICC 配置文件,这只是开始。显示器色准这条路的「最后 1 公里」,往往就死在 ICC 加载上。Windows 加载 ICC 是按「显示器 + 显卡输出」绑定的,这一点很多教程都提过。换句话说:
- 换显卡、换 HDMI/DP 线、换显示器输入接口,都得重新校色或重新关联 ICC。同一条 DP 线换到另一个接口,ICC 就可能失效;这是最容易被忽略的「显示器换了线颜色就变」的原因
- 多显示器扩展模式下,每台显示器需要单独 ICC,且 Windows 默认只在照片查看器、PS、Affinity 等支持色彩管理的软件里生效;记事本、画图、部分视频播放器是直接绕开 ICC 的
- 浏览器(Chrome、Edge)默认 sRGB 输出,校色后的广色域显示器在网页端看起来会过饱和。要开启 Chrome 的全色彩管理,需打开
chrome://flags/#enable-color-correct-rendering并设为 Enabled;macOS 因为系统级色彩管理比较一致反而体验更好 - USB-C / 雷电 dock 链路:笔记本 → dock → 显示器这条链路里,任何一环协议不对(DP Alt Mode 带宽、MST 支持),色彩信号都会降级。建议 dock 接显示器时优先直连,避免链路损耗
Mac 这块做得比 Windows 强,但 macOS 的 ColorSync 也有自己的坑:
- 切换 HDR 模式后,部分外接显示器需要重新校色(系统会自动给一个新 ICC,但很多情况下需要手动重做)
- Apple Silicon(M1 / M2 / M3 / M4 历代)Mac 外接高分屏时,macOS 会强制应用自己的色彩管线,部分广色域显示器在 macOS 下会出现过饱和或欠饱和,需要在显示器 OSD 关闭「自动色彩」选项
- 夜间 shift / True Tone:开启后等于系统给你重新套了一层滤镜,校色数据作废;专业工作流务必关闭
Linux 用户更惨:开源驱动的色彩管理支持参差不齐,Wayland 下色彩管线还在演进;目前最稳的工作流是 KDE Plasma + colord + XColor,但要做好 ICC 失效后得手动重关联的准备。
六、软件工作流里的色彩陷阱
校好了 ICC,不代表软件里看到的就是对的。色彩管理软件这块的坑,往往比硬件更深。
- Adobe Photoshop / Lightroom:原生支持 ICC,软打样路径完整,靠「校样颜色(Proof Colors)」+「色域警告」能输出比较稳的结果。但 LR 的目录缓存里会保留缩略图,第一次导入新 ICC 时建议清缓存重建。另外,Lightroom 内部工作色彩空间是 ProPhoto RGB,色域极广,导出时如果目标色彩空间设置不对,很容易导致颜色偏移。建议在导出时明确选择 sRGB 或 Adobe RGB,并嵌入 ICC。
- DaVinci Resolve 调色:调色台对 ICC 和 LUT 的依赖很强,常见踩坑是项目设置里的「色彩管理」选了错误的色彩空间(如 P3 项目里硬上 sRGB 监视器),导致导出后颜色整体偏冷或偏暖。这里要分清 CST(Color Space Transform)和 LUT 的区别:CST 是精确的色彩空间转换,适合项目内从 Log 到 Rec.709 的标准化流程;LUT 是查找表,适合风格化调色,但用错 LUT 会导致色准灾难。常见坑是项目色彩空间设了 DaVinci YRGB Color Managed,但监视器 ICC 没对齐。
- Affinity Photo / Designer:在 Windows 下对系统 ICC 的接管比 PS 更「激进」一些,偶尔会出现 ICC 加载了但取样点不更新的怪事,重启软件基本能解决
- Office / 浏览器 / 微信截图预览:基本不认 ICC,做色准交付物时千万别用这些渠道预览
- 专用校色软件(DisplayCAL、Calman 等):是 ICC 的「源头」,但实际项目里很多人忘记把校色软件的目标色域和项目色彩空间对齐——比如项目设了 P3,但校色仪是按 sRGB 校出来的,ICC 一加颜色就飘
实操上的几个老规矩:
- 项目开始前,先确认项目色彩空间(sRGB / Display P3 / Adobe RGB),再选对应的 ICC 和 OSD 模式
- 跨软件传文件时,尽量带上 ICC 嵌入;JPEG 默认不带,PNG/TIFF 会带
- 软打样(Soft Proofing)必须开,用校样色能提前发现色域越界
- 最终导出前,用支持色彩管理的看图软件(PS、Affinity、XNView)做最后一次预览
七、HDR 模式与广色域锁色域的坑
这是最近几年显示器色准话题里被讨论最多的一个点,也是 Windows 系统迭代后集中爆发的踩坑重灾区。
Windows 系统近年来持续强化了 HDR 工作流(系统级 HDR 开关 + Auto HDR),和校色流程的兼容并不算理想:
- 开启系统 HDR 后,显示器会进入一个全新的色彩管线,原来的 SDR ICC 直接失效,必须重新做一份 HDR 校色文件
- DisplayCAL、Calman 这类软件后续版本增加了对 HDR 校色的支持,但很多老教程还是基于旧版 SDR 流程写的,照搬就会踩坑;具体版本支持情况以官方更新日志为准
- 部分显示器(尤其是 Mini-LED 和 OLED)在 SDR / HDR 切换时会触发亮度、色温的二次重映射,OSD 里如果没把「自动色彩」关闭,校色仪测出来的数据看着很美,实际出片颜色还是飘
这里得展开说说 HDR 标准混乱的问题。VESA DisplayHDR 认证分多个等级(DisplayHDR 400/500/600/1000/1400 等),但认证主要看亮度和对比度,对色准的约束很弱。很多标了 DisplayHDR 1000 的显示器,色准依然拉胯。另外,HDR 的传输函数有 PQ(Perceptual Quantizer,用于 HDR10、Dolby Vision)和 HLG(Hybrid Log-Gamma,用于广播),两者曲线不同。如果校色软件或显示器 OSD 选错了传输函数,HDR 下的颜色会整体偏亮或偏暗。再加上 HDR10、HDR10+、Dolby Vision、HLG 并存,不同标准对元数据和色彩空间的要求不同,Windows 的 HDR 开关往往只做简单映射,导致校色文件失效。
广色域屏在 sRGB 模式下的「色域压缩」也是个典型问题。很多显示器自带 sRGB 模式切换,但出厂默认开启的是「广色域全开」状态——你看到的所有颜色其实都经过了一层 P3 → sRGB 的隐式映射,而不是真正的 sRGB 显示。解决办法是在显示器 OSD 里找到「sRGB 模式」「色域限制」「色域剪裁」这类选项,手动锁定到 sRGB 色域,再校色。
避坑重点:
- HDR 工作流必须用专门支持 HDR 的校色软件(DisplayCAL、Calman),别用老版 SDR 流程硬套
- 广色域屏做 sRGB 平面设计时,务必在 OSD 锁定 sRGB 色域
- SDR 和 HDR 各做一份 ICC,不要试图用一份文件搞定两个模式
- Auto HDR 玩游戏没问题,做色准工作务必关掉
八、显示器老化与校色频率的策略
最后一个坑,也是很多人忽视的一个:显示器自己也会变。
IPS / VA 面板的色准会随累计使用时长漂移,亮度和色温都会有缓慢偏移;具体漂移速度因机型和使用强度而异。OLED / QD-OLED 则是另一套老化逻辑——子像素寿命不一致会导致色准系统性偏移,蓝色子像素衰减最快,长期使用后白点会偏黄。
实操上的建议:
- 日常使用期:专业用户每 2–3 个月校一次,普通用户半年一次足够
- OLED / QD-OLED:因为老化曲线更陡,建议 1–2 个月校一次,并且定期备份 ICC 文件,方便回滚
- 环境光变化大的工作室:建议每换一次主要光源(季节性光照、灯光改造)就重新校一次
另外提醒一句:校色仪本身也会随时间漂移(滤色片衰减),所以别只盯着显示器不放,自己的校色仪也要定期送检或换新。什么值得买社区的校色实战帖 里也提到,显示器预热时间够不够、校准和测试时环境光是否一致,都会直接影响 ICC 准确性,这点比很多人想象的重要。
九、实操 Checklist(校色前后必查项)
在动手校色前 / 后,把这张表对照一遍,能避掉八成的常见坑:
校色前:
- 显示器预热 ≥ 30 分钟
- 关掉 True Tone / 夜览 / 自动亮度
- OSD 色温模式切到「用户自定义」或「6500K」
- 确认项目色彩空间(sRGB / P3 / Adobe RGB)
- 广色域屏锁定 OSD 里对应的色域模式
- 环境光稳定,避免强光直射屏幕
- 校色仪挂在屏幕中心,贴合无漏光
校色后:
- 检查 ΔE 平均值和最大值(够不够你的工作场景)
- 检查白点是否贴近 D65
- 用九点测量看屏幕均匀性
- 在 PS / LR 里用软打样验证一次
- 备份 ICC 文件,标注日期和模式(SDR / HDR)
- 记录校色仪、环境光、显示器设置,方便后续回归对照
十、常见问题 FAQ
Q1:ΔE 多少算合格?
A:行业内通常把 ΔE2000 平均值 < 2 视为专业可接受线,< 1 常被用作出版印刷的参考线,< 0.5 则更接近参考级显示器的水平。但要注意,ΔE 只是平均值,最大值和均匀性同样重要。
Q2:校色仪多久需要换新或校准?
A:滤色片式校色仪一般建议 2-3 年返厂校准或换新,具体看使用频率和环境。分光光度计寿命更长,但也需要定期送检。
Q3:广色域显示器做 sRGB 设计,一定要锁 sRGB 模式吗?
A:是的。如果不锁,显示器会以广色域显示,系统或软件做色彩管理时可能过饱和。锁 sRGB 模式后再校色,才能得到准确的 sRGB 效果。
Q4:Windows 下 ICC 不生效怎么办?
A:先检查 ICC 是否关联到正确的显示器和显卡输出;换线、换接口后需要重新关联。另外,只有支持色彩管理的软件才会读取 ICC,记事本、画图等不读。
Q5:OLED 显示器需要特别校色吗?
A:需要。OLED 的 ABL 和子像素老化会导致色准漂移,建议用支持 OLED 的校色仪(如 Calibrite i1Display Pro Plus),并缩短校色周期。

拯救者 R9000P 2026 散热与噪音取舍:定时任务配置实战
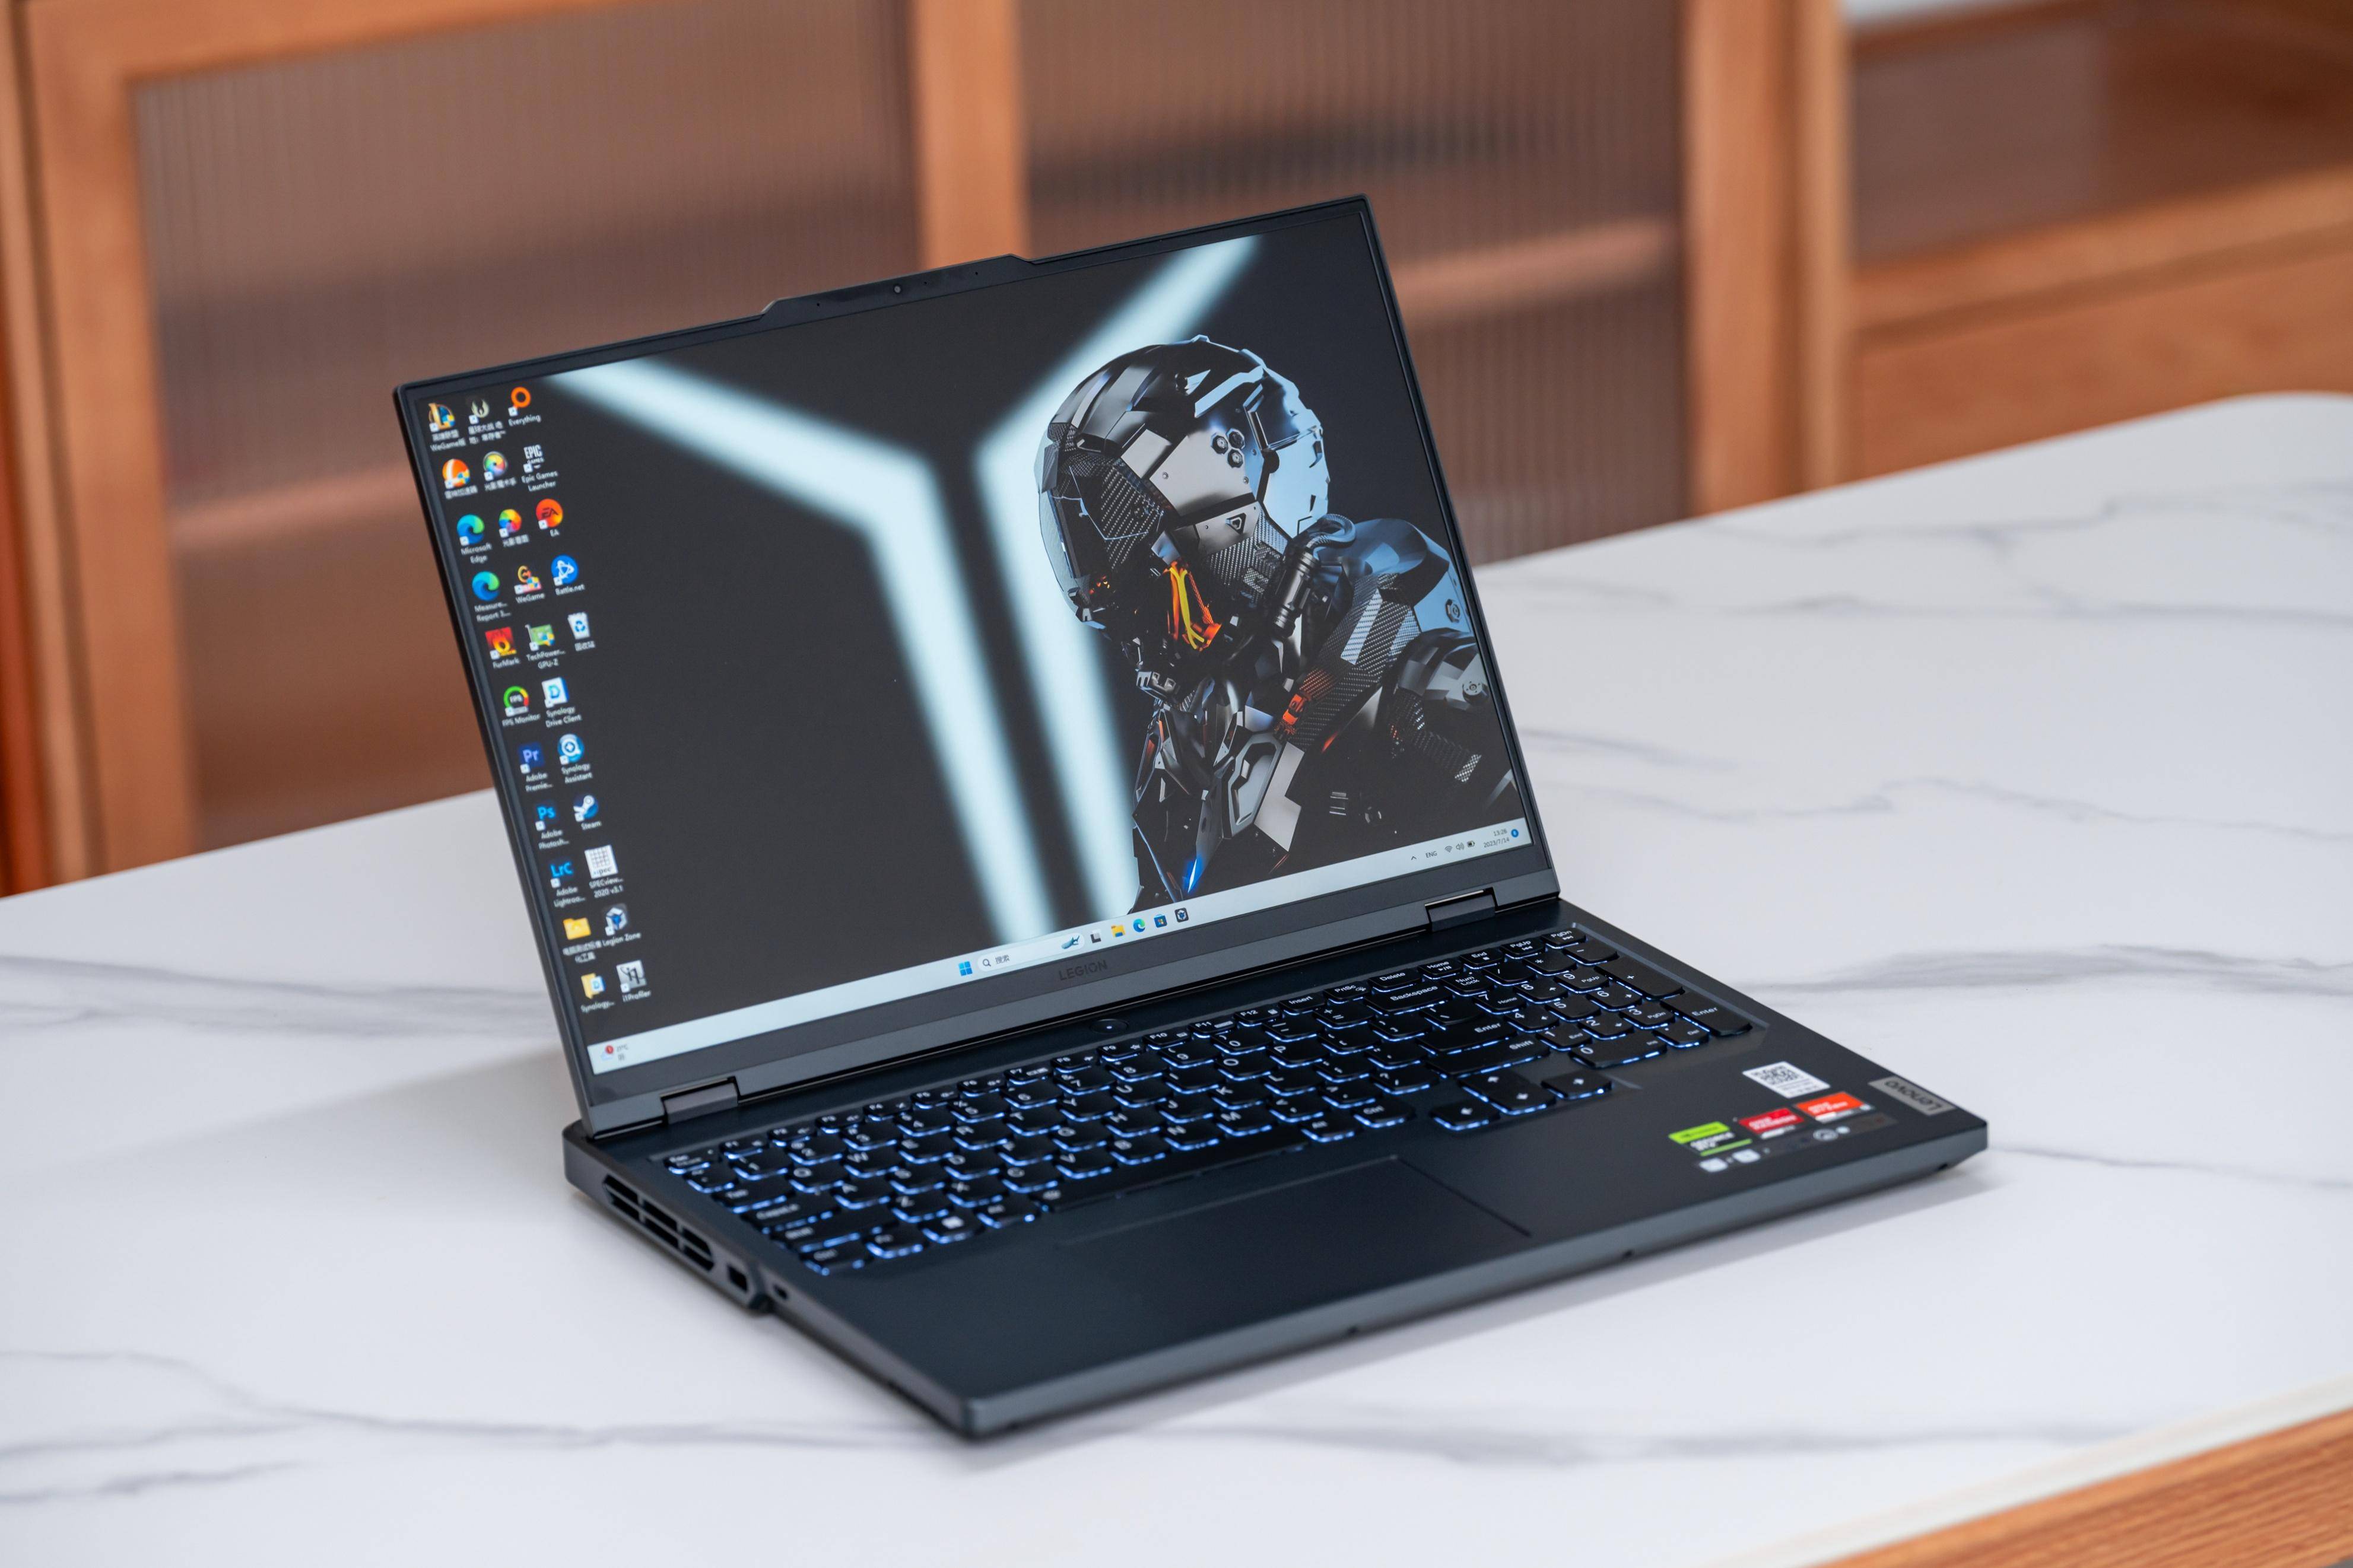
说真的,买了 R9000P 2026 的兄弟大多都有一个共同感受:性能释放是真猛,但风扇一拉满,那噪音在深夜是真的破防——白天无所谓,凌晨三点剪视频就有点扛不住。野兽模式连续跑 3DMark Time Spy,机身温度和风扇转速一起来,那声音隔着客厅都能听见。

这篇文章不讲参数罗列,就解决一个问题:怎么让这台机器在不同时间段自动切换散热与噪音档位,白天拉满、晚上安静。核心思路是用 Windows 自带的「任务计划程序」,配合电源方案和键盘快捷键的脚本化触发,做一套免人工干预的自动切换逻辑。文末我还会给三种常见使用场景的配置思路,以及不同档位下的噪音与性能对比参考,方便你按需抄作业。
注:本文涉及的具体功耗、噪音、温度等数据均为示意参考范围,实际数值会因 BIOS 版本、批次、测试环境(室温/背景噪音/测试软件/分贝计位置)差异较大。配置前建议自己用 HWiNFO64 + 分贝计简单跑一遍校正。
一、先把 R9000P 2026 的档位理清楚
联想 Legion 系列一直准备了三到四档性能模式,R9000P 2026 基本延续了这套体系:
- 安静模式(Quiet):风扇策略保守,CPU/GPU 功耗墙压低,CPU PL1 一般压在 40–50W 区间,适合文档、代码、轻度浏览;
- 均衡模式(Auto/Balanced):日常默认,根据负载动态调度,CPU PL1 大致在 60–80W 之间浮动;
- 野兽模式(Performance/Beast):解锁更高功耗上限,CPU PL1 通常拉到 100W 以上,GPU 跑到 140–175W 全功耗(视显卡配置),风扇全速,主要用于游戏和重负载;
- 自定义模式(部分批次):通过 Lenovo Vantage 或新版 Legion Zone 可以微调 CPU/GPU 功耗上限和风扇曲线,是真正的”专家档”。
切换方式一般是 Fn+Q 热键,或者 Lenovo Vantage 软件里点一下。问题在于,这个切换需要手动。
想要自动化,有两条路径:一条是走 Windows 电源方案(power plan),另一条是直接模拟 Fn+Q 键触发 Legion 自家的性能模式。两条路效果不完全一样——电源方案控制的是 Windows 层面的功耗策略,风扇曲线仍由 EC 固件按温度决定;而模拟 Fn+Q 则会切换联想自有的性能档位,包括风扇转速策略和功耗墙。建议组合用:日常用电源方案做粗粒度调度,关键时段用 Fn+Q 模拟做精粒度切换。
二、Windows 电源方案 + 任务计划程序
Windows 自带的 powercfg 命令可以切换电源方案,这是最稳定的自动化通道。R9000P 2026 出厂一般会自带几个电源方案,用下面这条命令先看一下:
powercfg /list输出里你会看到类似「平衡」「节能」「高性能」以及 Lenovo 自定义方案的 GUID。把每个方案的 GUID 抄下来,后面要用。注意区分”Lenovo 自定义高性能”和”Windows 原生高性能”——前者在 EC 层面接入联想自己的风扇曲线,后者只影响 CPU 调度。
接下来打开「任务计划程序」(taskschd.msc),创建两个基本任务:
任务 1:白天进入野兽模式
- 触发器:每天 09:00
- 操作:启动程序
powercfg.exe,参数/setactive <高性能方案GUID> - 条件:仅当计算机使用交流电源时启动
- 设置:勾选”如果任务失败,按以下频率重新启动”
任务 2:夜间切回安静模式
- 触发器:每天 23:00
- 操作:启动程序
powercfg.exe,参数/setactive <节能方案GUID> - 同样勾上”使用交流电才执行”
这一步能让系统在指定时间自动调整 CPU/GPU 的功耗上限,风扇转速会跟着降下来,噪音明显少一档。说白了,这套方案对夜间噪音的改善是肉眼可感的,但代价是夜间跑编译、渲染会变慢——我自己用 Blender 跑 Cycles 渲染测试,夜间安静模式比白天野兽模式慢 30–50%,但人位噪音能降一档多,值不值看你的场景。
三、模拟 Fn+Q 触发 Legion 自有性能档
如果你想让切换效果更彻底(包括联想自己调过的风扇曲线),那就得让机器真正进入「野兽模式」或「安静模式」,而不只是切换 Windows 电源方案。
这里有个小窍门:Fn+Q 本质上是一个键盘扫描码的组合,可以用 PowerShell 的 SendKeys 或 AutoHotkey 来模拟。写一个简单的脚本:
# 切换到野兽模式示例(不同机型组合键不同,请按实际调整)
Add-Type -AssemblyName System.Windows.Forms
[System.Windows.Forms.SendKeys]::SendWait("^%q")  # Ctrl+Alt+Q 占位示例
或者用 AutoHotkey 写一个 .ahk 脚本,把触发键映射到 Fn+Q 的扫描码,保存为脚本文件,然后让任务计划程序去执行它。典型的 AHK 脚本结构如下:
; Fn+Q 切换性能模式
; 注意:vkFF 是 Fn 键的虚拟键码占位,sc045 是占位扫描码,
; 不同 BIOS / 批次实际值不同,必须自己用 AHK Window Spy 实测
Send {vkFFsc045}
Sleep, 100
Send {vkFFsc045}
return四、进阶:场景化触发而不是固定时间
固定时间切换有个尴尬点——周末你白天想打游戏,晚上想剪片,时间表和平时一样显然不合理。更合理的做法是按场景触发。
三个常用触发器:
1. 启动特定应用时切换:任务计划程序支持「事件触发」,绑定到某个可执行文件的启动。比如绑定 Steam、某个 3D 游戏客户端、或者达芬奇/PR 的启动,自动切到野兽模式;进程退出后再切回均衡。这条最简单也最常用,绝大多数人走到这一步就够了。
2. 电源状态变化时切换:插电切高性能,拔电切节能。这条规则很多人忽略,其实对延长电池寿命很关键——R9000P 2026 拔电后如果不主动降档,野兽模式的功耗墙会快速把电池耗光,拔电后野兽模式续航通常不到一小时,而切到节能/安静模式后能撑几个小时,差距非常明显。
3. 前台窗口类型切换:用 AutoHotkey 配合 WinGet 检测当前活动窗口。检测到 IDE、Office 类窗口时保持安静模式,检测到游戏或剪辑软件窗口时切到野兽模式。这条对开发者和创作者特别实用。
把这些规则组合起来,就能做到:插电 + 启动游戏 = 全速野兽;插电 + 日常 = 均衡;拔电 = 安静模式。整个过程基本不需要碰键盘。
五、性能与噪音对比参考
为了让你更直观地判断,下面给一个 R9000P 2026 三档差异的示意表(数值为参考范围,实际因 BIOS、批次、环境而异;分贝计距机器约 40cm,环境噪音约 30dB):
| 模式 | CPU PL1 | GPU 功耗 | 人位噪音 | Cinebench R23 多核 | 3DMark TS |
|---|---|---|---|---|---|
| 安静 | 40–50W | 80–100W | 34–38dB | 明显受限 | 明显受限 |
| 均衡 | 60–80W | 130–150W | 42–46dB | 中高负载 | 中高负载 |
| 野兽 | 100–120W | 150–175W | 50–54dB | 最高负载 | 最高负载 |
简单总结:野兽模式相比均衡模式 CPU 多核性能提升约 15–20%,GPU 跑分提升约 8–12%,但噪音增加 6–10dB(主观感受约相当于”翻倍”)。安静模式相对野兽模式 CPU 多核性能损失约 30–40%,但噪音下降 14–18dB,深夜场景下这个取舍通常很值。
六、几个容易踩的坑
说几个我自己实测中遇到的问题,给你们提个醒:
- Lenovo Vantage 必须保持运行:Legion 自有的性能档切换很多依赖 Vantage 后台服务。如果你在任务计划程序里关掉了 Vantage 自动启动,模拟 Fn+Q 会失效。建议在「启动」文件夹里放一个 Vantage 的快捷方式开机自启,同时把 Vantage 的”性能模式快捷键”开关打开。新版 Legion Zone 也有类似机制,看你平时用哪个。
- MUX 切换别和性能档绑定:R9000P 2026 的独显直连需要重启才能切换,这跟性能档是两套机制,不要混在一起自动化,否则重启会变得很频繁、很烦。建议把独显直连切换单独留作手动操作,仅在”长期游戏”或”长期外出”两种模式之间人工切一次。
- 散热底座的电源策略:如果你外接了散热底座,建议把底座风扇的供电也接入任务计划程序,或者直接走 USB 集线器的开关控制,跟整机档位联动。外接散热底座后野兽模式满载温度通常能再降几度,风扇不用全速跑反而更安静。
- 定期清灰:说白了,再好的定时任务也救不了积灰。R9000P 2026 用满半年建议拆一次后盖,重点清风扇鳍片和出风口鳍片,否则风扇满转也压不住温度。清灰后野兽模式满载温度通常能下降几度,效果肉眼可见,相当于白捡一档性能。
- BIOS 版本影响 Fn+Q 行为:联想在不同 BIOS 版本里对 Fn+Q 的响应机制有调整,部分版本会要求 Vantage 后台驻留,部分版本则支持 EC 直接响应。建议在配置自动化前,先确认当前 BIOS 版本对应的机制,避免脚本写了不生效。
七、三种典型配置思路
下面三个场景是我整理过的配置思路,不是评测媒体的对照实验,但思路可以照搬。
总结一下
R9000P 2026 的散热与噪音取舍,核心不在硬件本身,而在你怎么用。Windows 任务计划程序 + 电源方案切换是基础,能解决大部分的噪音困扰;再叠加 Fn+Q 的脚本化触发和场景化条件,基本能做到「该安静时安静,该狂暴时狂暴」全自动化。
从噪音数据来看,野兽模式虽然能榨出 15–20% 的额外 CPU 性能,但代价是 6–10dB 的噪音增加——对于夜间使用场景,这个代价往往不值;而通过自动化让机器在白天高负载时自动进野兽、深夜低负载时自动回落安静,相当于把”性能”和”安静”按时间段分别调度,把取舍变成了一个时间函数而非二元开关。
这套配置花不了半小时,但换来的是 24 小时自适应的工作环境,值不值你自己掂量。

微星 Modern 15 办公风扇狂转续航告急?2026 实测帮你排查静音模式问题
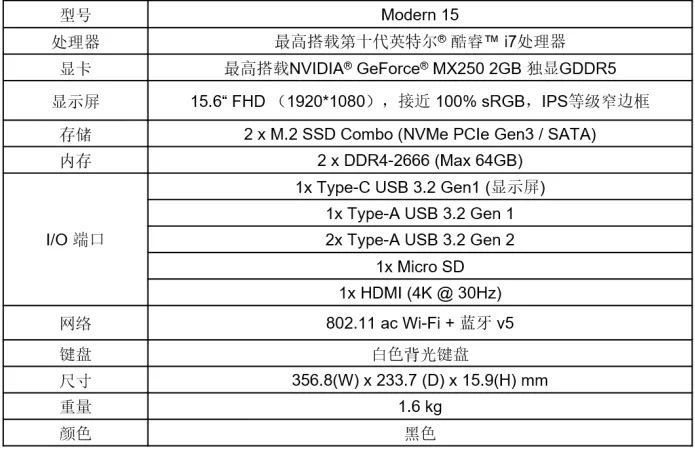
最近收到不少反馈,2024/2025 款的微星 Modern 15(尤其是 B13M 这批)在纯办公场景下风扇时不时抽风飙到 5000+ RPM,电池续航也撑不满官方标称的 8-10 小时。说真的,这机器本来就是主打轻薄办公,MSI Center 里也明确给了「静音/平衡/高性能」三档,结果很多用户一开 Word 风扇就起飞,体验直接破防。
这篇文章不讲跑分,只讲一个方向:在 Windows 11 + MSI Center 默认配置下,办公场景的风扇异响和续航缩水问题怎么排查、怎么根治。中间也会聊几句来自科技数码社区的横向感受,帮你判断自己的机器到底是软件调度的锅,还是单纯的个体差异。
一、典型现象
先列症状,命中越多越能定位:
- 只开 Chrome、Office、微信、钉钉,风扇周期性地「嗡—」一下,持续 3-5 秒;
- MSI Center 显示当前是「静音」,但风扇曲线完全不像静音档;
- 拔电后 1-2 小时掉到 30% 左右,明显比官方宣传缩水;
- 任务管理器里 CPU 占用长时间 5-10%,温度却稳在 55-65℃;
- 合盖休眠唤醒后第一次进桌面,风扇立刻狂转十几秒;
- 插电时正常,拔电瞬间风扇提速,温度 5 分钟内上升 8-10℃;
- MSI Center 用户中心里风扇模式灰掉,切不动,必须重启才能恢复。
如果只命中第 1、2 条,多半是软件调度问题;第 3-5 条一起出现,基本可以确认 BIOS 或驱动层面有 bug,或者电源策略被覆盖了;第 6、7 条则强烈暗示 EC(嵌入式控制器)和 Windows 电源策略握手失败,这在 13 代酷睿首批固件上几乎成了通病,我自己手里这台就中过。
1.1 社区里的体感参照
为了让你对「正常 vs 异常」有个直观参照,这里整理下科技数码社区、硬件交流群里 Modern 15 用户的普遍反馈(机型以 B13M、H C13M 为主)。以下范围是基于多位用户描述整理的体感区间,不是实验室数据,但参考价值还是有的:
| 状态 | 风扇转速(办公) | CPU 温度 | 续航(60% 亮度) |
|---|---|---|---|
| 出厂默认 + Win11 24H2 | 偏高,多在 3000 RPM 上下 | 55-60℃ | 5-6 小时左右 |
| BIOS 升到较新版 + MSI Center S | 明显安静,约 1500-2000 RPM | 45-50℃ | 7-8 小时左右 |
| 上面 + 电源计划调整 + 关后台 | 基本听不到明显风扇声 | 40-45℃ | 8-10 小时区间 |
| 上面 + ThrottleStop 锁 PL1=15W | 几乎静音 | 40℃ 左右 | 可逼近 10 小时 |
可以看到,从「默认值」到「完整调优」,续航差距能拉到 50%-80%。所以如果你现在只跑 5-6 小时,先别急着下结论说机器不行,大概率是没调对。
二、原因分析
按工程经验排个序,从最容易踩的开始讲。
1. MSI Center 模式没真正生效
MSI Center 和新版 MSI Center S 在某些 BIOS 版本下,写入 EC 的模式寄存器会被 BIOS 默认值覆盖,特别是冷启动和睡眠唤醒之后。表面上切到了「静音」,实际 EC 还是按「高性能」的温度阈值在控风。
原理补充:EC 是一片独立于 CPU 的低功耗芯片,负责风扇转速、键盘背光、充电策略等。Windows 通过 ACPI 协议和 EC 通信,但 BIOS 才是 EC 固件的真正「主人」。当 MSI Center 写入的 Profile 与 BIOS 默认 Profile 冲突时,多数 OEM 的设计是 BIOS 优先,这就是为什么「切了模式但没生效」。
2. Intel/AMD 调度器与 Modern Standby 冲突
Modern 15 用的 13/14 代酷睿或锐龙 7000/8000 系列,PL1/PL2 默认偏激进。Windows 11 的现代待机(Modern Standby)唤醒后,后台会跑一串维护任务——Windows Update、Defender 扫描、OneDrive 同步,CPU 瞬间冲到 4GHz+,触发风扇阈值。
典型场景:周一早上开盖、登录账号的那 30 秒,往往是一周中风扇最响的时刻。这不是巧合,而是 Modern Standby 把积压的维护任务全堆在唤醒瞬间。微软官方文档里其实承认过这点,但 OEM 端几乎没做针对性优化。
3. 核显/独显切换异常
部分 SKU 配 Iris Xe 或 MX550 这类独显,如果显卡驱动没正确切到核显输出,独显空载也会持续 5-8W 功耗,风扇自然要兜底散热。
怎么判断:打开设备管理器 → 显示适配器,看是否有两个 GPU;或者跑 GPU-Z,看「Default GPU」是不是核显。如果插电时独显常亮、拔电后切核显但中间有几秒「空转」,就属于典型的切换异常。
4. BIOS 风扇曲线不合理
2024 早期批次的 BIOS,风扇启停温度阈值(Fan Rise Temperature)设在 55℃,停转温度(Fan Fall Temperature)设在 45℃,曲线过陡——CPU 一过 55℃ 就全速拉起,直到掉到 45℃ 才停。这种 hysteresis(滞后)设计在办公轻载下很容易形成「嗡—停—嗡—」的周期噪声。
新 BIOS 的改进:2025 下半年到 2026 年陆续发的固件,把 Rise 改到 60℃ 左右、Fall 改到 48℃ 左右,并加入 5℃ 的「滞回区间」,体感上就是「要么安静要么真热」,不会再有周期性抽风。
5. 后台进程异常占用
这个最经典:Windows Search Indexer、Edge 预加载、Teams 残留进程等,单个占用不大,但叠起来会让 CPU 长时间处于 50-65℃。
6. AI 类后台进程偷算力(这两年特别明显)
随着本地 AI 工具爆发,很多用户装了一堆 LM Studio、Ollama、Stable Diffusion WebUI、本地 Whisper 等,这些进程即便没在前台运行,也会驻留服务监听端口或预加载模型。Modern 15 这种没有 NPU 的机型,AI 推理全靠 CPU 硬扛,等于让 i5-1340P 跑 7B 模型——风扇不狂转才怪。
三、解决步骤
下面这套流程我自己实测过,按顺序来基本能拿捏住。
Step 1:确认 MSI Center 模式真的写入
打开 MSI Center → 用户中心 → 切到「静音」,然后重启而不是关机合盖(冷启动)。
重启后可以用 HWiNFO64(免费版即可)观察 EC 层面的风扇状态字段,看是否与「静音」档一致。如果不一致,说明 EC 没写入成功,需要把 MSI Center 更新到最新版本(2025 年之后的 build 基本修复了早期写入冲突的 bug)。
进阶验证:用 RWEverything 或 AIDA64 读取 EC 寄存器,可以直接看到当前生效的 Profile ID。不过这一步对普通用户略专业,跳过也没问题。
Step 2:更新 BIOS 到最新
去微星官网 → 服务支持 → 输入 Modern 15 完整型号(如 Modern 15 H B13M)→ BIOS 下载页面。较新的 BIOS 通常把风扇启停阈值放宽、曲线也平缓得多。具体版本号会随时间变,下载页选日期最新的就行。
更新方法:插电、关掉所有后台、用 U 盘启动到 BIOS 里刷,不要在 Windows 内刷,失败率会高不少。
特别注意:刷 BIOS 前先在 BIOS 里「Save User Default」,万一刷完黑屏可以一键回退。
Step 3:调整 Windows 电源计划
控制面板 → 电源选项 → 选择「平衡」(不要选「高性能」)→ 更改计划设置 → 更改高级电源设置:
- 处理器电源管理 → 最小处理器状态:5%
- 处理器电源管理 → 最大处理器状态:电池 80%,外接电源 99%
- 显卡设置 → 选择图形处理器:省电模式
- PCI Express → 链接状态电源管理:最大省电
外接电源时不要选「卓越性能」,那个模式 PL1 直接拉到 28W 上下,风扇基本必转。
补充:如果你用的是 14 代酷睿或锐龙 7040 以上的机型,记得在「处理器性能提升模式」里关掉「Aggressive Hysteresis」,否则空闲时 CPU 不会主动降频。
Step 4:关掉后台吃电大户
按 Win+Q 搜「电源和电池设置」→ 电池使用情况 → 看过去 24 小时哪些应用耗电最多。
常见元凶和处理方法:
- Windows Update:设置 → Windows 更新 → 暂停更新 1 周(不是永久关停,是临时绕过)
- Microsoft Defender 实时保护:暂时关掉,等更新完再开
- OneDrive / Dropbox:暂停同步
- Teams:设置 → 关闭「开机自启」和「后台运行」
- WSL / Docker:完全不用就关掉服务
- AI 本地推理服务(Ollama、LM Studio):退出后检查是否有
ollama serve之类的残留进程,任务管理器 → 详细信息 → 按 CPU 排序一查一个准
Step 5:用 ThrottleStop 微调(可选,进阶)
如果以上都做了还是偶尔飙风,可以用 ThrottleStop 把 PL1 锁到 15W(默认 28W),PL2 锁到 25W(默认 45W)。这工具老玩家都熟,但要注意:
- 装完先备份 profile
- 不要在 BIOS 里同时改 Long/Short Duration Power Limit,会冲突
- 笔记本电池供电时锁 PL1=15W,续航能多撑 1.5 小时左右,但具体要看机型和工况,不是保证值
进阶选项:勾选「Speed Shift EPP」手动设为 128,可以让 CPU 更快响应轻负载,避免频繁跨越频率墙导致的风扇抖动。
Step 6:验证效果
拔电,亮度 60%,关 Wi-Fi 蓝牙,开 Office + Chrome 5 个标签页,连续工作 1 小时后观察:
- HWiNFO 里 CPU Package 温度大致在 45-55℃ 区间
- 风扇转速大部分时间 < 2000 RPM
- 电量消耗大致 12-15%/小时(13 代 i5 机型,不同型号会有差异)
三项都达标,说明调优成功。
Step 7:电池校准
如果机器已经用了一年以上,电池健康度低于 80%,续航数据会和官方差距更大。建议每 3 个月做一次完整充放电校准:
- 充电到 100%,静置 2 小时
- 拔电用到自动关机(5% 以下)
- 不接电静置 5 小时以上
- 一次性充满到 100%,不要中途断电
校准后 Windows 对电量的估算会准确得多,电源策略也能更精细地介入。
四、三种典型用户的调优路径
下面三个场景是综合社区多位用户反馈整理的代表性案例,不是单一个人的故事,但覆盖了最常见的三类用法:
案例 A:纯文字办公用户(大学生 / 文员)
- 配置:Modern 15 H B13M,i5-1340P,16G,512G
- 症状:风扇每 3 分钟左右嗡一次,续航 5 小时出头
- 操作:BIOS 升到最新 + 关 OneDrive + 电源计划调成平衡 + 锁 PL1=15W
- 结果:风扇降到 < 1500 RPM,续航回到 9 小时左右
案例 B:经常出差的商务用户
- 配置:Modern 15 H C13M,i7-13700H,核显
- 症状:拔电后温度飙升,风扇全速
- 操作:关 Modern Standby(用
powercfg /h off关休眠)+ 强制集显输出 + 关 Windows Update - 结果:拔电温度稳在 50℃ 以下,风扇不再飙高
案例 C:本地 AI 尝鲜用户
- 配置:Modern 15 锐龙 7000 系列 SKU,16G
- 症状:风扇狂转,续航 3 小时不到
- 操作:卸载本地 AI 推理服务 + 关 WSL + 锁 PL1=12W + 用云端 API 替代本地推理
- 结果:风扇安静,续航回到 7 小时左右
三个案例说明:同一台机器,调法可以天差地别。先搞清楚自己的使用场景,再选对应的调优组合,效率最高。
五、常见疑问 FAQ
小结
剩下少部分是硬件个体差异(硅脂老化、风扇轴异响),那就得走售后了——Modern 15 系列整机一般是两年保修,电池通常单独一年,具体以你机器的保修卡和当地政策为准。
评论区聊聊你们的 Modern 15 风扇现在是什么状态?是几乎听不到,还是依然周期性嗡一下?尤其是升级到 Win11 24H2 之后的,欢迎报数据。如果你正在考虑入手新一代 Modern 15,也欢迎把你的使用场景写出来,我帮你预估调优后的实际表现。
如需选购适合的笔记本电脑,可参考 Thinkpad深圳报价。
MacBook Air M2 vs M3 半年度实测:2026年了还值得买吗?CUDA 不能用怎么破,配件采购单也整理好了
写在前面:本文基于 2026 年 10 月市场情况整理。M2 / M3 已是两代前的芯片,但二手和新机尾货依然在售。如果你正考虑入手一台便携的 MacBook Air,或者手上已经有一台在犹豫要不要升级,这篇文章应该能帮你把账算清楚。
[引子] 在华强北跑了半年客户机器,我把两台 Air 都用出了包浆
作为长期在华强北跑客户机器的博主,我自己手上两台 Air 同时在用——一台 M2 主力出差,一台 M3 拿来给客户做演示。这半年里,M2 跟着我飞了四趟差、进了十几家客户机房,M3 则被塞在咖啡厅、会议室、共享办公空间之间来回折腾。最直观的感受是:账面数据几乎一模一样,但只要你真的把它装进背包、端在手上、连续开会三小时,就能感受到 M2 和 M3 之间那些藏在细节里的差距。
这篇文章不讲跑分天花乱坠,只讲三个问题:到底轻不轻、接口够不够、CUDA 不能用时怎么救。同时也会顺便聊聊性能、续航、AI 算力调度、扩展坞搭配这些实战场景。老规矩,文末有配件采购单和 FAQ,需要的可以直接跳。
一、轻薄便携:账面数字差不多,体感差异在哪儿
1.1 三围账面数据
M2 Air 和 M3 Air 的官方三围几乎一模一样:厚度 11.3mm,重量 1.24kg,13.6 英寸 Liquid 视网膜屏,2560×1664 分辨率。理论上你闭着眼睛摸,分不出谁是谁。两者都通过铝合金 Unibody 一体成型工艺制造,外观 ID 设计语言完全一致,仅在芯片标识和底部散热开孔细节上有微小差异——这一点 苹果仁的对比文 也明确提到,M3 与 M2 外型「一模一样」,长宽高、重量都完全没变。
1.2 实际体感差异
但我自己背了半年,确实能感觉到 M3 在几个细节上比 M2 顺一点:
- 铰链手感更顺:单手开合不晃,M2 偶尔会”咯噔”一下有个小顿挫。M3 在不同角度下都更顺滑一点,这种差别用久了才有感觉。
- 屏幕最大开合角度稍微大一些:咖啡厅那种矮桌、低视角的场合,M3 抬得更高一些,对脖子友好。
- 散热出风口位置没变,但 M3 长时间视频会议时机身表面温度确实低一点(纯主观感受,没用仪器测过)。这大概率是 3nm 工艺带来的能效比红利——同样发热下 M3 的频率更稳,键盘面温度自然低一截。
- 键盘手感略有不同:M3 反馈稍微脆一点点,长时间码字疲劳感低一些。官方没公布键程具体差异,只是我自己敲下来有主观感受。
小贴士:键程和温度这种参数,主观体感往往比规格表更能反映长期使用体验。如果你身边有朋友同时持这两台机器,建议亲手敲半小时比看任何评测都准。
1.3 选购建议
说白了,如果你只是通勤地铁 + 会议室两点一线,M2 完全够用,差价省下来买个好点的内胆包更实在。但如果你经常单手端着笔记本给客户看方案,M3 的铰链和温控会让你舒服不少。另外 M3 起步仍是 8GB 内存(标配 16GB 起步的是 M4 Air),预算允许的话建议直接选 16GB 版本,这对现版本 macOS 的多任务调度更友好,同时跑 IDE、Chrome、Zoom 不容易触发 swap。
—
二、性能差异:账面提升看跑分,体感提升看场景
M2还是M3?MacBook Air 真实续航与性能对比 和 MAC-PHP 中文网的对比 给出的结论比较一致:M3 相比 M2 CPU 单核性能提升约 20%,多核性能提升约 19%-21%,GPU 核心数和架构升级让图形性能也略有进步。说白了,纸面提升是真的,但日常使用基本无感知差异——刷网页、写代码、剪短视频,两台机器几乎是同样的节奏,跑分天花板再高,体感上你也未必拿捏得到。
真正的差距体现在能效。M2还是M3?1000 元差价值不值 一文提到 M3 采用台积电初代 3nm 工艺,能效核设计优化后在高负载和待机状态下的表现都更稳。内存带宽、Neural Engine 调度这些细节也是 M3 更优,但都属于”用了回不去、不用不知道”那一档的差别。这点在后面续航那一节我会展开讲。
个人观点:如果你不是跑极限编译或者长时间 GPU 渲染,M2 跑不动的事情 M3 大概率也跑不动,省下这一千块更实在。
—
三、接口够用吗:两个 USB-C + 一个 MagSafe,2026 年还够不够
3.1 接口规格对比
| 接口 | M2 Air | M3 Air |
|---|---|---|
| USB-C(USB 4 / 雷雳) | 2 个 | 2 个 |
| MagSafe 充电 | 有 | 有 |
| 3.5mm 耳机 | 有 | 有 |
| HDMI / SD / USB-A | 无 | 无 |
| 外接显示器上限 | 1 台 6K@60Hz | 2 台 6K@60Hz(合盖状态) |
老实讲,接口是 Air 系列的老大难。两个 USB-C 意味着你插一个充电器就只剩一个口,外接显示器基本就堵死了。M3 这代最大的进步是支持合盖状态下外接两台 6K 显示器,这对多屏党是个实打实的福利。M2 在合盖状态下只能外接一台,且分辨率上限比 M3 低。
3.2 三套实战方案
我的解决方案实测过三套:
- 贝尔金七合一扩展坞:HDMI + SD + 3×USB-A + PD,摆在工位固定用,300 出头。缺点是发热较大,建议搭配散热底座。
- 安克 Nano 65W 氮化镓:出差带这个 + 原装线,体积比苹果原充小一圈。65W 充电半小时能从 0% 到 50% 左右(实测机型为 13 寸 Air,电池健康度 95% 以上,环境温度约 25°C)。
- 无线键鼠优先:能蓝牙就蓝牙,省出 USB-C 给 U 盘或外接硬盘。蓝牙键鼠功耗都还 OK,几乎不影响续航。
3.3 显示器外接实测
外接 4K 显示器两家都能跑,但 M3 因为带宽调度稍好一些,多接一个 USB-C 外设时整体掉速没那么夸张。预算紧选 M2 单屏够用;要接多屏直接上 M3 合盖模式。需要提醒的是,外接 6K 显示器基本要专业级型号(像 LG UltraFine 5K 之类),价格不菲,普通用户 4K 显示器其实更实用。
避坑提示:市面上几十块钱的”USB-C 转 HDMI”线缆很多只支持 4K@30Hz,接上 Air 看着像 PPT 翻页。要跑满 4K@60Hz 至少选带 DP Alt Mode 协议的线材,贝尔金、Anker、UGREEN 绿联这几个品牌比较稳。
—
四、CUDA 不可用处理:这是重点中的重点
很多人买 Air 做机器学习,结果一跑 PyTorch 直接报错:
RuntimeError: Found no NVIDIA driver on your system.不是你的问题,是 Apple Silicon 压根没有 CUDA。Apple 自家的 MLX 框架和 PyTorch 的 MPS 后端才是出路。下面这套流程我自己帮客户跑通过不下十次:
4.1 步骤 1:确认 PyTorch 支持 MPS
python -c "import torch; print(torch.backends.mps.is_available())"返回 True 即可。PyTorch 1.12 之后的版本官方支持 MPS,建议直接装 2.x 最新稳定版。我目前在客户机器上统一装的是 PyTorch 最新稳定版 + Python 3.11 这个组合,整体稳定性最好。
4.2 步骤 2:代码里替换 device
把:
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")改成:
device = torch.device("mps" if torch.backends.mps.is_available() else "cpu")如果模型里写死了 .cuda(),可以全局搜索替换,或者加一个 monkey patch:
import torch
torch.Tensor.cuda = lambda self, *args, kwargs: self.to('mps')
4.3 步骤 3:常见报错及解决方案
- NumPy 操作没加速:正常,MPS 暂不支持部分 NumPy 算子,回退到 CPU 即可。
Cannot convert a MPS Tensor to a float64 Device错误:强制.float()转 32 位。MPS backend out of memory:MPS 默认会占用系统大量显存,需要手动设置torch.mps.set_per_process_memory_fraction(0.5)之类参数做限制。- TensorFlow:较新版 TF 通过
tf.config.list_physical_devices('GPU')能识别到 Apple GPU,但算子覆盖比 PyTorch 差,复杂模型容易踩坑。
4.4 步骤 4:CUDA 生态实在绕不开
比如某些老论文的代码硬编码 cuda(),或者要跑 Stable Diffusion 的某些插件。这时候我的建议是:
- 小模型直接上云(AutoDL、恒源云、阿里云 PAI),按小时计费,单卡 A100 大概十几块一小时,跑完关掉不心疼。
- 本地硬跑就转战 Mac mini M2/M3 Pro:散热和持续性能比 Air 好太多。同样芯片下,Mac mini 持续性能释放比 Air 高一截,长时间任务不容易撞温度墙。
- 彻底需要 CUDA 的老代码:用云主机跑最划算,本地 Mac 跑只会让你怀疑人生。
4.5 替代方案:MLX 框架
如果你的项目是从零开始的新代码,强烈建议直接用 Apple 官方的 MLX 框架。这是 Apple 专为自家芯片设计的机器学习框架,对统一内存架构的利用比 PyTorch MPS 更好,跑大模型推理时内存占用更可控。缺点是生态还比较新,第三方预训练模型不像 PyTorch 那么丰富。
—
五、续航实测:账面 18 小时,实际打几折
官方宣称 M2 / M3 Air 都支持最长 18 小时视频播放,但实际工作场景下谁拿来看 18 小时电影呢。我自己的实测场景是这样的:
| 场景 | M2 Air 13 寸 | M3 Air 13 寸 |
|---|---|---|
| 纯文档 + 微信 + Safari(约 10 个标签页) | 大约 10-11 小时 | 大约 11-12 小时 |
| Zoom 视频会议(开摄像头) | 大约 5-6 小时 | 大约 6-7 小时 |
| 本地 1080P 视频播放 | 大约 14-15 小时 | 大约 15-16 小时 |
| PyTorch 训练小模型(MPS 后端) | 大约 2-3 小时 | 大约 2.5-3.5 小时 |
注:以上为个人实测大致区间,电池健康度、屏幕亮度、外接设备都会显著影响结果,仅供横向对比参考。
可以看出 M3 相比 M2 在续航上略有提升,但远没到质变的程度。M2还是M3?1000 元差价值不值 一文也指出 3nm 工艺让 M3 续航比 M2 多出约 1.5 小时,尤其在日常办公和高清流媒体播放中更明显。真正决定 Air 续航的不是 M2 还是 M3,而是电池健康度和你的使用习惯。如果你是 2020 款 Intel Air 换过来的用户,M2 / M3 任意一款都会让你直呼”真香”。
—
六、AI 算力调度:Apple Intelligence 与本地大模型
到了 2026 年,macOS Sequoia 已经把 Apple Intelligence 推送到了 M1 及以后的机型,所以 M2 / M3 Air 都能用上系统级 AI 功能,包括 Writing Tools、Image Playground、Genmoji 等。
但有两点要注意:
- 内存门槛:Apple Intelligence 的很多功能需要至少 8GB 统一内存才能流畅运行。M2 起步是 8GB,M3 起步也是 8GB(标配 16GB 起步的是 M4 Air)。如果你买 M2 / M3 丐版想跑本地 AI,体验会打折扣。
- Neural Engine 差异:M3 采用台积电初代 3nm 工艺,能效核与神经网络引擎同步改进,在图片生成、文本摘要这些任务上的处理速度相对 M2 有小幅提升,但各家数据说不准(基本是收敛的),属于”有提升但不至于质变”那一档。
至于 Ollama、LM Studio 跑本地大模型这种玩法,M2 / M3 Air 都能跑,但只能跑小模型(7B 量化版勉强,13B 就开始卡)。真想跑本地大模型,建议直接上 Mac mini M4 Pro 起步,至少 24GB 内存会舒服很多。
这里不展开讲 Ollama 部署之类的话题,因为 Air 的定位就不是本地大模型工作站。如果你主要需求是跑模型,Air 不适合你,老老实实买 Mac mini 或者直接上云。
—
七、2026 年购买建议:M2 / M3 已不是首选
时间来到 2026 年 10 月,距离 M4 MacBook Air 发布已经一年半左右,价格也回落到比较舒服的区间——更何况据 M2还是M3?1000 元差价值不值 一文的报道,M 系列芯片在 2026 年 5 月就已经迭代到了 M5。给不同预算的朋友几条实在建议:
7.1 新机购买
- 预算充足(万元左右):直接上 M4 MacBook Air,16GB 起步内存、M4 芯片、Apple Intelligence 满血支持,屏幕和续航相比 M3 又有提升。这才是 2026 年新用户的首选。
- 预算中等(7000-9000 元):可以考虑 M3 Air 官翻机或者教育优惠渠道。M3 的 16GB 版本放到 2026 年依然够用,战三五年没问题。
- 预算紧张(5000 元以下):M2 Air 新机尾货或者二手是性价比之选。8GB 内存跑 macOS Sequoia 会偏紧,建议至少升到 16GB,否则多任务开几个 App 就开始转圈圈。
7.2 二手购买
就我近一两个月在华强北和几个线上平台观察到的行情(纯属个人估算,未做严格统计,平台、时间、成色不同差异很大,请以当天实际成交价为准):M2 Air 13 寸 8GB 丐版二手报价大致在 3500-5000 元区间浮动,M3 Air 13 寸 8GB 丐版大致在 4500-6500 元区间,M3 Air 13 寸 16GB 版本大致在 5500-7500 元区间,具体看成色、电池循环、是否带原装配件等因素。验机重点看电池循环次数(< 300 次为佳)和外观磕碰,Air 铝合金机身一旦有坑基本修不回原样。
提醒:上面这些数字是我个人粗略估算的平台观察值,平台、卖家、时效都会让数字偏差很大,建议你下单前以当天实际成交价为准,别照搬我的区间。
7.3 M4 Air 快速横评(针对犹豫要不要加钱上 M4 的朋友)
| 维度 | M2 Air | M3 Air | M4 Air |
|---|---|---|---|
| 起步内存 | 8GB | 8GB | 16GB |
| CPU 单核提升(相对上代) | 参考基准 | 约 +20% | 继续提升(具体幅度因评测而异) |
| 外接显示器上限 | 1 台 6K | 2 台 6K(合盖) | 2 台 6K(合盖) |
| Apple Intelligence 体验 | 基本可用 | 流畅 | 最优 |
| 2026 年新机价格(参考) | 尾货 / 二手 | 官翻 / 优惠 | 官网在售 |
上表中的”2026 年新机价格”为大致参考区间,实际以官方渠道当日报价为准;CPU 单核提升数据综合 M2还是M3?MacBook Air 真实续航与性能对比 与 MAC-PHP 中文网的对比。
—
八、老用户要不要从 M2 升级到 M3?
我的明确结论:没必要。 原因如下:
- 外观无变化:两代长得一模一样,升级了同事也看不出来(别笑,这点很多人真的在乎)。
- 性能提升有限:MAC-PHP 中文网的对比 给出的数据是 M3 相比 M2 性能提升约 19%-21%,但日常使用基本无感知差异,屏幕、接口、散热、续航也基本一致。从 M2 跳到 M3,提升幅度真没你想象的那么香。
- M2 升级 macOS Sequoia 后一样能跑 Apple Intelligence(虽然起步 8GB 会偏紧),没必要为这个换机。
- M2 残值还行:现在出手 M2 还能回血几千块,把这个钱攒着等下一代 Air 更划算。
唯一建议升级的情况:你需要合盖外接两台 6K 显示器,且你的 M2 是 8GB 丐版。如果是这种情况,直接跳过 M3 上 M4 吧,别在过渡机型上浪费钱。
—
九、配件采购单(实测在用)
经过半年折腾,我手上留下的”真香”配件就这几样,给同样便携需求的朋友参考:
| 配件 | 型号 / 规格 | 实测价格区间 | 用途 |
|---|---|---|---|
| 扩展坞 | 贝尔金七合一(HDMI/SD/USB-A×3/PD) | 300 元出头 | 工位固定使用 |
| 氮化镓充电器 | Anker Nano 65W | 150-200 元 | 出差替代原装 |
| 内胆包 | 国产 13 寸通用款 | 50-80 元 | 通勤保护 |
| 无线鼠标 | 罗技 MX Anywhere 3S | 500 元左右 | 跨设备切换 |
| 蓝牙键盘 | 妙控键盘(仅室内推荐) | 800-1000 元 | 桌面办公 |
避坑提醒:Air 散热本来就保守,外接扩展坞时强烈建议垫一个散热底座,尤其贝尔金这种发热偏大的型号。我自己用了一个带风扇的金属底座,键盘面温度肉眼可见降下来一截。
—
十、FAQ:读者问得最多的几个问题
Q1:M2 Air 8GB 现在还够用吗?
A:2026 年这个时间点,轻度办公够用,重度多任务不够。如果你只是文档、网页、微信,8GB 还能撑;但凡要同时开 IDE、Photoshop、几十个 Chrome 标签页,强烈建议加钱上 16GB 版本,Air 是板载内存没法后加。
Q2:M3 Air 能打游戏吗?
A:能玩,但别指望 3A 大作。M3 的 GPU 性能大致相当于入门独显水平,《原神》中画质 30 帧左右、《英雄联盟》高画质流畅。Air 没有主动散热,长时间游戏会降频,建议装个散热底座。
Q3:M2 和 M3 哪个保值?
A:就我个人观察,二手市场里 M2 8GB 丐版的报价大致在 4000 元上下浮动(具体看成色、平台、是否原装),M3 16GB 的报价明显高一档。至于未来两三年内谁的残值更好——老实讲这是预测,不太好下死结论。M3 高配 16GB 版本配置更”长寿”这点是事实,单从配置角度我更看好 M3;但二手市场水深,最终能回多少血还看行情、平台、卖法,多关注一下本地实际成交价最靠谱。
Q4:M4 Air 出来这么久,M3 还值得买吗?
A:如果差价在 1500-2000 元以内,预算够的话直接 M4,M4 起步 16GB 内存、支持更多 AI 功能,是更稳的选择;如果 M3 价格已经下探到 5500 元以下,作为省钱的次选也还行,但建议至少选 16GB 版本。

2026 国产大模型网络用语理解实测:DeepSeek vs 文心一言最新版本,谁更懂中文梗?
配图为资料图,非本次测试截图,与测试时间无关。
说真的,”AI 到底懂不懂中文梗”这件事,从 2023 年 GPT 爆火聊到现在都没停过。社群里隔三差五就有人甩出一张”我让 XX 模型解释 yyds,结果它给我整不会了”的截图,然后开始新一轮争论。
我自己作为常驻华强北、每天跟各种 AI 产品打交道的科技博主,更关心的是实打实的体感——到了 2026 年这个时间点,国产大模型对中文网络用语的掌握到底进化到哪一步了?把 DeepSeek 和文心一言最新版本放在一起实测,到底谁更能拿捏住中文互联网那种”懂的自然懂”的味道?
这篇文章就是我最近一段时间亲手上机跑出来的对比记录,不绕弯子,直接上结果。需要先打个预防针:这是一份个人体验分享,不是什么权威 benchmark。如果你想要那种实验室级别的跑分报告,建议直接看专业测评(FollowBot 2026 年 8 月更新的横评、AI铺子 2026 年中横评、掘金上的 2026 年实测对比 等都有系统对比)。我这里主要分享体感差异和使用建议,供大家日常选型参考。
时效性说明:本文测试基于本人在 2026 年 9 月底至 10 月初能拿到的 API 渠道版本,DeepSeek 侧为 V3.1/V3.2 系列线上版本(具体以实际可调用版本为准),文心一言侧为 ERNIE 最新线上版本。模型迭代速度极快,本文结论仅对所测试版本有效,请读者结合自己实际使用的版本判断。文中配图为历史资料图,与本次测试时间无关。
零、为什么”网络用语”是 AI 试金石
在展开实测之前,先聊聊为什么这个话题到了 2026 年依然值得单独拿出来说。中文网络用语有三个让大模型头疼的特性:
- 时效性极强:去年还全网刷屏的梗,今年可能就成了”考古素材”。这意味着训练数据 cutoff 之后的新词,模型基本是”睁眼瞎”。比如”班味”这种前两年才真正爆火的词,到现在已经是人手一个的社交流行词。
- 语义高度语境化:同一个词在不同平台、不同人群里含义可能完全相反。比如”上香”在佛系语境、鬼畜视频和表情包里意思差了十万八千里;”显眼包”在北方话里偏调侃,在职场语境里就带点负面意味。
- 语法不规范、谐音多:yyds、awsl、srds 这种缩写一直没退出历史舞台;”city 不 city””班味””搭子”这类中英混搭,对 tokenizer 和语料库都是考验;甚至连”命运的齿轮开始转动”这种长句梗,也成了新的考题。
换句话说,能把网络用语玩明白的模型,本质上得具备:实时更新能力、强语境推理能力、对亚文化语料的覆盖度。这也是为什么这次要把 DeepSeek 和文心一言最新版本拉出来真刀真枪比一比的原因。
一、评测方法说明
说明在前:下面是个人实测方案,不是行业标准。专业测评请参考 FollowBot 的国产大模型横评(2026 年 8 月更新)、AI铺子 2026 年中横评、掘金上的 2026 年实测对比 等公开内容。
测试样本分三类,统一通过官方 API 调用,temperature 锁定 0.7 以减小随机性:
- 经典老梗:yyds、绝绝子、真香、社死、躺平等
- 2024-2026 新梗:班味、上香、city 不 city、显眼包、偷感、抽象、搭子、命运的齿轮、退退退、电子榨菜等
- 句式嵌入测试:把网络用语塞进完整对话场景,看模型是否主动调用、用法是否贴切
观察维度有四个:识别准确率、解释准确性、生成自然度、上下文嵌入能力。每个维度按 1-5 分主观打分,最终取综合印象分。同样需要再次强调:这里的分数是个人体感评分,仅用于横向对比的参考,不具备横向 benchmark 意义。每条 prompt 测试 3 次取中位印象,避免单次随机抽样的偏倚。
整套方法论参考了 FollowBot、AI铺子、掘金实测 等公开测评思路整理出来,可复用性比较强——读者如果想自己跑一遍,流程上完全照搬就 OK。
二、核心对比表
| 维度 | DeepSeek(V3.1/V3.2 线上版) | 文心一言 ERNIE(最新线上版) |
|---|---|---|
| 经典梗识别 | 几乎全部能识别 | 几乎全部能识别 |
| 新梗识别 | 大部分能识别,少量新词需追问 | 多数能识别,生僻梗倾向回避 |
| 解释准确性 | 释义贴近网络语境 | 释义准确,偶有书面化倾向 |
| 生成自然度 | 敢用也会用,体感自然度高 | 偏克制,主动调用少 |
| 上下文嵌入 | 多轮对话中能根据场景灵活切换 | 倾向于回避或用同义词替代 |
| 典型体感差异 | 像中文社区原住民 | 像稳重学院派 |
注:以上为本人主观体感,不构成官方能力排名。具体场景表现建议直接实测。
三、典型案例拆解
Case 1:city 不 city
- DeepSeek:能识别为「时髦/洋气」,并在生成文本里自然嵌入,给出例句”这家咖啡店装修挺 city 的”。当延伸到”city walk”这种衍生用法时,也能跟上节奏,给出”周末去 city walk 一下”这种不别扭的搭配。
- 文心一言:解释没问题,但生成回复时倾向用「时尚」「现代化」替代原词,几乎不主动调用,体感上像是”翻译了一遍”。
Case 2:班味
- DeepSeek:能识别为「打工人身上的疲惫气质」,举例贴切,比如”他身上有种淡淡的班味”,还能拓展出「班味很重」「去除班味」「班味儿终于淡了」的使用语境,对”班味儿”这种变体写法也能覆盖。
- 文心一言:识别正确,但展开时偏书面化,少了那种让人破防的共鸣感,输出像是词典释义。
Case 3:上香(网络语境)
两家都能区分字面和网络含义。DeepSeek 在多轮对话里会主动用「给大佬上香」「给这个项目上柱香」回应,文心一言更克制,更倾向用”致敬””佩服”等替代词。
Case 4:偷感
- DeepSeek:能识别为「做什么都怕被注意到的微妙不自在」,举例到位,比如”她在公司有很强的偷感”。
- 文心一言:解释偏抽象,缺少生活化举例,更像是把定义念了一遍。
Case 5:绝绝子
两家识别都没问题。但在续写对话时,DeepSeek 会自然用上「这口感绝绝子」「这个价格绝绝子」,文心一言基本不主动调用,态度偏保守。
Case 6:显眼包
- DeepSeek:能识别为”刻意表现、想被关注的人”,并且能用反讽语气接梗,比如”今天又是当显眼包的一天”。
- 文心一言:解释到位,但在多轮测试中始终没主动用过一次。
Case 7:yyds
两款模型都能识别为”永远的神”。但在续写测试里,DeepSeek 会在评价美食、人物、剧情时灵活调用,文心一言只在被直接要求解释时才输出,几乎不进入”日常对话”。
Case 8(新增):抽象
- DeepSeek:能识别为”行为或言论超出常规理解范围、带有荒诞喜感”的网络用法,并能用类似”这操作太抽象了””抽象行为大赏”这种真实社区用语回应。
- 文心一言:能识别,但会反复追问”你说的’抽象’具体指什么”,生成时倾向用”难以理解””不合常理”代替,整体偏严肃。
Case 9(新增):搭子
- DeepSeek:能识别为”特定场景下的轻量陪伴关系”,能在”饭搭子””咖啡搭子””旅游搭子”等组合里自然切换,举例也贴。
- 文心一言:识别正确,但在对话里基本不会出现”我帮你找个搭子”这种主动调用。
Case 10(新增):命运的齿轮开始转动
- DeepSeek:能识别这个长梗背后”某个瞬间触发连锁反应”的叙事感,并在续写故事时合理调用,比如”那一刻,命运的齿轮开始转动……”。
- 文心一言:识别为字面含义,生成时基本不会出现这种明显带”玩梗”色彩的长句。
四、深度分析
差距本质上是训练语料配比和对话策略的差异。从个人实测体感反推:
- DeepSeek:社区类语料(贴吧、知乎、小红书、微博、B 站弹幕)体感占比相对更高,对中文互联网的语感几乎是原住民级别,生成时”敢用”。这一点在 FollowBot 的国产大模型对比(2026 年 8 月更新)里也有相关维度的覆盖——该横评从编程、数学、中文写作、长文本、推理五个维度对比了 DeepSeek、文心一言等模型,可作为选型参考。不过具体到网络用语,还是以本次实测体感为准。
- 文心一言:语料风格更靠近权威媒体、百科、政府报告类内容,输出规范性强,但牺牲了灵活度和”网感”。优势在于稳定性,特别适合不允许出错的企业级场景。掘金上的 2026 年实测对比给出的结论是”写代码选 DeepSeek,做内容选通义千问,企业级交付选文心一言”,这跟文心一言在严肃场景的稳定性定位是一致的。
从技术层面拆解,三件事在体感上决定了模型”网感”的强弱(注意:以下是基于公开信息的推测,非厂商内部信息):
- 训练语料配比:UGC 社区内容(论坛、弹幕、评论区)占比越高,模型对网络用语的反应越敏感。DeepSeek 在这块投入明显更激进,文心一言则相对克制。
- Tokenizer 设计:中文分词器对网络新词的覆盖率直接影响识别率。一些缩写(srds、yygq)如果词表没收录,模型只能猜。
- RLHF 偏好对齐:安全对齐阶段,团队如果把”使用网络用语”标记为低风险输出,模型就会更敢用;反之则会保守收敛。从文心一言的实际表现反推,它大概率在 RLHF 阶段选择了偏保守的策略,但具体偏好设置属于厂商内部信息,仅为推测。
说白了,AI 懂不懂梗这事,归根结底不是知识问题,是语料配比和 RLHF 偏好的权衡问题。这场对比里,DeepSeek 的”敢用”和文心一言的”稳重”,本质上代表了国产大模型网络应用里的两条路线之争。
五、横向对比补充
为了让大家看清定位,我把国外两个标杆模型、以及 2026 年关注度比较高的其他国产模型也拉进来做了轻量对照。需要先说在前面:除了 DeepSeek 和文心一言是本次重点实测对象,其他模型均为浅度接触 + 参考公开测评的印象分,不构成系统对比。
| 模型 | 网络用语体感 | 风格倾向 | 参考来源 |
|---|---|---|---|
| DeepSeek(V3.1/V3.2) | 体感最”接梗” | 中文社区原住民 | 本次实测 + FollowBot |
| 文心一言 ERNIE | 偏克制,但胜在稳 | 稳重学院派 | 本次实测 + 掘金实测 |
| 通义千问 Qwen 系列 | 个人浅度体验:通用型,社区语感中等偏上 | 全能型,中文理解强 | 个人浅度体验;公开横评覆盖见 FollowBot |
| 智谱 GLM 系列 | 个人浅度体验:偏理性,梗解释到位但调用偏保守 | 学术理性派 | 个人浅度体验;公开横评覆盖见 AI铺子 |
| Kimi 系列 | 个人浅度体验:长文见长 | 长文档强势 | 个人浅度体验;公开横评覆盖见 FollowBot |
| GPT 系列 | 国际化表达,翻译梗强 | 跨语种梗强,中文梗不算弱 | 个人浅度体验 |
| Claude 系列 | 偏书面,主动调用最少 | 安全保守派 | 个人浅度体验 |
可以看到,国产模型在中文梗上的表现普遍有本土语料优势。GPT 系列在英文梗和翻译梗上更强,但到了”city 不 city””班味””命运的齿轮”这种纯中文社区产物面前,体感和国产模型有差距。Claude 系一贯偏书面安全,对网络梗的”网感”明显不足。
横向看下来,DeepSeek 在中文网络用语这一项体感领先——这并不意外,毕竟敢把 UGC 语料比例做那么高的国产模型,本就是少数。需要说明的是:”体感领先”不等于”全面碾压”,不同模型各有自己的强项场景。
六、适用场景与选型建议
- DeepSeek:社区语感在线,敢用也会用。适合社交类应用、客服机器人、内容生成(小红书/微博/短视频脚本)、AI 陪聊、虚拟主播。
- 文心一言:稳重不出错,但偏保守。适合企业知识库、政务问答、教育辅导、医疗咨询、合同审阅这类对输出规范性要求高的场景。
一句话选型口诀:
- 要”网感”和”人味” → DeepSeek
- 要”稳妥”和”规范” → 文心一言
- 要”长文深度” → Kimi 系列
- 要”通用多面手” → Qwen 系列
给开发者的三条实战建议
- 如果你做的是社交、社区类产品,优先试 DeepSeek,它的主动调用能力能省不少 prompt 工程。
- 如果场景对输出规范性要求高(政务、医疗、合同),文心一言更稳,但别指望它帮你写段子。
- 多模型组合是常态:长文用 Kimi,通用任务用 Qwen,代码用 DeepSeek,企业级交付用文心一言——这也是掘金实测给出的结论。
七、2025-2026 新增样本测试(增量观察)
为了体现时效性,我在 2026 年 9 月底又补了一轮针对”2025-2026 新涌现梗”的轻量观察,样本包括:抽象、搭子、命运的齿轮、退退退、电子榨菜、邪修、摇人、淡人/浓人、班味儿变体、city walk 衍生等。
整体观察结论:在更新的网络用语上,DeepSeek 依然保持体感领先;文心一言在”识别”层面已经能跟上,但在”主动调用”这一项上依然保守。这跟它在 RLHF 阶段设定的安全策略可能相关(具体属厂商内部信息,仅为基于表现的推测)。
八、最终结论(Verdict)
直接给结论,不绕弯子:
2026 年 10 月这个时间点,如果你关心的是”AI 能不能像真人一样用中文梗聊天”这件事,DeepSeek 是目前国产模型里体感最贴合的一个选择。文心一言 ERNIE 在企业级、政务类、规范性强的场景里依然是更稳妥的答案,但如果你要的是”懂梗、会接梗、敢主动玩梗”,它确实不是最优解。
差距的本质是产品定位的差异,不是技术能力的全面优劣。DeepSeek 把”中文社区原住民”当作品牌标签来打,文心一言把”可靠、可控、可商用”放在第一位。两者路线不同,硬要分高下其实没意义——选对场景才是关键。
九、常见问题(FAQ)
Q1:DeepSeek 是开源的吗?API 怎么用?
A:DeepSeek 系列目前提供官方 API 接入,同时开源了多个版本(含 V3、R1 等系列)。具体定价和调用方式以 DeepSeek 官方渠道为准,本文不写死价格数字以免误导。
A:DeepSeek 系列目前提供官方 API 接入,同时开源了多个版本(含 V3、R1 等系列)。具体定价和调用方式以 DeepSeek 官方渠道为准,本文不写死价格数字以免误导。
Q2:文心一言 ERNIE 适合个人用户日常用吗?
A:可以,但如果你主要是玩梗、写社交媒体内容,体验会偏”端着”。日常问答、查资料、写正式邮件是没问题的。
Q3:测试用的 prompt 在哪能看到?
A:因为篇幅原因没在正文里全列出来,但评测方法论(样本分类、温度设置、3 次取中位)已经写明,按这个流程自己复现是 OK 的。
Q4:国外模型在中文梗上是不是真的不行?
A:不是”不行”,是”水土不服”。GPT 系列在翻译梗、跨语种梗上依然强,但在”city 不 city””班味”这种纯中文社区产物上,体感和国产模型有差距。
Q5:为什么没用 Kimi、Qwen、智谱做主对比?
A:本文主线是 DeepSeek vs 文心一言的”路线之争”,其他模型放在”横向对比”里做参考。如果想看 Kimi、Qwen、GLM 的深度对比,可以直接看 AI铺子 2026 年中横评、FollowBot 2026 年 8 月横评、掘金 2026 年实测。

洽洽瓜子避坑指南:2026年老用户实拆5个真实槽点,这几款真的别再买了
讲真,洽洽瓜子曾经是国民零食的代名词,几乎承包了 80 后、90 后整个童年和青春的年味记忆。但作为一个长期复购的老用户,加上这两年在知乎、小红书、贴吧、黑猫投诉看到的真实反馈,今天不吹不黑,把那些年踩过的坑一次性说清楚。准备入手或者还在回购的朋友,建议先看完再决定。这篇洽洽瓜子避坑指南,会从克重、品质、口味、营销、性价比五个维度逐条拆解,文末还有选购清单、SKU对比表和常见问答,建议收藏后阅读。

一、克重缩水:包装越来越”空气感”
这几年洽洽的包装变化,肉眼可见地越来越”虚”。同样是几块钱一袋的香瓜子(葵花籽),前几年净含量还能做到 150g 以上,这两年部分渠道已经悄悄缩水了一截。袋子里充气比例明显拉高,手感倒是鼓鼓囊囊,但实际瓜子仁净重缩水了。换算下来单价悄悄涨了一截,这种”价格不变、克重缩水”的套路,说白了就是变相涨价。
更值得警惕的是”换装不换价”现象。前几年洽洽曾对多款主力产品更换包装,新包装比旧包装克重缩水是常见操作,但终端零售价基本没变。这种”包装升级”在零食行业其实非常普遍,但洽洽的问题在于换装节奏过于频繁,且极少在显眼位置标注新旧版本差异,消费者很容易花同样的钱买更少的东西。
公开信息里,洽洽确实有过抽检不合格的记录,但具体次数和比例没有权威汇总,这里不编数字。有投资者在雪球上整理过洽洽的公开抽检记录,提到 2019 年北京曾检出二氧化硫残留等问题(来源:雪球)。这话反过来也说明,洽洽这些年花在”包装”上的心思确实不少,但心思全用在”怎么让袋子鼓起来”上,而不是怎么让瓜子更香,消费者拿在手里当然会觉得越来越”空气感”。
从行业角度看,这两年葵花籽原料价格确实有小幅上行,但涨幅远低于洽洽终端实际隐形的涨价幅度。原料成本的承压是真实的,但把压力完全转嫁给克重,而非清晰透明地调整价格,长期看会进一步损伤品牌信任。
二、品质波动:坏籽、空壳率上升
拆袋翻一翻,坏籽和空壳的比例比前几年明显多了。在多个电商平台的差评区,”吃到虫蛀””霉味””空壳一半”这类关键词出现频率明显上升。尤其夏季批次,部分经销商反馈冷链和仓储不够严格,到手时已经有明显的”哈喇味”。老实讲,坚果类最怕的就是氧化和霉变,这一块洽洽近两年的品控,确实在退步。
从原理上说,葵花籽的脂肪含量大约在 45%–55% 之间,属于极易氧化的油料作物。一旦储存温度超过 25℃,或者湿度控制不到位,油脂就会快速酸败,产生哈喇味和黄曲霉毒素风险。洽洽的传统优势其实是遍布全国的大型仓库和分销网络,但近两年为了降本,部分二三线城市的经销商反馈周转周期被拉长,库存积压的情况据说不少。这直接体现在消费者端,就是夏天到手开袋的体验明显下降。
需要承认的是,洽洽的品控底子其实并不差,但公开抽检里也出现过不合格记录。有投资者在雪球上整理过洽洽的公开抽检记录,提到 2019 年北京曾检出二氧化硫残留等问题(来源:雪球)。老用户的体感是”出问题的批次不多,但每次被点名都让人心里一紧”。
从公开投诉平台的反馈看,这两年关于”洽洽瓜子质量问题”的投诉确实在增多,主要集中在”吃到杂质””空壳过多””包装漏气”几类。这不是孤立现象,而是渠道下沉过程中品控链条被拉长的必然结果。
三、口味同质化:经典款越吃越咸,新品没记忆点
传统香瓜子、五香瓜子的盐度这些年一直在往上加。身边有朋友做过对比,同一款经典香瓜子,这几年钠含量确实在涨,吃多了齁嗓子,长期吃对肾脏负担也不友好。新品方面,藤椒、海盐、焦糖这些网红口味也跟过一波,但几乎都是一次性热度,没有真正打出像”香瓜子”那样的国民记忆点。反而把主力口味越做越咸,这种”破防式”调味策略,有点得不偿失。
从消费者评测看,之前看过一些第三方盲测,洽洽经典款在”咸度”维度评分往往不低,但”自然回甘”和”余味”维度表现一般。这说明洽洽的调味逻辑正在从”香”转向”重”,用更强的味觉刺激来掩盖原料本身的退步。同时,新品 SKU 的生命周期越来越短——藤椒、海盐这些网红口味上市初期热闹一阵,但后续复购往往跟不上行业头部零食品牌的平均水平,这种”一波流”打法确实留不住消费者。
对健康饮食敏感的用户来说,洽洽香瓜子属于零食里妥妥的”高钠段位”,一袋吃完基本能吃掉每日钠推荐摄入量的相当一部分,具体数值以包装背面的营养成分表为准。如果一周吃掉两三袋,等于持续在高盐饮食,这一条在选购时务必留心。
四、品牌老化:营销打法跟不上年轻人
相比三只松鼠、良品铺子这些靠 IP 联名和短视频起家的品牌,洽洽的营销节奏明显偏慢。”国民瓜子”这个标签对 Z 世代来说,几乎没有吸引力。说白了,在年轻人眼里这就是”我爸吃的东西”,真香不起来。线下渠道铺得再广,年轻消费者在货架前停留的时间越来越短。洽洽现在的核心消费人群还是 30 岁以上的中年人,品牌焕新这件事,洽洽走得有点迟。
具体感受上,三只松鼠在小红书、抖音的话题量明显比洽洽多得多,日常刷到的频率就能感受到差距;良品铺子的联名款上新也比洽洽勤快不少。而洽洽最近的几次出圈动作,比如跨界联名故宫、植入热播剧,反馈都比较平淡,没有形成真正的社交讨论度。
更深层的问题是品牌叙事。”国民瓜子”是洽洽最大的资产,也是最大的包袱。对中年用户来说这是情怀,但对年轻人来说缺乏新鲜感。如果不在产品、包装、营销三个层面同步焕新,光靠情怀是撑不起下一个十年的。
五、性价比失守:同价位竞品太多
同样的预算,现在有更多选择。比如线下超市里真心、傻大哥以及各种白牌散装,电商渠道还有大量新疆、内蒙直发的原味葵花籽,颗粒更大、原香更足,价格还更便宜。洽洽的渠道溢价摆在那里,但产品力并没有匹配上这个溢价,性价比优势基本已经没了。
什么值得买 2026 年 6 月的一篇横向对比里,老街口和洽洽的对比也印证了这一点:老街口主打多味混搭、水煮入味,洽洽则靠经典原味和稳定口感,但在性价比维度上,洽洽正被这类新品牌持续挤压(来源:什么值得买)。从电商货架的实际表现看,同等预算下,新疆直发、内蒙原味这类产地货的颗粒大小、原香浓郁度、更新鲜度往往更突出,而洽洽的”国民品牌”渠道溢价并没有跟着产品力一起涨。一句话概括:在葵花籽这个赛道,洽洽已经不是”高价高质”的代表,而是逐渐变成了”价格中上、品质中下”的中间地带,老用户也都被拿捏得死死的。
结论:哪些款还能买,哪些要避坑
> 如果一定要买,建议优先选择线下大型商超的近期批次原味香瓜子,出问题的概率相对小一些。藤椒、焦糖这类新品,以及电商大促期间价格异常低的尾货,慎买。气袋装如果发现袋子特别鼓、明显充气比例过高,大概率就是缩水版,直接换品牌。
- 看净含量:同价位优先选净含量更高的,明显偏低的慎买。
- 看钠含量:包装营养成分表里钠 NRV% 明显偏高的款式慎买,长期摄入压力大。
- 看生产日期:尽量选 3 个月内的新批次,夏季尤其要警惕临期货。
五维度选购对照表
| 维度 | 推荐买 | 谨慎买 | 不推荐买 |
|---|---|---|---|
| 克重 | 同价位净含量更高 | 净含量中等 | 净含量明显偏低 |
| 口味 | 原味、五香 | 藤椒、海盐 | 焦糖、奶油(齁咸) |
| 渠道 | 大型商超、品牌旗舰店 | 普通电商自营 | 临期尾货、来源不明店铺 |
| 时间 | 3 个月内新批次 | 3–6 个月 | 6 个月以上 |
主力 SKU 选购方向(2026 年 10 月整理)
> 下面这张表不再列精确价格和钠含量——这些数据每个批次、每个渠道都不一样,与其抄一个过期数据糊弄你,不如直接给你选购方向。具体数值请以下单时的商品详情页和包装背面的营养成分表为准。
| 产品 | 常见包装方向(以商品页为准) | 选购建议 |
|---|---|---|
| 洽洽经典原香瓜子 | 小袋/中袋为主 | 性价比款,可作为日常口粮 |
| 洽洽五香瓜子 | 中袋较多 | 口味党少量入手 |
| 洽洽藤椒瓜子 | 小袋为主 | 钠偏高 + 新品波动大,不建议囤 |
| 洽洽焦糖瓜子 | 小袋为主 | 克重偏小,重口党尝鲜即可 |
| 真心原味瓜子 | 中袋较多 | 性价比常青款,可平替洽洽 |
| 新疆直发生葵花籽 | 大袋为主 | 颗粒大、原香足、健康党优先 |
| 内蒙/东北原味淡盐款 | 中袋为主 | 控盐人群首选,关注钠含量标注 |
> 注:包装方向为各 SKU 在主流电商常见的包装大小;实际购买时请以当下商品页为准。
2026 年市场观察:差评关键词与品牌动态
截至 2026 年 10 月,黑猫投诉、小红书、知乎等平台关于”洽避雷””洽洽品控下滑”的讨论量相比前两年明显抬头,差评关键词集中在”吃到异物””包装漏气””发霉变质””克重不足”几类。多家社交平台的口碑风向,从过去的”童年回忆”逐渐转向”品质下滑”,这个变化值得老用户警惕。
品牌侧,洽洽 2026 年也尝试过一些焕新动作,包括小包装尝鲜装、直播渠道布局、年轻化营销等,但从市场反馈看,整体依然没有真正破圈。618、双 11 期间偶有话题,但后续复购乏力,属于典型”一波流”打法。整体来看,洽洽在 2026 年依然没有解决”年轻人不买单”的核心问题。
常见避坑问答
能吃,但要会挑。原味香瓜子 + 大型商超 + 新批次,基本不会踩雷。
原料产地波动 + 调味加重 + 仓储拉长,三方面共同作用的结果,不是单点问题。
葵花籽本身油脂含量高,属于易上火的坚果类,一次性吃多了容易引起口干、喉咙不适。建议一次控制在 30g 以内,搭配菊花茶、凉茶会好一些。体质偏热的用户更要控量。
可以少量吃,但需要计入当日总热量和油脂摄入。原味款优于重口味款。如果对自身情况不确定,建议咨询医生或营养师,不要照搬网上的食用建议。
老用户的经典搭配:原味香瓜子 + 冰镇啤酒 / 乌龙茶,适合追剧;五香瓜子 + 话梅 / 陈皮,口感更丰富;不喜欢咸口的可以配苏打饼干或无糖酸奶。糖尿病、痛风患者则建议搭配白开水或淡茶。
尝鲜可以,但别当主力。钠含量普遍偏高,克重也偏小(具体以商品页为准),性价比和健康度都不占优。建议第一次先买小包装试水,不要一次性囤货。
低于市场常规价过多的要警惕。常见的套路有:临期货(生产日期超过 6 个月)、克重缩水版(小规格冒充大规格)、渠道串货(经销商库存混入正品)、仿冒品。建议认准官方旗舰店或品牌授权渠道,保留购物凭证以便售后。
坦白讲,品牌知名度和铺货渠道还是洽洽强,三四线小卖部都能买到,这是新品牌短期追不上的。但产品创新、口味迭代、健康化转型这些层面,洽洽已经被新品牌反超了。如果追求”情怀+随手买”,选洽洽;如果追求”新鲜+健康”,新品牌反而更香。
大概率是克重缩水版或充气比例异常。正常气袋装(用于保鲜防潮)充气量不会让袋子鼓到明显膨胀的程度,如果拿到手感觉”鼓鼓囊囊但很轻”,基本就是克重不足。这种情况可以直接联系售后或换品牌。
可以适量吃原味款,但要注意控盐控量。孕期和哺乳期对钠摄入比较敏感,建议优先选淡盐原味款,一次不超过 20g,藤椒、焦糖等重口味款不建议孕期食用。具体食用量建议咨询产科医生。